Modelos de Raciocínio e Test-Time Compute: Escala em Inferência
Durante a primeira metade da década de 2020, o avanço da Inteligência Artificial Generativa foi guiado quase que com exclusividade pelas Scaling Laws clássicas de pré-treinamento (formalizadas inicialmente por Kaplan et al., 2020, e refinadas pela lei de Chinchilla de Hoffmann et al., 2022). A tese era direta: aumente o poder computacional gasto em clusters de treinamento ($FLOPs$), multiplique o número de parâmetros dos transformadores e alimente o modelo com trilhões de tokens de texto bruto para obter, de forma previsível e contínua, reduções no valor da função de perda (cross-entropy loss) e ganhos de inteligência geral.
No entanto, entre 2024 e 2026, a indústria de fronteira colidiu com três barreiras simultâneas:
- O Esgotamento de Dados Públicos: O volume de dados em texto limpo de alta qualidade disponível na internet atingiu um platô de saturação.
- Custo Energético e Físico de Clusters: Levantar data centers de centenas de megawatts com centenas de milhares de aceleradores gráficos tornou-se um gargalo logístico, financeiro e regulatório.
- Retornos Decrescentes no Pré-Treino: Aumentar em 10 vezes os parâmetros de um modelo denso passou a render ganhos marginais em testes complexos de matemática, engenharia de software e raciocínio multi-etapas.
Diante desse platô, uma mudança de paradigma estrutural emergiu: a introdução de uma terceira dimensão de escala, denominada Test-Time Compute (Computação em Tempo de Inferência).
Pioneirada comercialmente por modelos como OpenAI o1, o3 e democratizada por arquiteturas abertas como DeepSeek-R1, essa abordagem inverte a lógica tradicional: em vez de gastar bilhões de dólares treinando modelos gigantescos que respondem a qualquer pergunta complexa instantaneamente no primeiro token emitido, transfere-se o esforço computacional para o momento da geração da resposta, permitindo que o modelo “pense”, explore múltiplos caminhos de raciocínio, verifique premissas intermediárias e execute auto-correções internas (backtracking) antes de entregar a resposta ao usuário.
Neste guia técnico definitivo, analisamos a matemática e a teoria das novas Scaling Laws de inferência, dissecamos a taxonomia algorítmica de exploração (Amostragem Best-of-N, CoT Adaptativo e Busca em Árvore com Modelos de Recompensa de Processo - PRM), detalhamos os trade-offs críticos de engenharia e apresentamos uma implementação modular, funcional e completa em Python.
1. O Novo Paradigma de Inteligência: As Três Dimensões de Escala
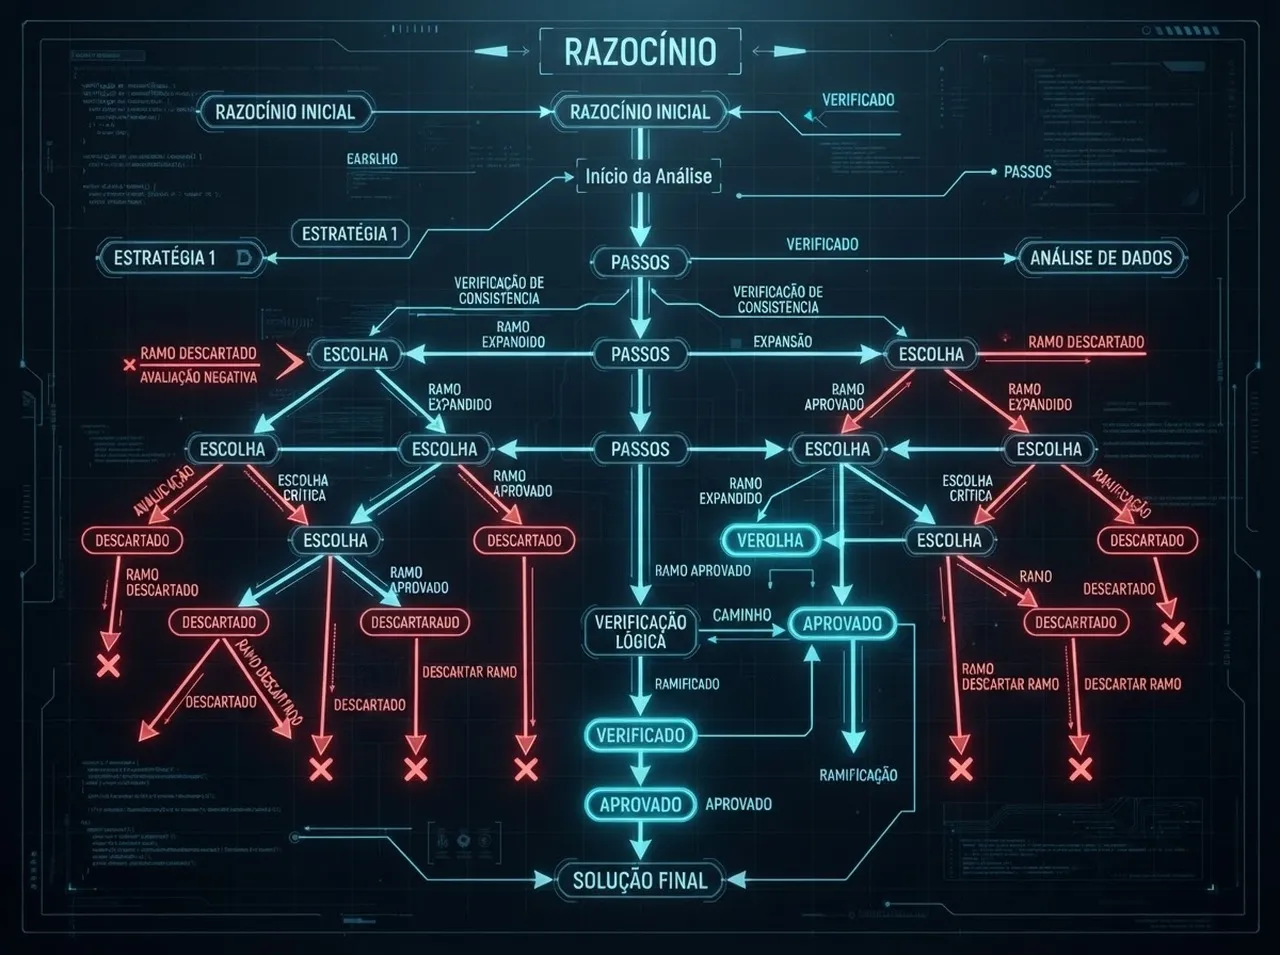
A evolução das capacidades dos Modelos de Linguagem pode ser compreendida como a transição entre três fases computacionais distintas:
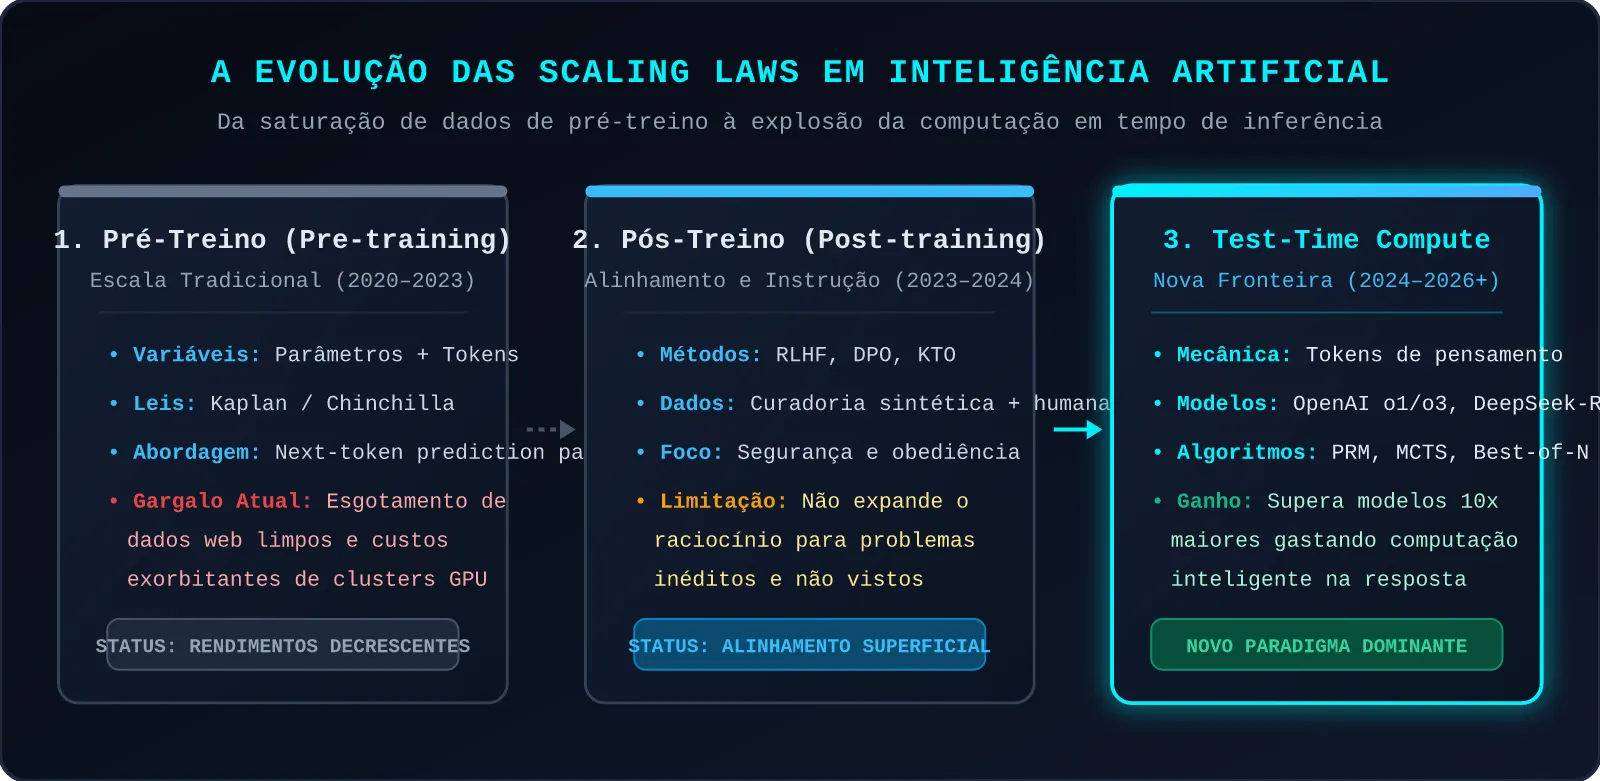
1.1. Dimensão 1: Pré-Treino (Pre-training Scaling)
No pré-treino supervisionado e auto-supervisionado tradicional, o modelo aprende uma distribuição estatística sobre a linguagem tentando prever o próximo token ($P(wt | w1, w2, …, wt-1)$).
- Essa fase constrói o conhecimento de mundo enciclopédico, a intuição semântica e a sintaxe fundamental.
- Contudo, o raciocínio profundo exige mais do que intuição rápida: resolver uma demonstração matemática ou auditar um contrato de segurança de microsserviços não é uma tarefa de resposta reflexa (Sistema 1 de Daniel Kahneman), mas um processo analítico deliberado e iterativo (Sistema 2).
1.2. Dimensão 2: Pós-Treino (Post-training Alignment)
O pós-treino através de Fine-Tuning Supervisionado (SFT) e Aprendizado por Reforço com Feedback Humano (RLHF / DPO / KTO) alinha o modelo ao formato conversacional e a princípios de segurança e prestatividade.
- No entanto, essa fase tradicionalmente apenas ensinava o modelo a imitar o estilo de respostas humanas bem avaliadas, sem fornecer ferramentas para navegar ativamente em árvores de decisão lógicas complexas.
1.3. Dimensão 3: Computação em Tempo de Inferência (Test-Time Compute)
Formalizada nos trabalhos seminais de Snell et al. (2024) da Universidade da Califórnia em Berkeley e Google DeepMind (” Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters”), a terceira dimensão prova matematicamente que:
Acurácia(M) = f(Cpre-train, Cpost-train, Ctest-time)
Para uma ampla classe de problemas desafiadores em ciências exatas, lógica e código, aumentar a computação em tempo de inferência em ordens de grandeza em um modelo menor (ex.: 8B ou 70B parâmetros) supera amplamente o desempenho de um modelo denso de 400B+ parâmetros executado em inferência padrão zero-shot.
2. Como Operam os Modelos de Raciocínio: Tokens Ocultos e Backtracking
Ao interagir com modelos da família OpenAI o1/o3 ou DeepSeek-R1, o usuário observa um comportamento radicalmente novo: o modelo não começa a digitar a resposta imediatamente. Em vez disso, transcorre uma janela de vários segundos (ou minutos) durante a qual o motor emite uma sequência substancial de Tokens de Raciocínio Ocultos (Hidden Reasoning Tokens).
2.1. O Espaço de Busca Interno e a Cadeia de Raciocínio Não-Linear
Diferente dos modelos clássicos instruídos que geram um fluxo linear ininterrupto de palavras, o modelo de raciocínio é treinado por Aprendizado por Reforço em larga escala (utilizando algoritmos como PPO ou GRPO — Group Relative Policy Optimization) para realizar ações cognitivas explícitas:
- Formulação de Hipóteses: O modelo inicia com uma abordagem preliminar para decompor o problema.
- Detecção de Inconsistências: Ao longo do fluxo de tokens internos, ele calcula passos intermediários. Se um resultado colide com uma restrição enunciada na pergunta, o modelo reconhece a incoerência.
- Auto-Correção e Backtracking: O modelo emite marcadores linguísticos estruturados (como ” Wait, this contradicts the boundary condition, let me recalculate…“ ou ” Alternative approach: let’s try proof by induction instead”), descarta o ramo infrutífero e reescreve a linha lógica antes de produzir o primeiro caractere da resposta pública final.
2.2. A Matemática do Espaço de Busca
O problema de resolver uma tarefa lógica complexa pode ser formulado como encontrar uma trajetória válida em um grafo direcionado onde cada nó representa um estado intermediário de pensamento $st$ e cada aresta representa uma operação lógica $at$:
P(Solução Correta | Prompt) = {Tválidas} P( | Prompt)
O Test-Time Compute atua aumentando o orçamento de amostragem no espaço {T}, garantindo que a probabilidade de descobrir pelo menos uma trajetória sem falhas de deriva causal tenda a 1.
3. Taxonomia de Estratégias de Test-Time Compute
Existem três famílias arquiteturais primordiais para alocar computação inteligente em tempo de inferência, cada uma com características operacionais próprias:
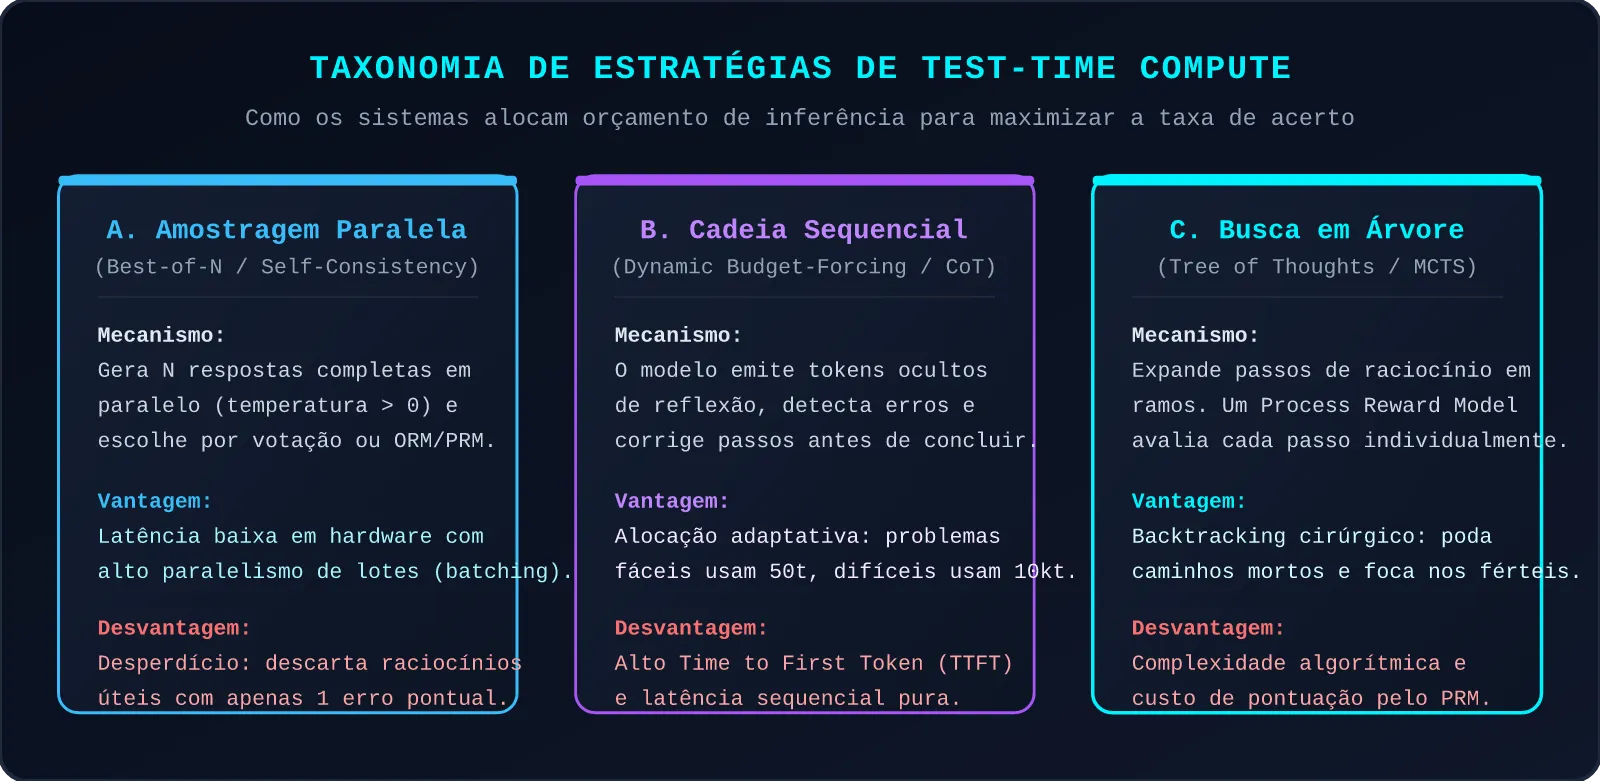
3.1. Amostragem Paralela e Best-of-N (Self-Consistency)
Popularizada pelo trabalho de Wang et al. (2023), a amostragem paralela é a forma mais direta de Test-Time Compute:
- O sistema envia a mesma consulta ao LLM com temperatura de decodificação não nula (> 0) e gera $N$ trajetórias de raciocínio completas de forma paralela.
- Método de Seleção por Votação (Self-Consistency): Para problemas com resposta fechada (número, escolha múltipla ou booleano), calcula-se a moda estatística das respostas finais.
- Seleção por Modelo de Recompensa de Desfecho (Outcome Reward Model - ORM): Um classificador independente pontua a probabilidade de a resposta final estar correta, escolhendo a trajetória com maior score:
- Gargalo: Se um raciocínio com 20 passos matemáticos estiver perfeito nos primeiros 19 passos, mas errar uma subtração elementar no último passo, o ORM descarta toda a cadeia, gerando desperdício massivo de tokens.
3.2. Cadeias Sequenciais Adaptativas (Dynamic Budget-Forcing)
Em vez de disparar centenas de caminhos em paralelo, o modelo utiliza uma única cadeia sequencial estendida cujo tamanho é modulado dinamicamente com base na complexidade do problema:
- Modelos pequenos são treinados para continuar gerando tokens de reflexão até atingirem um limiar de confiança interna.
- Alocação Dinâmica de Orçamento (Budget-Forcing): Em sistemas de produção, a aplicação injeta instruções de controle de tokens de raciocínio (ex.:
reasoning_effort: low, medium, high). - Em perguntas simples (ex.: ” Qual a capital da França?“), o modelo consome apenas 30 a 50 tokens de pensamento. Em problemas de criptografia ou análise de concorrência de software, consome 15.000 tokens antes de responder.
3.3. Busca em Árvore Guiada por Verificador de Processo (PRM e MCTS)
A abordagem mais sofisticada e computacionalmente eficiente em problemas de múltiplos estágios é a Busca em Árvore (Tree of Thoughts - ToT / Monte Carlo Tree Search - MCTS) com suporte de um Process Reward Model (PRM), introduzido nos trabalhos seminais da OpenAI (Lightman et al., 2023, ” Let’s Verify Step by Step”).
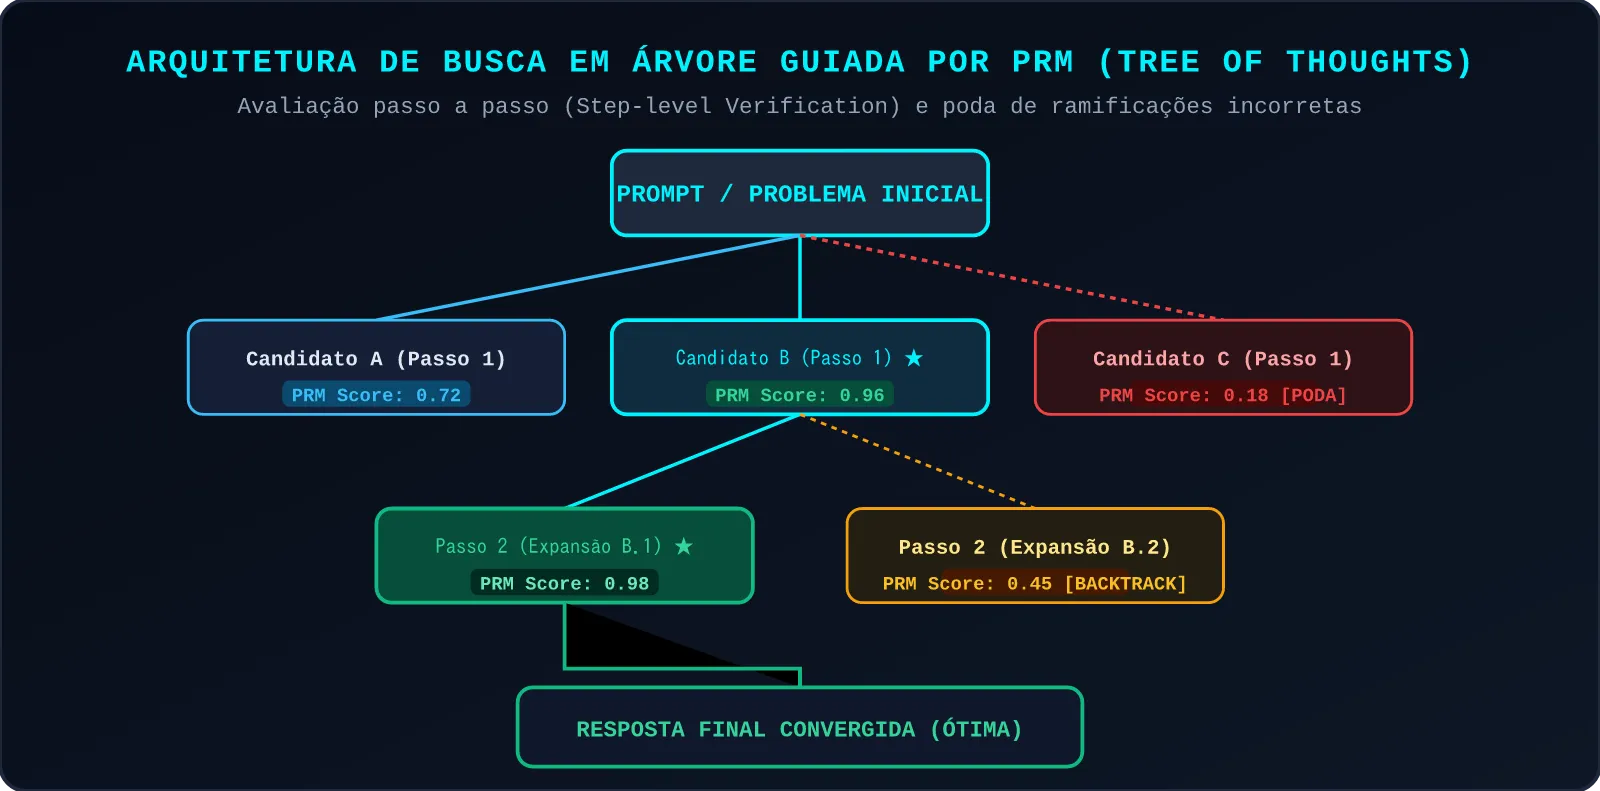
Diferente do ORM (que avalia apenas o desfecho final), o PRM avalia cada passo de pensamento intermediário individualmente :
As Quatro Fases do MCTS em Inferência:
- Seleção (Selection): O algoritmo navega na árvore de pensamentos existentes utilizando uma heurística como o Upper Confidence Bound for Trees (UCT), equilibrando exploração de ramos promissores e exploração de ramos pouco visitados.
- Expansão (Expansion): A partir do nó selecionado, o LLM gera $K$ possíveis próximos passos de raciocínio.
- Avaliação por PRM (Simulation / Scoring): O Process Reward Model atribui uma nota para cada passo gerado.
- Poda e Retropropagação (Backpropagation & Pruning): Ramos com pontuações abaixo de uma nota de corte crítica (ex.: Score < 0.50) são imediatamente podados da árvore de busca. Os valores dos nós ancestrais são atualizados com a média ou o valor máximo dos nós filhos.
Tabela 1: Comparativo das Estratégias de Test-Time Compute
| Dimensão de Engenharia | Amostragem Best-of-N (ORM) | Cadeia Sequencial Adaptativa (CoT o1/R1) | Busca em Árvore Guiada por PRM (ToT / MCTS) |
|---|---|---|---|
| Complexidade de Implementação | Baixa (Apenas loop de amostragem) | Média (Exige modelo treinado para raciocínio) | Alta (Exige PRM treinado + motor de busca em árvore) |
| Padrão de Latência | Paralelizável (Limitada pela GPU do cluster) | Sequencial (Alto tempo de execução por token) | Híbrida (Expansão paralela + travessia sequencial) |
| Eficiência no Uso de Tokens | Baixa (Desperdiça trajetórias 90% certas) | Média a Alta (Auto-correção na mesma cadeia) | Máxima (Apenas ramos verificados são aprofundados) |
| Capacidade de Backtracking | Inexistente (Caminhos são independentes) | Nativa no próprio fluxo de texto | Algorítmica e Determinística |
| Sensibilidade a Erros Intermediários | Alta (Propaga o erro até o fim do texto) | Moderada (Depende da auto-vigilância do LLM) | Mínima (PRM corta o erro na raiz do nó) |
| Custo por Resposta Correta | Alto em problemas difíceis | Médio | Otimizado para problemas de alta complexidade |
4. Trade-offs de Engenharia: Latência, Custo Financeiro e Quando Usar
Apesar do salto de acurácia, a utilização indiscriminada de Test-Time Compute em ambientes corporativos pode introduzir gargalos severos na experiência do usuário e na viabilidade econômica dos produtos.
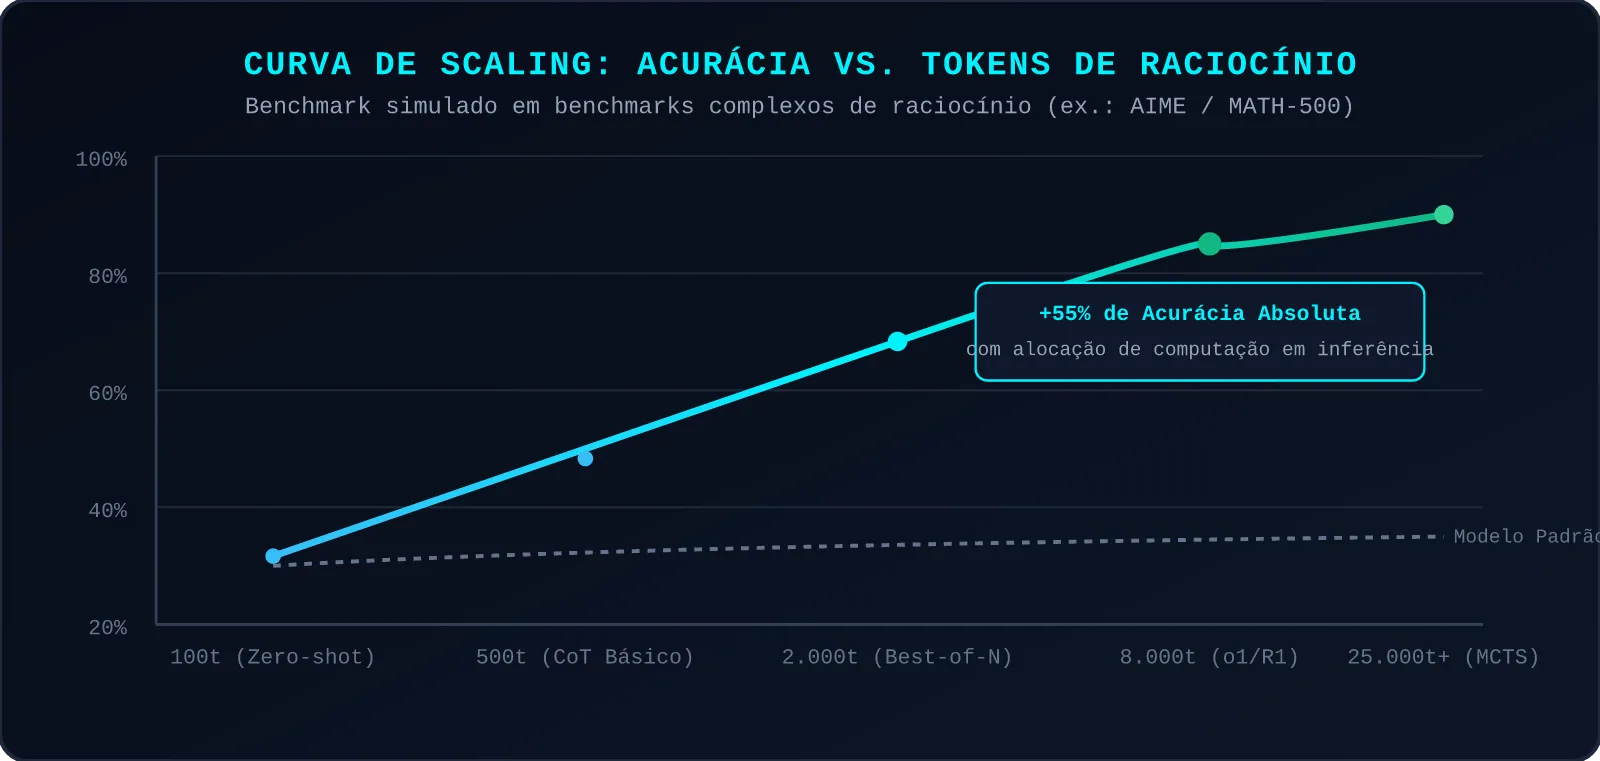
4.1. O Impacto no Time to First Token (TTFT)
Em aplicações de conversação convencional ou preenchimento automático, os usuários toleram uma latência de Time to First Token (TTFT) inferior a 800 milissegundos.
- Modelos de raciocínio profundo com Test-Time Compute elevado frequentemente apresentam TTFT entre 10 segundos e 60 segundos, pois o motor precisa gerar milhares de tokens de pensamento ocultos antes de emitir a primeira palavra da resposta final.
- Diretriz de UX: Nunca utilize modelos de raciocínio diretamente em interfaces síncronas de chat sem fornecer feedback visual explícito de status (ex.: animações de progresso, indicação dos tópicos sendo analisados ou streaming do raciocínio).
4.2. A Equação Econômica da Inferência
Enquanto o custo de modelos clássicos otimizados é faturado estritamente sobre os tokens de entrada e saída exibidos ao usuário, os modelos de raciocínio faturam também os tokens de raciocínio internos gerados durante o pensamento.
- Uma consulta com prompt de 200 tokens e resposta de 150 tokens pode consumir 8.000 tokens de raciocínio intermediários. O custo por requisição salta de frações de centavos para valores entre US$ 0,05 e US$ 0,40 por chamada de API.
Tabela 2: Matriz de Decisão Arquitetural: Reasoning Models vs. Modelos Padrão
| Caso de Uso Corporativo | Complexidade Lógica | Modelo Recomendado | Estratégia Computacional | Justificativa Técnica |
|---|---|---|---|---|
| Geração de Copywriting / Resumos | Baixa | Modelo Padrão Instruído (ex.: GPT-4o-mini / Flash) | Zero-shot ou 1-shot | Tarefa puramente de estilo linguístico; não requer busca combinatorial. |
| Auditoria de Vulnerabilidades em Smart Contracts | Extrema | Reasoning Model (ex.: o1 / o3 / DeepSeek-R1) | MCTS ou Alta Amostragem Sequencial | Um único erro de lógica resulta em perda milionária; o custo de US$ 1,00 por análise é desprezível. |
| Classificação de Sentimento / Triagem de Tickets | Muito Baixa | Modelo Compacto Destilado (8B parâmetros) | Zero-shot com JSON Schema | Alta taxa de requisições por segundo (RPS); exige latência sub-segundo e custo mínimo. |
| Otimização de Rotas Logísticas / Escalonamento | Alta | Reasoning Model com PRM ou Solver Externo | Busca em Árvore Guiada | Problema NP-difícil onde o raciocínio heurístico iterativo supera o chute intuitivo. |
| Atendimento ao Cliente de Nível 1 | Baixa a Média | Modelo Padrão com RAG Vetorial | Few-shot + Roteamento | Requer baixa latência conversacional e respostas baseadas em políticas estritas da empresa. |
5. Implementação Completa em Python: Orquestrador de Test-Time Compute
Abaixo, apresentamos uma implementação funcional de um Orquestrador de Test-Time Compute. O sistema modela um motor de busca com:
- Geração de passos candidatos de raciocínio.
- Um Process Reward Model (PRM) simulado que pontua a validade de cada passo individualmente.
- Mecanismo de Backtracking e Poda, descartando ramos com pontuação abaixo do limiar estipulado.
- Alocação dinâmica de orçamento com convergência orientada a metas.
O código a seguir está pronto para execução:
import math
import random
from typing import List, Dict, Any, Tuple, Optional

class ProcessRewardModel:
    def __init__(self, cutoff_threshold: float = 0.65):
        self.cutoff_threshold = cutoff_threshold
    def evaluate_step(self, step_text: str, current_state: str, ground_truth_constraints: List[str]) -> Tuple[float, str]:
        score = 0.50
        step_lower = step_text.lower()
        if "erro" in step_lower or "invalido" in step_lower or "contradição" in step_lower:
            score = 0.20
            return score, "Falha: Passo introduz contradição lógica evidente."
        for constraint in ground_truth_constraints:
            if constraint.lower() in step_lower:
                score += 0.25
        if "logo" in step_lower or "portanto" in step_lower or "calculando" in step_lower or "passo" in step_lower:
            score += 0.15
        if "divisao por zero" in step_lower or "raiz negativa" in step_lower:
            score = 0.05
            return score, "Falha crítica: Operação matemática proibida."
        final_score = min(max(score, 0.0), 1.0)
        verdict = "Aprovado" if final_score >= self.cutoff_threshold else "Reprovado (Poda)"
        return final_score, verdict

class ThoughtNode:
    def __init__(self, step_content: str, parent: Optional['ThoughtNode'] = None, step_depth: int = 0):
        self.step_content = step_content
        self.parent = parent
        self.step_depth = step_depth
        self.children: List['ThoughtNode'] = []
        self.prm_score: float = 0.0
        self.is_pruned: bool = False
    def get_full_trajectory(self) -> List[str]:
        trajectory = []
        curr = self
        while curr is not None:
            if curr.step_content:
                trajectory.append(curr.step_content)
            curr = curr.parent
        trajectory.reverse()
        return trajectory

class TestTimeComputeOrchestrator:
    def __init__(self, prm: ProcessRewardModel, max_depth: int = 3, branch_factor: int = 3):
        self.prm = prm
        self.max_depth = max_depth
        self.branch_factor = branch_factor
        self.tokens_consumed = 0
    def simulate_llm_step_expansion(self, current_trajectory: List[str], problem: str) -> List[str]:
        self.tokens_consumed += 120
        depth = len(current_trajectory)
        if depth == 0:
            return [
                "Passo 1: Decompor o problema em equações lineares fundamentais com base nas restrições",
                "Passo 1: Supor um valor aleatório para a variável e tentar resolver por aproximação",
                "Passo 1: Estabelecer a relação algébrica inicial isolando o termo dependente"
            ]
        elif depth == 1:
            return [
                "Passo 2: Aplicar o Teorema Fundamental e derivar a expressão para encontrar o ponto crítico",
                "Passo 2: Realizar uma divisao por zero simplificando termos cancelados indevidamente",
                "Passo 2: Substituir a variável na equação secundária e calcular o discriminante"
            ]
        else:
            return [
                "Passo 3: Logo, a solução única que satisfaz todas as restrições é x = 42",
                "Passo 3: Portanto, encontramos x = 15, confirmando a consistência final",
                "Passo 3: Concluir com contradição sem validar os termos da premissa"
            ]
    def search_optimal_reasoning_path(self, problem: str, constraints: List[str]) -> Dict[str, Any]:
        root = ThoughtNode(step_content="", step_depth=0)
        active_frontier = [root]
        best_leaf: Optional[ThoughtNode] = None
        best_score = -1.0
        pruned_nodes_count = 0
        total_nodes_evaluated = 0
        for current_depth in range(self.max_depth):
            next_frontier = []
            for node in active_frontier:
                if node.is_pruned:
                    continue
                trajectory = node.get_full_trajectory()
                candidate_steps = self.simulate_llm_step_expansion(trajectory, problem)
                for step in candidate_steps:
                    total_nodes_evaluated += 1
                    child_node = ThoughtNode(step_content=step, parent=node, step_depth=current_depth + 1)
                    score, verdict = self.prm.evaluate_step(step, " ".join(trajectory), constraints)
                    child_node.prm_score = score
                    if score < self.prm.cutoff_threshold:
                        child_node.is_pruned = True
                        pruned_nodes_count += 1
                    else:
                        node.children.append(child_node)
                        next_frontier.append(child_node)
                        if (current_depth + 1) == self.max_depth and score > best_score:
                            best_score = score
                            best_leaf = child_node
            active_frontier = next_frontier
            if not active_frontier:
                break
        final_solution_path = best_leaf.get_full_trajectory() if best_leaf else []
        return {
            "problem": problem,
            "solution_found": len(final_solution_path) > 0,
            "optimal_trajectory": final_solution_path,
            "terminal_prm_score": best_score,
            "metrics": {
                "total_reasoning_tokens": self.tokens_consumed,
                "evaluated_nodes": total_nodes_evaluated,
                "pruned_branches": pruned_nodes_count,
                "tree_depth_reached": len(final_solution_path)
            }
        }

if __name__ == "__main__":
    prm_engine = ProcessRewardModel(cutoff_threshold=0.60)
    orchestrator = TestTimeComputeOrchestrator(prm=prm_engine, max_depth=3, branch_factor=3)
    target_problem = "Encontrar o valor de x que maximiza a função sob restrições lineares."
    ground_truth_rules = ["equações lineares", "ponto crítico", "solução única"]
    search_results = orchestrator.search_optimal_reasoning_path(target_problem, ground_truth_rules)
    import json
    print(json.dumps(search_results, indent=2, ensure_ascii=False))
6. Boas Práticas para Integração de Reasoning Models em Produção
Para engenheiros de software e arquitetos de IA que planejam integrar modelos com Test-Time Compute em ambientes corporativos, cinco diretrizes operacionais são mandatórias:
6.1. Implementar Arquitetura de Roteamento Semântico (Semantic Query Routing)
Não envie todas as mensagens para o modelo de raciocínio mais caro. Coloque um classificador leve na entrada da API:
- Filtro de Complexidade: Se a consulta for uma solicitação de reformulação, tradução ou consulta RAG direta, direcione para um modelo convencional rápido (baixa latência).
- Escalonamento para Raciocínio: Se a consulta envolver planejamento multi-etapas, matemática, contratos jurídicos ou código, redirecione para o motor de Test-Time Compute.
6.2. Gerenciamento Assíncrono com Webhooks ou Streaming Parcial
Devido ao alto TTFT:
- Em tarefas corporativas de longa duração (ex.: auditoria de código ou reconciliação contábil), execute as chamadas de API de forma assíncrona utilizando mensageria (como RabbitMQ, Kafka ou SQS) e notifique o usuário via Webhook quando o processamento for finalizado.
6.3. Monitoramento de Custo e Orçamento de Tokens (Token Budget Caps)
Configure limites estritos de tokens de raciocínio na camada de proxy da sua infraestrutura. Caso contrário, um modelo preso em loops de auto-correção não convergente em um problema indecidível pode queimar dezenas de milhares de tokens antes de disparar um timeout.
7. Perguntas Frequentes (FAQ)
1. O que são exatamente os “Tokens de Pensamento Ocultos” (Hidden Reasoning Tokens)?
São tokens gerados internamente pelo modelo que contêm a cadeia de reflexão lógica, hipóteses e correções de rota. Na maioria das APIs comerciais (como a da OpenAI para o o1), esses tokens são gerados, faturados, mas não são exibidos diretamente ao usuário final para proteger os dados de pós-treino e técnicas proprietárias de alinhamento da empresa. Em modelos de código aberto como o DeepSeek-R1, esses tokens são encapsulados dentro de tags especiais ... e podem ser lidos livremente pelo desenvolvedor.
2. O Test-Time Compute elimina completamente as alucinações dos LLMs?
Não. O Test-Time Compute reduz substancialmente as alucinações causadas por erros de cálculo, pressa algorítmica ou falha de consistência lógica interna. No entanto, se o modelo não possuir o conhecimento factual em seus pesos (ou não tiver acesso a uma base RAG atualizada), ele poderá raciocinar de forma perfeitamente coerente a partir de premissas factualmente inexistentes ou incorretas.
3. Qual a diferença fundamental entre ORM (Outcome Reward Model) e PRM (Process Reward Model)?
O ORM avalia apenas a resposta final do modelo como um todo (binário ou nota escalar), ignorando se os passos intermediários foram corretos ou se o modelo acertou por pura coincidência. O PRM avalia e pontua cada passo de raciocínio de forma isolada, permitindo identificar o momento exato em que o raciocínio descarrilou e viabilizando o corte (pruning) do ramo antes que o modelo queime mais computação no caminho errado.
4. Vale a pena utilizar modelos com Test-Time Compute para tarefas tradicionais de RAG (Busca Vetorial)?
Somente na fase de síntese e extração lógica cruzada de múltiplos documentos. Para a recuperação vetorial de trechos de texto (chunk retrieval), o modelo de raciocínio não adiciona ganhos diretos. O ganho ocorre quando os documentos recuperados contêm contradições entre si e o sistema precisa auditar qual fonte possui precedência jurídica ou lógica.
5. O que é o fenômeno de “Overtraining” ou saturação de raciocínio em Test-Time Compute?
Trabalhos de pesquisa recentes demonstraram que gastar tokens de raciocínio em excesso em problemas simples pode levar o modelo a “duvidar de si mesmo” (overthinking), inventando complexidades que não existem e alterando uma resposta correta inicial para uma resposta incorreta. Por isso, a modulação adaptativa do orçamento de tokens conforme a dificuldade do problema é um campo de pesquisa crítico.
Referências Bibliográficas e Literatura Técnica
- SNELL, Charlie et al. Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. arXiv preprint, arXiv:2408.03314, 2024.
- OPENAI. OpenAI o1 System Card: Development, Safety, and Evaluation of Reasoning Models. Technical Whitepaper, 2024. Disponível em: https://openai.com/index/openai-o1-system-card/.
- DEEPSEEK-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. Technical Report, 2025. arXiv:2501.12948.
- LIGHTMAN, Hunter et al. Let ’s Verify Step by Step. Proceedings of the International Conference on Learning Representations (ICLR), 2023. arXiv:2305.20050.
- WANG, Xuezhi et al. Self-Consistency Improves Chain of Thought Reasoning in Language Models. Proceedings of the International Conference on Learning Representations (ICLR), 2023. arXiv:2203.11171.
- YAO, Shunyu et al. Tree of Thoughts: Deliberate Problem Solving with Large Language Models. Advances in Neural Information Processing Systems (NeurIPS), v. 36, 2023. arXiv:2305.10601.
- HOFFMANN, Jordan et al. Training Compute-Optimal Large Language Models (Chinchilla). Advances in Neural Information Processing Systems (NeurIPS), v. 35, p. 30016-30030, 2022.
- KAPLAN, Jared et al. Scaling Laws for Neural Language Models. arXiv preprint, arXiv:2001.08361, 2020.
- KAHNEMAN, Daniel. Thinking, Fast and Slow. New York: Farrar, Straus and Giroux, 2011.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…