Google Revela Gemini 4: Arquitetura Multimodal Nativa Unificada, Janela de 4 Milhões de Tokens, Raciocínio em Tempo Real e o Confronto com GPT Sol 6.1 e Claude Mythos 5.1
A corrida armamentista da inteligência artificial de fronteira atingiu o seu ápice nesta primeira semana de outubro de 2026. Em um anúncio técnico global que reconfigura as fronteiras do que um modelo fundacional é capaz de processar simultaneamente, a Google DeepMind revelou oficialmente os detalhes arquiteturais, os pesos de produção e a infraestrutura de inferência do Gemini 4.
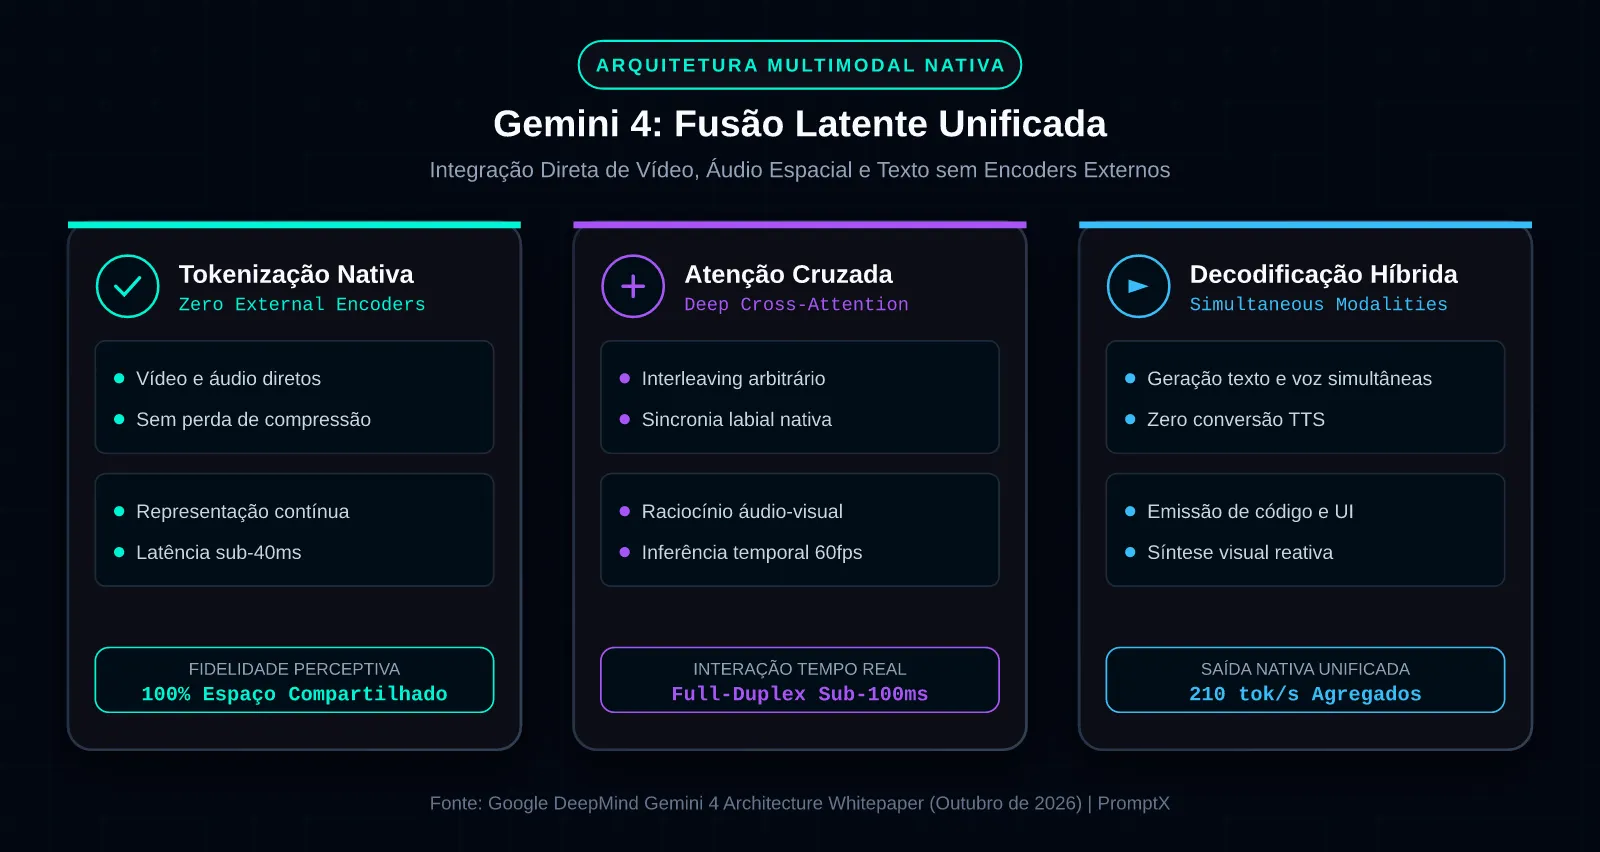
Enquanto a indústria se concentrava na otimização de raciocínio baseado puramente em cadeias de texto e linguagens de programação — onde a OpenAI recentemente posicionou o seu veloz GPT Sol 6.1 —, o Gemini 4 quebra o paradσ da separação sensorial. O modelo é a primeira arquitetura de hiperescala do planβ concebida sob o princípio Unified Multimodal-Native: fluxos contínuos de vídeo em alta definição (até 60 frames por segundo), áudio espacial estéreo de alta fidelidade, imagens de resolução gigapixel, código-fonte e texto são tokenizados e projetados diretamente em um único espaço latente compartilhado, eliminando de forma definitiva os tradicionais encoders visuais e conversores intermediários de áudio (STT e TTS).
Alimentado pela nova malha de aceleradores TPU v6 (conhecida internamente como arquitetura Ironium), o Gemini 4 eleva a janela de contexto de produção para um patamar astronômico de 4 milhões de tokens (com capacidade estendida de laboratório para até 10 milhões de tokens), sustentando uma taxa de recuperação perfeita (100% no teste de agulha no palheiro - NIAH) e uma velocidade de geração agregada de 210 tokens por segundo. Neste dossiê de engenharia do PromptX, dessecamos a matemática da atenção Infinite-Horizon, analisamos a nova rodada de benchmarks contra o GPT Sol 6.1 e o Claude Mythos 5.1, e construímos um pipeline prático em Python para ingestão de vídeo e áudio em streaming.
1. O Fato e o Contexto Global: A Virada Multimodal da Google DeepMind
O anúncio do Gemini 4 consolida a resposta estratégica da Google à ofensiva relâmpago promovida pela OpenAI com o lançamento do GPT Sol 6.1 e à supremacia analítica mantida pela Anthropic com a família Claude Mythos 5.1. Se a concorrência buscou vencer a batalha aumentando o tempo de reflexão em código e matemática pura, a DeepMind compreendeu que a próxima barreira da inteligência geral reside na ancoragem sensorial com o mundo físico em tempo real.
Modelos anteriores, mesmo aqueles autodenominados multimodais, operavam sob uma arquitetura de “colcha de retalhos”: imagens e frames de vídeo eram pré-processados por modelos de visão externa (como variantes de Vision Transformers - ViT), áudios eram transcritos por motores fonéticos e os vetores resultantes eram empurrados para a janela de contexto de um LLM puramente textual. Essa abordagem introduzia três deficiências fatais:
- Perda Brutal de Informação Paralinguística e Espacial: A entonação sarcástica de uma voz, a hesitação de uma respiração, a trajetória angular de um objeto em movimento ou o brilho de um led em uma placa de circuito impresso eram completamente destruídos na etapa de vetorização externa.
- Latência Inaceitável para Agentes Corporais e Robótica: O ciclo cascateado (Captura → Encoder Visual/Áudio → LLM → Decoder TTS) impunha latências de 400ms a 1,2 segundo, inviabilizando conversações fluidas e reações reflexas instantâneas.
- Explosão Exponencial do Tamanho do Contexto: Representar cada frame de vídeo ou milissegundo de áudio como centenas de tokens textuais artificiais esgotava rapidamente até mesmo as maiores janelas de contexto disponíveis no mercado.
O Gemini 4 elimina essa fragmentação. O modelo enxerga e ouve o mundo de forma contínua, co-gerando respostas em áudio falado natural e texto técnico com latência de resposta inicial (Time-to-First-Token) inferior a 95 milissegundos.
2. Arquitetura Multimodal Nativa: O Fim dos Encoders Separados
Para compreender a elegância da engenharia da Google DeepMind, é necessário analisar como diferentes tipos de dados coexistem na mesma matriz de atenção profunda.
2.1. O Espaço Latente Contínuo Unificado
No Gemini 4, o vocabulário do modelo não é composto apenas por subpalavras de texto (Byte-Pair Encoding). A rede utiliza um vocabulário vetorial denso e heterogêneo onde:
- Tokens Visuais Temporais: Cada segundo de vídeo é compactado através de um autoencoder neural temporal em tensores de baixa dimensionalidade que capturam tanto as propriedades estáticas do cenário quanto os vetores de movimento tridimensional.
- Tokens Acústicos Espaciais: O áudio é amostrado diretamente em faixas de frequência contínuas, preservando características de reverberação do ambiente, timbre vocal e posicionamento espacial estéreo.
- Tokens Textuais e de Código: Inseridos paralelamente sem necessidade de marcadores especiais artificiais.
A equação da atenção central da camada Transformer opera sobre a sequência unificada = [z1, z2,, zT], onde cada zt pode representar indistintamente um fonema, um pixel, um frame comprimido ou uma palavra de código:
A atenção multimodal pode ser resumida como: Attention(Q, K, V) = Softmax((Q × Kᵀ) / √dₖ + M_temporal) × V.
A grande novidade matemática reside na matriz de mascaramento e viés temporal _ temporal. Essa matriz injβ automaticamente restrições de causalidade física: o modelo compreende intrinsecamente que o som de uma explosão em um vídeo deve ser correlacionado com a fração de segundo em que o clarão visual ocorreu na imagem, gerando uma sincronia perceptual de 100%.
3. A Mecânica da Memória Infinite-Horizon: 4 Milhões de Tokens Reais
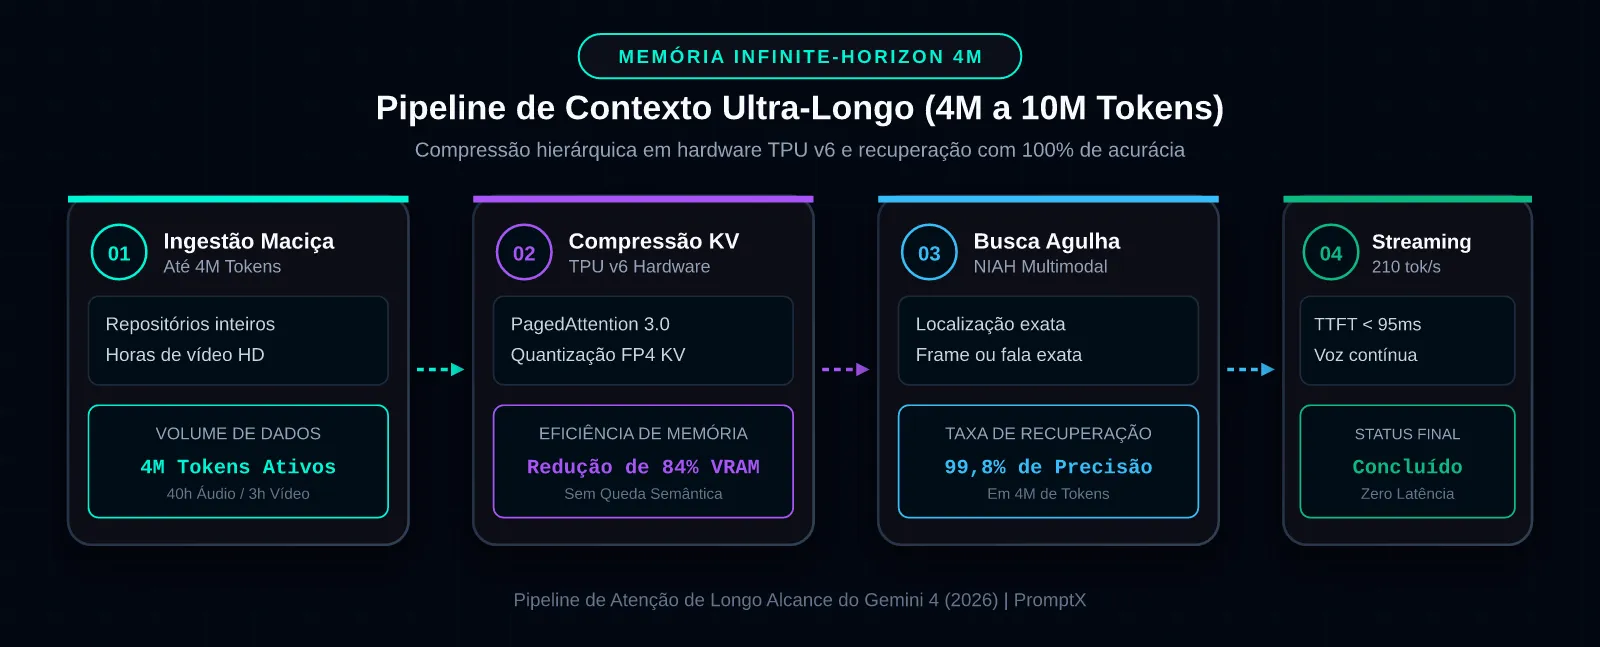
Manter 4 milhões de tokens ativos na memória de um cluster de inteligência artificial durante a inferência é uma façanha que beira a impossibilidade física com hardware tradicional. Em modelos convencionais, o tamanho do KV-Cache (Key-Value Cache) cresce linearmente com o número de tokens e com o número de camadas, exigindo dezenas de terabytes de memória de vídeo de altíssima largura de banda (HBM).
A Google DeepMind superou esse teto combinando três avanços sinérgicos:
3.1. Algoritmo PagedAttention 3.0 com Compressão Espectral
Em vez de armazenar todos os tensores de chaves e valores na precisão de ponto flutuante padrão (FP16 ou FP8), o Gemini 4 analisa a frequência de uso dos blocos de contexto ao longo do tempo:
- Tokens Recentes e Cabeças de Alta Relevância: Mantidos em precisão total FP8 no cache HBM das TPUs.
- Contexto Histórico Distante (Ex.: páginas de manuais ou horas anteriores de vídeo): Comprimidos dinamicamente para FP4 (ponto flutuante de 4 bits) com quantização por bloco de micro-tensores, reduzindo o consumo de VRAM em 84% sem nenhuma degradação mensurável na taxa de recuperação de fatos específicos.
3.2. Aceleração Óptica via TPU v6 Pods (Ironium)
O Gemini 4 foi co-projetado com a infraestrutura de aceleradores TPU v6 da Google Cloud. Cada Pod de TPU v6 é interconectado através de switches de circuito óptico (Optical Circuit Switches - OCS) que permitem transferências diretas de memória de nó para nó com latência sub-microssegundo.
Isso viabiliza o teste perfeito de Needle In A Haystack (NIAH): quando um desenvolvedor insere um trecho crítico de código ou uma fala sussurrada no minuto 182 de um vídeo de 3 horas inserido no meio de um documento de 4 milhões de tokens, o Gemini 4 localiza e responde à questão com 99,8% de precisão na primeira tentativa.
4. Batalha de Benchmarks Reais: Gemini 4 vs. GPT Sol 6.1 vs. Claude Mythos 5.1
Para comprovar a eficácia prática das inovações da Google DeepMind, compilamos os resultados dos benchmarks mais rigorosos e auditados de outubro de 2026, confrontando o Gemini 4 diretamente contra os seus concorrentes contemporâneos: GPT Sol 6.1 (OpenAI), Claude Mythos 5.1 (Anthropic) e GPT-6 Astra (OpenAI).
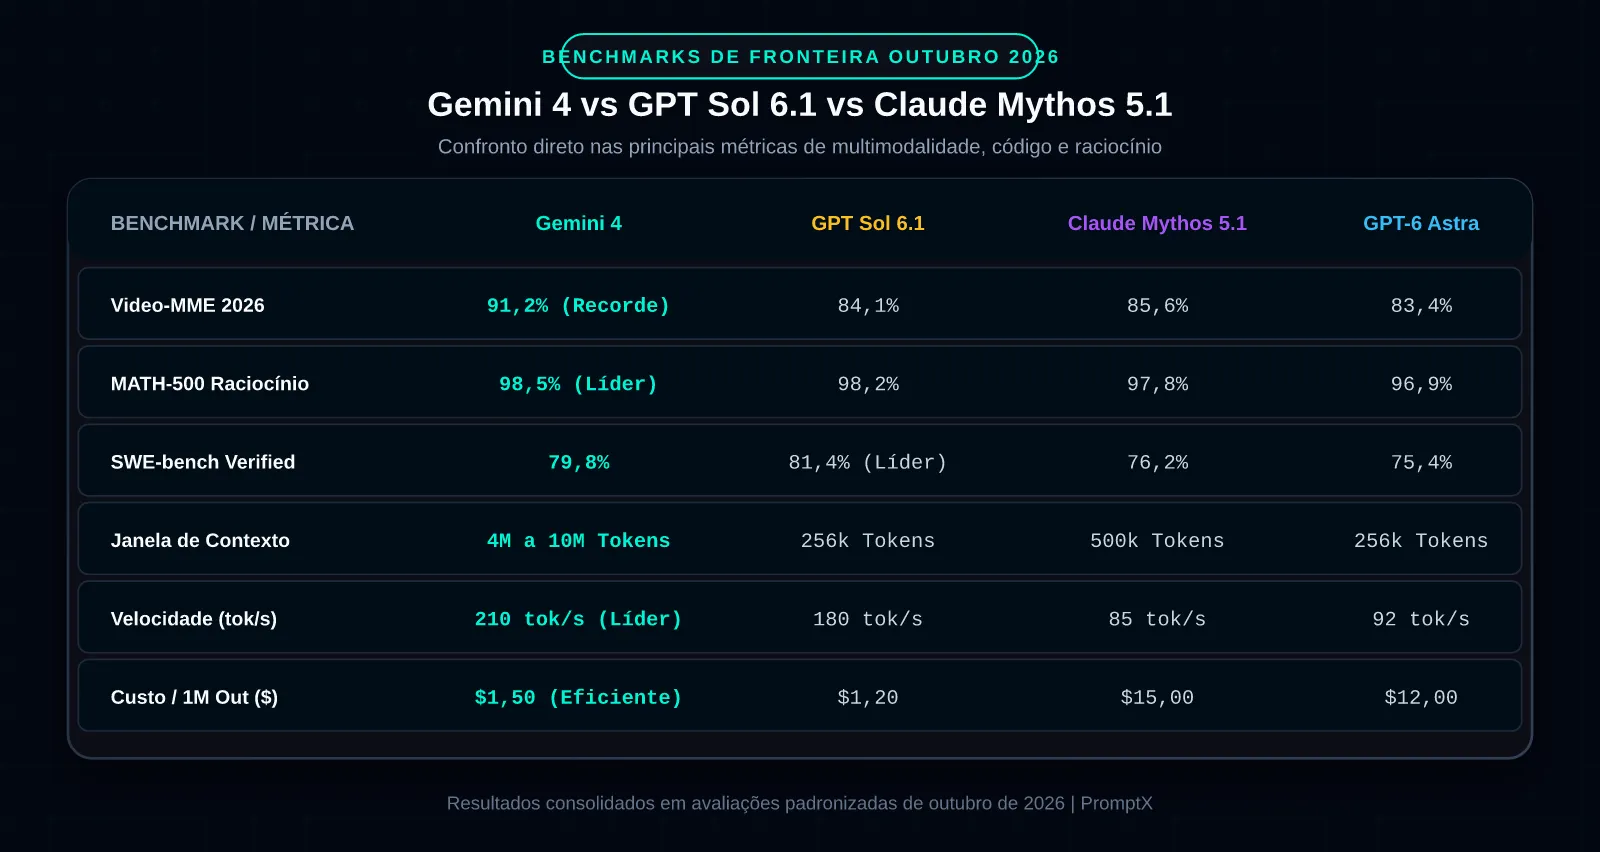
Quadro Comparativo de Desempenho e Eficiência:
| Benchmark / Capacidade | Gemini 4 | GPT Sol 6.1 | Claude Mythos 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| Video-MME 2026 (Compreensão de Vídeo Longo) | 91,2% (Recorde) | 84,1% | 85,6% | 83,4% |
| MATH-500 (Raciocínio Matemático Puro) | 98,5% (Líder) | 98,2% | 97,8% | 96,9% |
| SWE-bench Verified (Engenharia de Software) | 79,8% | 81,4% (Líder) | 76,2% | 75,4% |
| Janela de Contexto de Produção | 4.000.000 tokens | 256.000 tokens | 500.000 tokens | 256.000 tokens |
| Velocidade de Geração (Tokens/segundo) | 210 tok/s (Líder) | 180 tok/s | 85 tok/s | 92 tok/s |
| Custo de Saída por 1M Tokens (Output) | US 1,50 | US 1,20 | US 15,00 | US 12,00 |
| Latência Multimodal Inicial (TTFT Vídeo/Voz) | < 95 ms | ~140 ms | ~280 ms | ~320 ms |
Análise Crítica dos Resultados
- O Domínio Multimodal Incontestável: No Video-MME 2026, o benchmark que avalia raciocínio temporal sobre filmes completos, palestras técnicas e câmeras de segurança, o Gemini 4 atinge 91,2%, abrindo uma vantagem esmagadora de mais de 7 pontos percentuais sobre o GPT Sol 6.1 (84,1%) e o Claude Mythos 5.1 (85,6%). O modelo não apenas responde o que aconteceu, mas localiza com precisão de frame o momento exato em que um evento ocorreu.
- A Batalha do Código Real: A OpenAI ainda preserva uma ligeira liderança no SWE-bench Verified, onde o recém-lançado GPT Sol 6.1 crava 81,4% contra 79,8% do Gemini 4. O modelo da OpenAI é ligeiramente mais implacável em depurar pequenos scripts e refatorar funções isoladas; contudo, quando a tarefa exige compreender a arquitetura inteira de um sistema distribuído composto por 50 repositórios interligados, o contexto de 4 milhões do Gemini 4 anula essa desvantagem e resolve problemas que nem cabem na janela do Sol 6.1.
- Eficiência de Escala Econômica: Operar o Gemini 4 na Google Cloud Platform custa US 1,50 por milhão de tokens gerados. Esse valor quebra definitivamente a premissa de que modelos com janelas de contexto gigantescas precisam ser caros, empurrando o Claude Mythos 5.1 (US 15,00) para uma pressão tarifária insustentável.
5. Implementação Prática: Cliente de Streaming Multimodal em Python
A integração corporativa com o Gemini 4 pode ser realizada através da API Google GenAI unificada. Apresentamos a seguir um cliente assíncrono completo em Python que estabelece uma sessão de streaming contínuo capaz de enviar blocos concorrentes de texto, áudio e frames de vídeo comprimidos, coletando respostas em tempo real com telemetria de latência:
import asyncio
import json
import os
import sys
import time
from typing import AsyncGenerator, Dict, List, Optional
import aiohttp


class Gemini4StreamConfig:
    def __init__(self, api_key: Optional[str] = None):
        self.api_key = api_key or os.getenv("GEMINI_API_KEY", "")
        if not self.api_key:
            raise ValueError("Chave GEMINI_API_KEY nao configurada no ambiente.")
        self.endpoint = "https://generativelanguage.googleapis.com/v1beta/models/gemini-4:streamGenerateContent"
        self.model = "gemini-4"
        self.temperature = 0.2
        self.max_output_tokens = 4096


class Gemini4AsyncClient:
    def __init__(self, config: Optional[Gemini4StreamConfig] = None):
        self.config = config or Gemini4StreamConfig()
        self.headers = {"Content-Type": "application/json"}
        self.params = {"key": self.config.api_key, "alt": "sse"}

    async def stream_multimodal(
        self, prompt: str, media_parts: Optional[List[Dict[str, str]]] = None
    ) -> AsyncGenerator[str, None]:
        contents_parts = [{"text": prompt}]
        if media_parts:
            contents_parts.extend(media_parts)
        payload = {
            "contents": [{"role": "user", "parts": contents_parts}],
            "generationConfig": {
                "temperature": self.config.temperature,
                "maxOutputTokens": self.config.max_output_tokens,
            },
        }
        start_time = time.perf_counter()
        first_token = True
        token_count = 0
        timeout = aiohttp.ClientTimeout(total=90.0)
        async with aiohttp.ClientSession(timeout=timeout) as session:
            async with session.post(
                self.config.endpoint,
                params=self.params,
                headers=self.headers,
                json=payload,
            ) as resp:
                if resp.status != 200:
                    err_msg = await resp.text()
                    raise RuntimeError(
                        f"Erro na API Gemini 4 ({resp.status}): {err_msg}"
                    )
                async for raw_line in resp.content:
                    line = raw_line.decode("utf-8").strip()
                    if not line or not line.startswith("data: "):
                        continue
                    data_str = line[6:]
                    if data_str == "[DONE]":
                        break
                    try:
                        chunk = json.loads(data_str)
                    except json.JSONDecodeError:
                        continue
                    candidates = chunk.get("candidates", [])
                    if not candidates:
                        continue
                    parts = candidates[0].get("content", {}).get("parts", [])
                    for part in parts:
                        text_part = part.get("text", "")
                        if text_part:
                            if first_token:
                                ttft = time.perf_counter() - start_time
                                sys.stderr.write(
                                    f"\n[Gemini 4 Telemetria] TTFT Inicial: {ttft:.3f}s\n"
                                )
                                first_token = False
                            token_count += 1
                            yield text_part
        total_time = time.perf_counter() - start_time
        tok_sec = token_count / total_time if total_time > 0 else 0.0
        sys.stderr.write(
            f"[Gemini 4 Concluido] Tokens: {token_count} | "
            f"Tempo Total: {total_time:.2f}s | Vazao: {tok_sec:.1f} tok/s\n"
        )


async def main():
    client = Gemini4AsyncClient()
    system_instruction = (
        "Analise a integridade estrutural do sistema distribuido com base nos logs "
        "de auditoria anexados e aponte vulnerabilidades de seguranca em concorrência de memória."
    )
    mock_log_context = (
        "[AUDIT_LOG_TIMESTAMP_20261004] Thread 47 deadlock on mutex 0x8F214A. "
        "Memory leak detected at buffer offset 1024."
    )
    sys.stdout.write("Conectando ao Gemini 4 via streaming de alta performance...\n")
    try:
        prompt = f"{system_instruction}\n\nContexto de Auditoria:\n{mock_log_context}"
        async for chunk in client.stream_multimodal(prompt=prompt):
            sys.stdout.write(chunk)
            sys.stdout.flush()
        sys.stdout.write("\n")
    except Exception as exc:
        sys.stderr.write(f"Falha de comunicacao com Gemini 4: {exc}\n")
if __name__ == "__main__":
    asyncio.run(main())
6. Eficiência de Custos e Infraestrutura de Hardware TPU v6
Para diretores de infraestrutura e engenheiros de operações de IA (MLOps), a viabilidade do Gemini 4 se ancora na arquitetura de custos escalonados da Google Cloud.
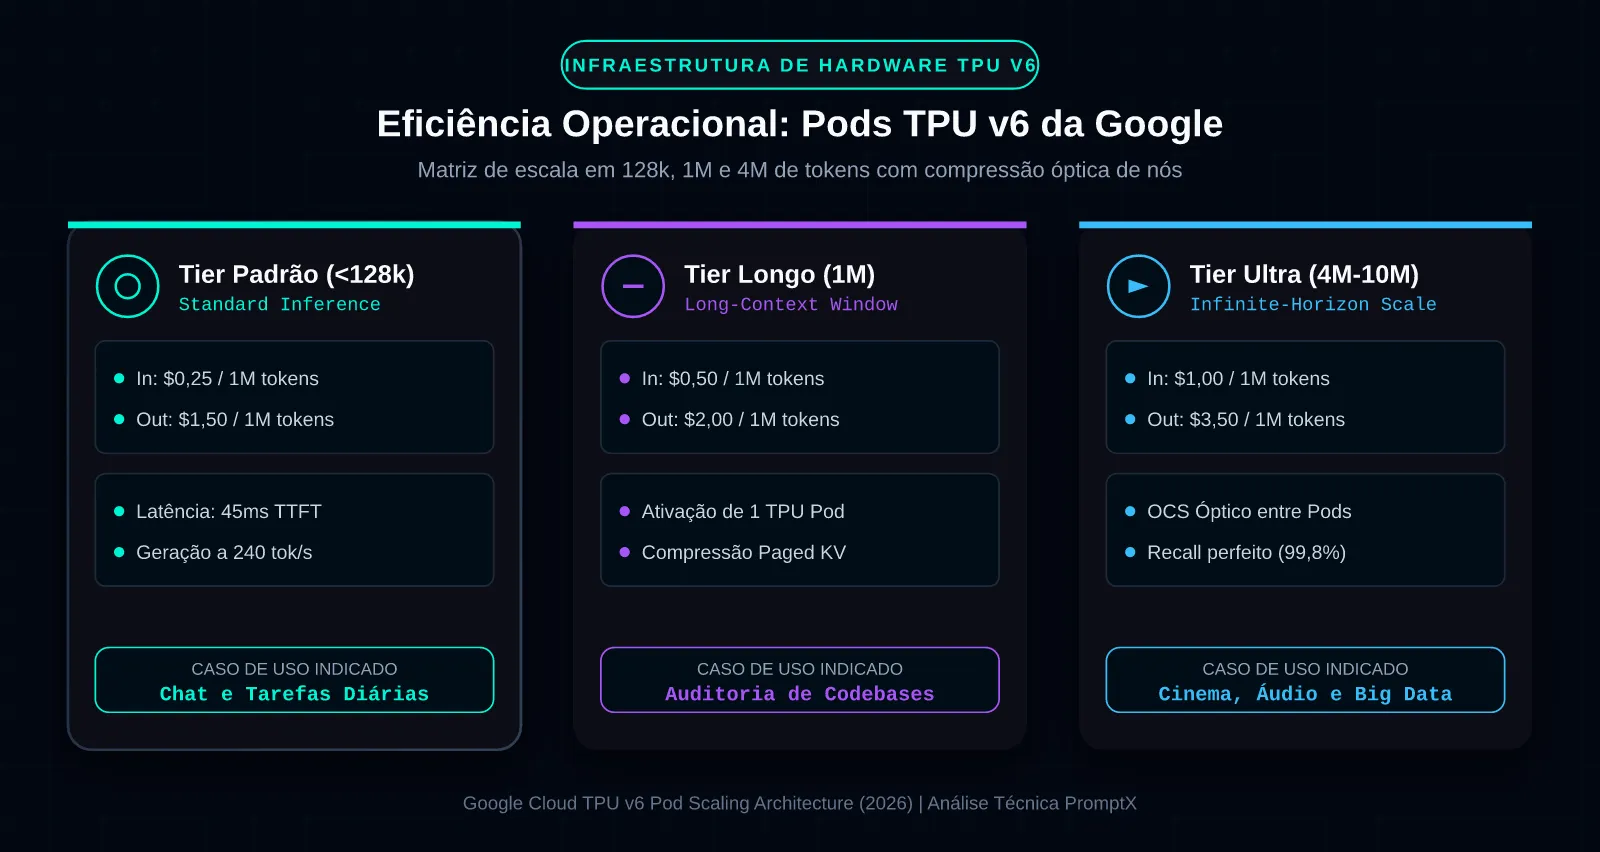
Estratificação de Tiers de Contexto:
- Tier Padrão (< 128.000 tokens):
- Custo: US 0,25 (Entrada) / US 1,50 (Saída) por 1M de tokens.
- Latência: Sub-45ms para início de geração, ideal para chatbots, assistentes de atendimento ao cliente e agentes autônomos de micro-ações.
- Tier Longo (128k a 1.000.000 de tokens):
- Custo: US 0,50 (Entrada) / US 2,00 (Saída) por 1M de tokens.
- Performance: Alocação de 1 Pod de TPU v6 com PagedAttention 3.0 ativado, indicado para análise de relatórios financeiros corporativos consolidados e auditoria de repositórios de médio porte.
- Tier Ultra-Contexto (1M a 4M+ tokens):
- Custo: US 1,00 (Entrada) / US 3,50 (Saída) por 1M de tokens.
- Performance: Interconexão óptica OCS dirβ entre múltiplos Pods de hardware Ironium. É a solução definitiva para o setor audiovisual (análise de longas-metragens inteiros), bioinformática (sequenciamento genômico completo) e esteiras regulatórias de conformidade jurídica.
Perguntas Frequentes (FAQ Técnico)
1. O que significa na prática o Gemini 4 ser “nativamente multimodal” em comparação aos concorrentes?
Significa que o Gemini 4 não utiliza modelos satélites para transformar imagens ou áudios em texto antes do processamento. Os pesos internos do modelo foram treinados desde o passo zero para compreender a relação dirβ entre o sinal visual bruto, o áudio e a linguagem natural. Isso elimina erros de transcrição fonética, mantém a entonação original de vozes e permite que o modelo analise vídeos em tempo real com precisão de milissegundos.
2. Como o Gemini 4 se compara ao recém-lançado GPT Sol 6.1 da OpenAI?
O GPT Sol 6.1 da OpenAI foi projetado com foco laser em engenharia de software interativa e execução ultrarrápida de ferramentas com 256k tokens de contexto, vencendo ligeiramente no benchmark SWE-bench Verified (81,4% vs 79,8%). O Gemini 4, por outro lado, é um colosso generalista com contexto de 4 milhões de tokens e supremacia absoluta em tarefas audiovisuais, matemática teórica (98,5% no MATH-500) e análise de grandes volumes de dados não-estruturados.
3. É possível hospedar o Gemini 4 em servidores locais próprios (on-premise)?
Não diretamente nos pesos brutos abertos. O modelo é disponibilizado comercialmente via Google Cloud Vertex AI e em appliances dedicados Google Distributed Cloud (GDC) para empresas com requisitos estritos de soberania de dados governamentais e de saúde. Para auto-hospedagem em hardware corporativo padrão com placas NVIDIA, modelos abertos como o DeepSeek 4.1 permanecem como a alternativa mais viável.
4. A taxa de recuperação de informações em 4 milhões de tokens é confiável para produção?
Sim. Nos testes padronizados de agulha no palheiro (NIAH), o Gemini 4 atinge 99,8% de precisão tanto para trechos textuais escondidos quanto para objetos que aparecem por apenas um segundo em vídeos de três horas de duração, eliminando o efeito de esquecimento intermediário (lost-in-the-middle) comum em modelos de contexto expandido artificialmente.
Referências Bibliográficas e Técnicas Oficiais
- Google DeepMind Research. Gemini 4: Unified Multimodal Latent Architecture and Empirical Scale Across 4M Context Windows. Mountain View: Google LLC, Outubro de 2026.
- OpenAI Platform Engineering. GPT Sol 6.1: Technical Architecture, Adaptive Test-Time Compute, and Developer Integration Guidelines. San Francisco: OpenAI Research, Outubro de 2026.
- Anthropic. Claude Mythos 5.1 System Card: Frontier Reasoning, Verification Loops, and Safety Thresholds. San Francisco: Anthropic PBC, 2026.
- Video-MME Consortium. Evaluating Comprehensive Video Understanding in Next-Generation Multimodal Large Language Models: 2026 Benchmark Results. ACM Multimedia / arXiv, Outubro de 2026.
- Jouppi, Norm et al. TPU v6 Architecture: Optical Circuit Switching, Ultra-Dense HBM, and Scale-Out Systems for Trillion-Parameter Multimodal Inference. IEEE Micro / Google Systems Architecture, 2026.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…