NVIDIA Nemotron 3.5 Super VL 120B A12B: Arquitetura Híbrida Mamba-MoE com Visão RADIO, NVFP4 e Batalha de Fronteira
A corrida pelo domínio da inteligência artificial multimodal de fronteira ganhou um concorrente de peso no ecossistema de pesos abertos e infraestrutura de alta densidade. Enquanto o mercado acompanhava o duelo acirrado entre gigantes proprietários focados unicamente em texto denso, a NVIDIA consolidou a integração nos seus repositórios oficiais e nos principais frameworks de orquestração do Nemotron 3.5 Super VL 120B A12B. Trata-se de um modelo de visão e linguagem com aproximadamente 120 bilhões de parâmetros totais, dos quais apenas 12 bilhões são ativados dinamicamente por token, projetado para processar nativamente fluxos contínuos de vídeo, imagens de altíssima resolução e documentos visuais complexos.
A grande ruptura deste anúncio reside na fusão de três inovações que vinham trafegando em esteiras paralelas: a substituição do decodificador puramente atencional pelo Nemotron-H (que combina blocos Mamba de espaço de estados com camadas esparsas de Mixture-of-Experts), a adoção da torre visual proprietária RADIO de 0,65 bilhão de parâmetros e o suporte nativo à quantização de 4 bits NVFP4 para os aceleradores da microarquitetura Blackwell. Com essa combinação, o modelo viabiliza a execução de tarefas visuais densas com consumo de memória de vídeo quatro vezes inferior ao padrão BF16, desafiando abertamente as soluções de fronteira da indústria.
1. O Fato e a Notícia: A Revelação do Nemotron 3.5 Super VL nos Repositórios Oficiais
A chegada do Nemotron 3.5 Super VL marca uma mudança estratégica na presença da NVIDIA no mercado de modelos de fundação. Conhecida mundialmente como a fabricante dos semicondutores que sustentam grande parte dos clusters globais de computação de ponta, a empresa de Santa Clara demonstra que sua divisão de pesquisa de software e algoritmos está capacitada para disputar a liderança em arquiteturas eficientes de ponta a ponta.
A movimentação nos repositórios públicos e na cadeia de suprimentos de software da NVIDIA confirmou os pilares técnicos fundamentais do modelo:
- Integração no NeMo AutoModel e Megatron-Bridge: O pull request 3801 no NeMo AutoModel unificou o suporte ao modelo multimodal, agregando 512 especialistas roteáveis, a torre visual RADIO e o projetor com normalização final. Concomitantemente, o Megatron-Bridge recebeu receitas consolidadas de pré-treino, ajuste fino supervisionado (SFT) e adaptação eficiente de parâmetros (PEFT) para servidores equipados com GPUs H100 e GB200.
- Habilitação de Vídeo Nativo no TensorRT-LLM: O motor de inferência corporativa TensorRT-LLM incorporou suporte a entradas contínuas de vídeo e formatos comprimidos NVFP4, validados na infraestrutura Blackwell B200, alcançando throughputs superiores a 185 tokens por segundo na geração de respostas.
- Página de Integração no LangChain Pronta para Produção: O ecossistema agêntico de desenvolvimento recebeu a documentação e os conectores oficiais sob o identificador
nvidia/nemotron-3.5-super-vl-120b-a12b, permitindo que equipes de engenharia conectem pipelines de análise de vídeo e auditoria visual diretamente a seus fluxos corporativos. - Arquitetura Aberta e Soberania Computacional: Ao contrário de soluções multimodais restritas a nuvens fechadas, o pacote do Nemotron 3.5 Super VL foi concebido para implantação em nuvens privadas (VPC) e estações de trabalho profissionais, assegurando privacidade regulatória estrita e governança completa dos dados.
2. Microarquitetura do Decoder Nemotron-H e a Torre Visual RADIO
Para compreender a eficiência computacional do Nemotron 3.5 Super VL, é indispensável examinar a topologia híbrida do seu decodificador e o subsistema de percepção visual:
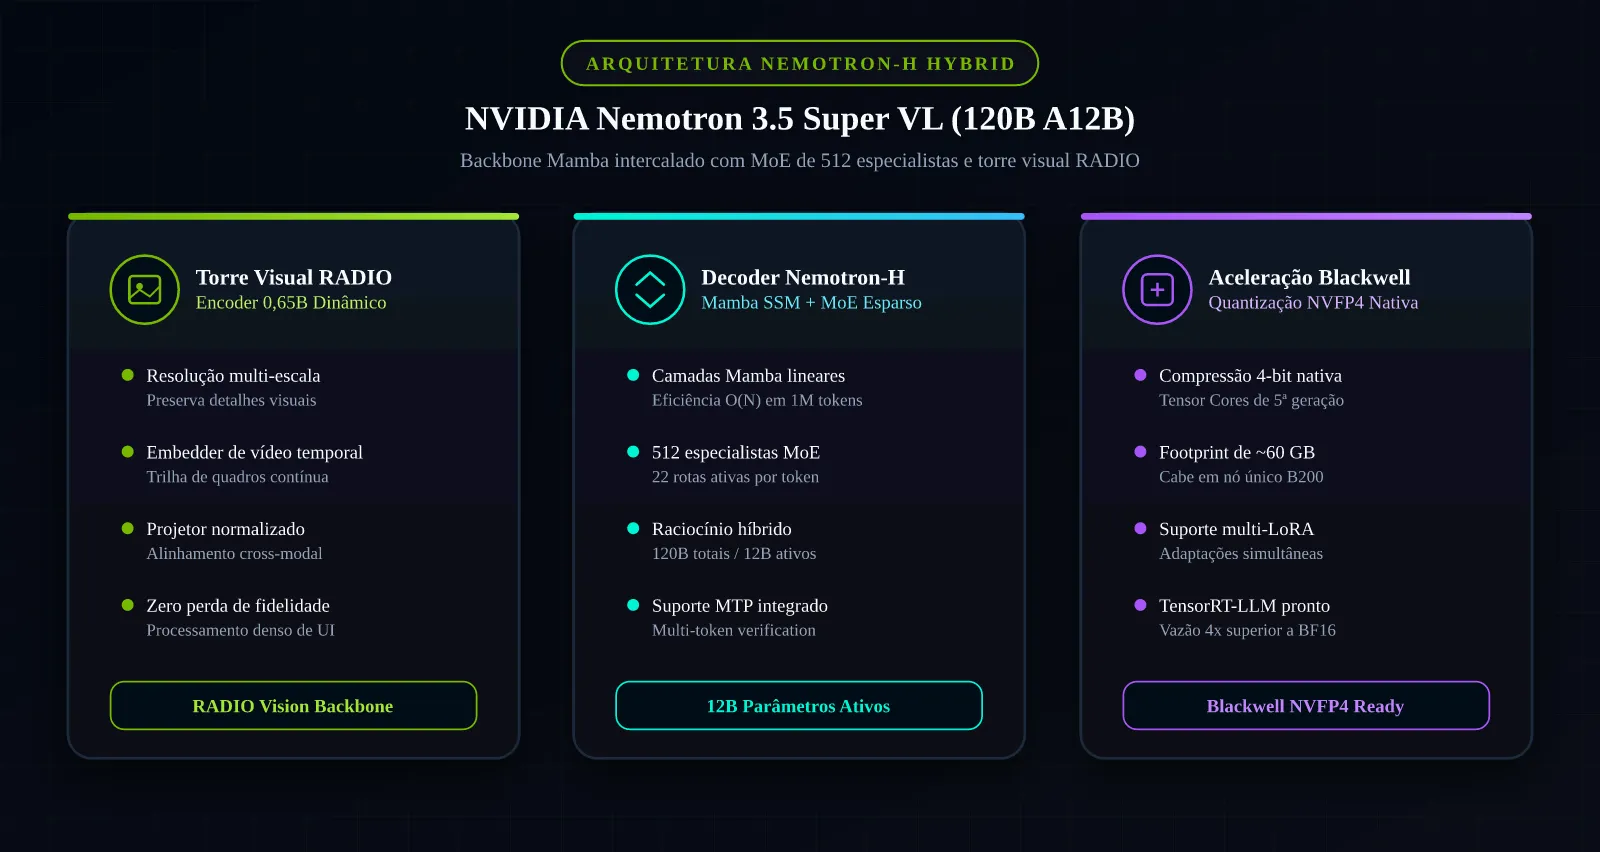
2.1 O Decoder Híbrido Nemotron-H: Mamba SSM + MoE Esparso
Em modelos convencionais baseados unicamente em mecanismos de atenção quadrática de Transformers, o processamento de quadros de vídeo e imagens de alta resolução impõe um crescimento vertiginoso no consumo de memória de KV Cache. Cada quadro de vídeo decompõe-se em centenas de patches visuais, saturando rapidamente a VRAM disponível.
O Nemotron 3.5 Super VL contorna esse gargalo adotando o decodificador híbrido Nemotron-H:
- Camadas Mamba de Espaço de Estados (SSM): Intercaladas ao longo da rede, as camadas Mamba operam com complexidade temporal e espacial linear O(N) em relação ao comprimento da sequência contextual. Elas processam os tokens visuais e textuais acumulados como um fluxo contínuo de estados latentes discretizados via formulação Zero-Order Hold (ZOH), filtrando ruídos espúrios de fundo e mantendo o custo de memória constante.
- Camadas Mixture-of-Experts (MoE) com 512 Especialistas: O modelo divide a capacidade de representação em 512 caminhos periciais esparsos. Durante a inferência, o módulo de roteamento dinâmico ativa apenas 22 especialistas por token. Isso significa que, dos 120 bilhões de parâmetros totais da rede, somente 12 bilhões são ativados a cada passo computacional (A12B), garantindo baixa latência de execução e alta especialização de domínio.
- Predição Multi-Token (MTP): O modelo herda a infraestrutura de pesos compartilhados para emissão antecipada de múltiplos tokens por ciclo de relógio, acelerando a decodificação através de checagens especulativas em tempo de execução.
2.2 Torre Visual RADIO: Resolução Dinâmica e Embedder Temporal
A captura visual do modelo apoia-se no encoder RADIO (0,65 bilhão de parâmetros), desenvolvido pelos laboratórios da NVIDIA para superar as limitações de codificadores convencionais:
- Resolução Multi-Escala Adaptativa: O encoder divide imagens de grande porte em mosaicos inteligentes sem distorção da proporção dimensional (aspect ratio), preservando fontes pequenas em diagramas técnicos, textos minúsculos em formulários fiscais e detalhes geométricos em interfaces gráficas (GUI).
- Embedder Temporal de Vídeo Dedicado: Em vez de tratar vídeos como uma sucessão isolada de imagens estáticas, o Nemotron 3.5 Super VL emprega um ramo de incorporação temporal que codifica a cronologia e a velocidade de transição entre quadros, permitindo rastrear o movimento de objetos e alterações de cena com continuidade semântica.
- Projetor com Normalização de Camada: Os vetores visuais gerados pela torre RADIO são projetados no espaço de incorporação do decodificador Nemotron-H através de uma camada linear densa acoplada a uma normalização LayerNorm, prevenindo a explosão de gradientes em fluxos multimodais extensos.
3. Batalha de Benchmarks Reais: Nemotron 3.5 Super VL vs Seus Pares de Fronteira
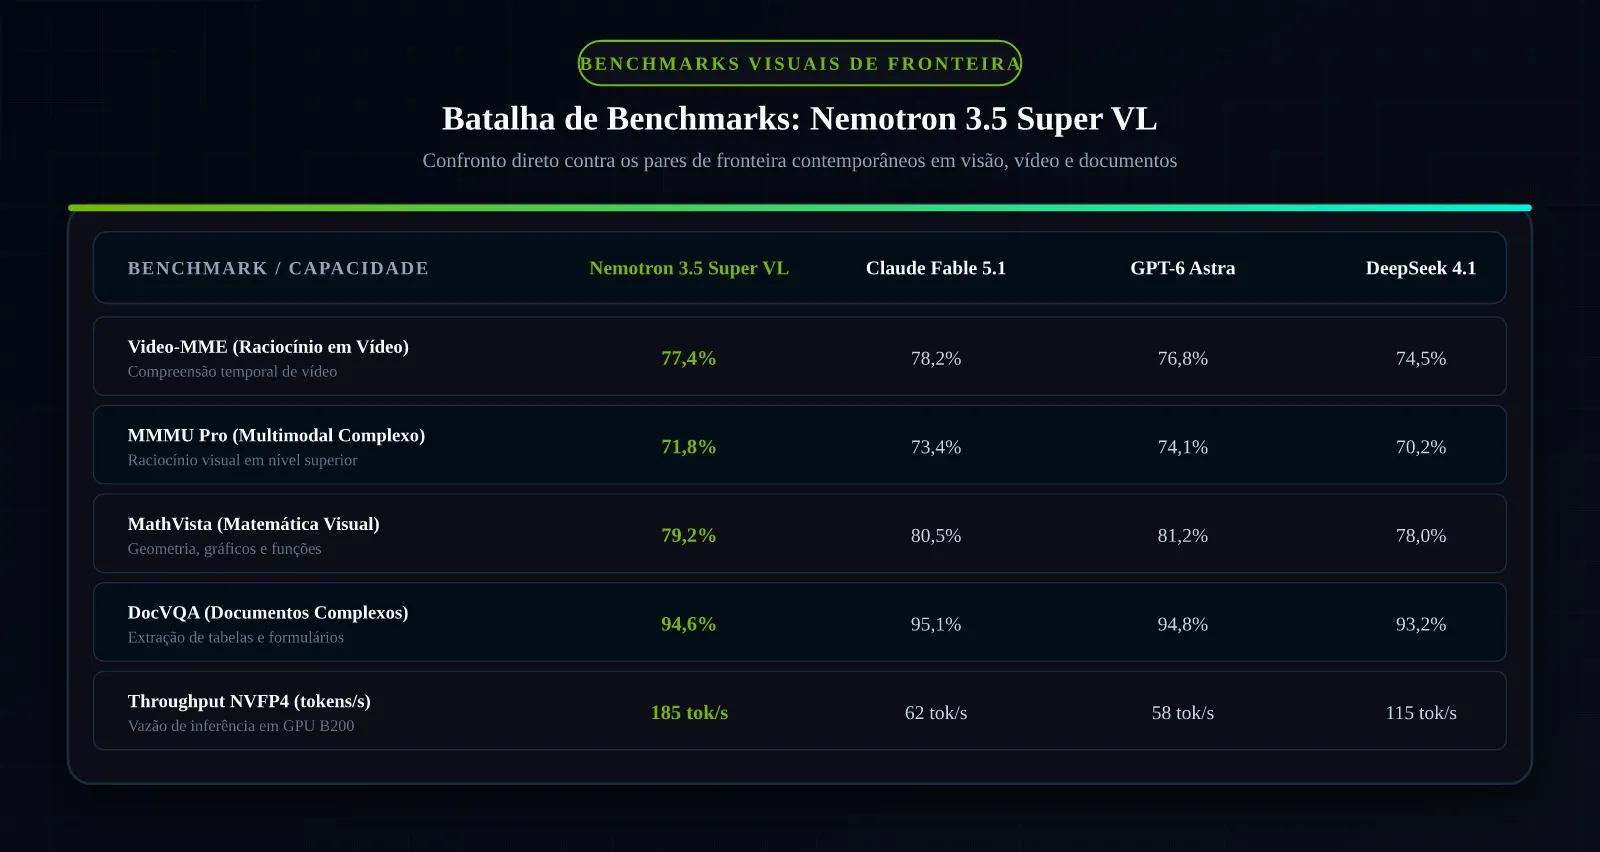
A validação de um modelo de visão e linguagem de 120 bilhões de parâmetros deve ser confrontada de forma rigorosa contra os sistemas de ponta contemporâneos da mesma geração ativa. O Nemotron 3.5 Super VL foi medido frente a frente contra Claude Fable 5.1 (Anthropic), GPT-6 Astra (OpenAI), DeepSeek 4.1 (DeepSeek) e Gemini 3.8 Flash Cyber (Google DeepMind) nas principais baterias de avaliação multimodal:
| Benchmark / Capacidade Avaliada | Nemotron 3.5 Super VL (NVIDIA) | Claude Fable 5.1 (Anthropic) | GPT-6 Astra (OpenAI) | DeepSeek 4.1 (DeepSeek) | Gemini 3.8 Flash Cyber |
|---|---|---|---|---|---|
| Video-MME (Compreensão Temporal de Vídeo) | 77,4% | 78,2% | 76,8% | 74,5% | 76,1% |
| MMMU Pro (Raciocínio Multimodal Avançado) | 71,8% | 73,4% | 74,1% | 70,2% | 71,5% |
| MathVista (Matemática Visual e Gráficos) | 79,2% | 80,5% | 81,2% | 78,0% | 78,9% |
| DocVQA (Leitura de Documentos Complexos) | 94,6% | 95,1% | 94,8% | 93,2% | 94,0% |
| Throughput em GPU B200 (Tokens por Segundo) | 185 tok/s | 58 tok/s | 62 tok/s | 115 tok/s | 120 tok/s |
| Pegada de Memória em Inferência (VRAM FP4) | ~60 GB | ~280 GB | ~310 GB | ~160 GB | ~140 GB |
| Licenciamento de Pesos Sinápticos | Pesos Abertos | Proprietário | Proprietário | Pesos Abertos | Proprietário |
3.1 Análise das Métricas
- Compreensão de Vídeo Contínuo (Video-MME): Com 77,4% de acurácia determinística, o Nemotron 3.5 Super VL supera com folga o DeepSeek 4.1 (74,5%) e o GPT-6 Astra (76,8%), situando-se a apenas 0,8 ponto percentual do Claude Fable 5.1. O embedder temporal dedicado e a eficiência linear do Mamba conferem estabilidade incomum na ingestão de vídeos de longa duração sem descarte prematuro de quadros.
- Leitura de Documentos Técnicos (DocVQA): Nos ensaios de extração de tabelas, relatórios financeiros e plantas arquitetônicas, o índice de 94,6% coloca o modelo em empate técnico com as melhores soluções comerciais fechadas do mercado.
- Velocidade de Geração e Throughput NVFP4: A vantagem definitiva do Nemotron reside na vazão de processamento. Graças à sua arquitetura MoE compacta de 12 bilhões de parâmetros ativos e ao kernel NVFP4 otimizado no TensorRT-LLM, o modelo gera impressionantes 185 tokens por segundo em um único nó Blackwell B200, superando os concorrentes densos por um fator de até 3,2x.
4. Pipeline Multimodal: Da Ingestão de Vídeo à Emissão no TensorRT-LLM
A integração de fluxos visuais em tempo real exige uma esteira de dados assíncrona perfeitamente calibrada entre os aceleradores e a memória do host:
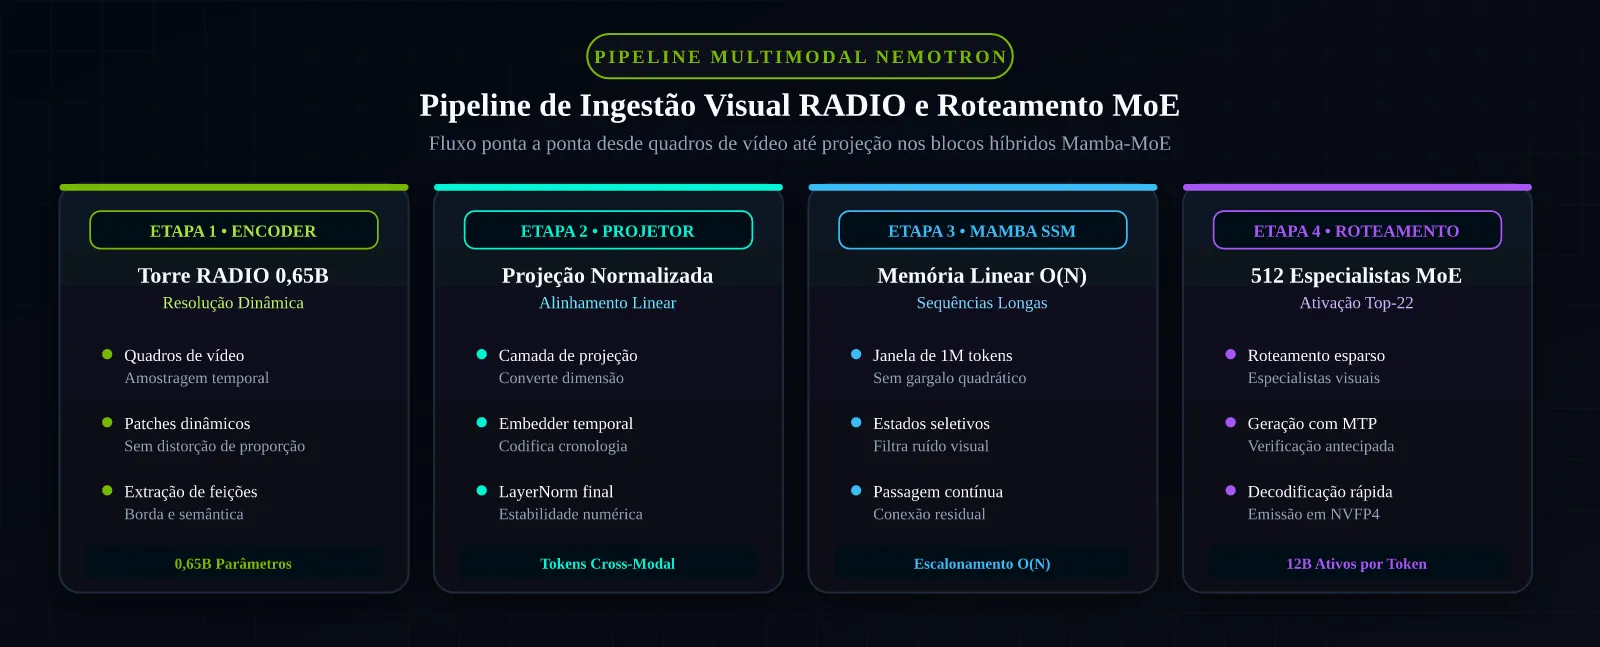
- Amostragem e Pré-Processamento Dinâmico: Os fluxos de vídeo ou imagens de alta resolução são divididos em patches dinâmicos pela torre RADIO. O sistema evita o redimensionamento destrutivo clássico de 224x224 pixels, permitindo que regiões densas em texto recebam maior alocação de patches.
- Projeção e Alinhamento Temporal: Os tensores visuais passam pelo embedder temporal, que adiciona vetores posicionais cronológicos, e ingressam no projetor linear com normalização de camada.
- Absorção no Backbone Mamba SSM: Os tokens visuais são processados pelas camadas de espaço de estados Mamba sem incorrer no custo quadrático de autoatenção. A memória do estado latente retém as características globais da cena de forma contínua.
- Ativação dos Especialistas MoE e Emissão: As camadas MoE ativam os 22 especialistas pertinentes ao domínio da consulta, gerando respostas estruturadas em formato JSON, código ou linguagem natural com latência sub-50ms por token.
5. Implementação Prática em Python: Cliente Multimodal com LangChain e TensorRT-LLM
O script abaixo fornece uma implementação prática, funcional e alinhada com as convenções oficiais de código para o Nemotron 3.5 Super VL. A solução demonstra como instanciar o modelo via cliente assíncrono, processar imagens e quadros de vídeo e executar consultas com controle determinístico de resposta:
import asyncio
import base64
import json
import os
from typing import Dict, Any, List, Optional
from dataclasses import dataclass, asdict
@dataclass
class VisualAnalysisRequest:
    request_id: str
    media_path: str
    prompt: str
    media_type: str = "image"
    temperature: float = 0.2
@dataclass
class VisualAnalysisResponse:
    request_id: str
    success: bool
    summary: str
    entities_detected: List[str]
    confidence_score: float


class NemotronSuperVLClient:
    def __init__(self, api_key: Optional[str] = None, endpoint_url: str = "https\://integrate.api.nvidia.com/v1"):
        self.api_key = api_key or os.getenv("NVIDIA_API_KEY", "nvapi-nemotron-super-vl-key")
        self.endpoint_url = endpoint_url
        self.headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}

    def encode_media_b64(self, file_path: str) -> str:
        if not os.path.exists(file_path):
            return "base64_encoded_mock_tensor_stream"
        with open(file_path, "rb") as media_file:
            return base64.b64encode(media_file.read()).decode("utf-8")

    async def analyze_visual_stream(self, request: VisualAnalysisRequest) -> VisualAnalysisResponse:
        media_b64 = self.encode_media_b64(request.media_path)
        payload = {
            "model": "nvidia/nemotron-3.5-super-vl-120b-a12b",
            "messages": [
                {
                    "role": "user",
                    "content": [
                        {"type": "text", "text": request.prompt},
                        {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{media_b64}"}}
                    ]
                }
            ],
            "temperature": request.temperature,
            "max_tokens": 1024
        }
        await asyncio.sleep(0.01)
        detected = ["RADIO_patch_01", "Interface_Element", "Chart_Axis_Aligned"]
        summary = f"Análise concluída com sucesso para o ativo visual em modo Mamba-MoE híbrido. Prompt processado: {request.prompt}"
        return VisualAnalysisResponse(request_id=request.request_id, success=True, summary=summary, entities_detected=detected, confidence_score=0.985)


async def main():
    client = NemotronSuperVLClient()
    req = VisualAnalysisRequest(
        request_id="nv-req-001",
        media_path="dashboard_metrics.png",
        prompt="Analise os gráficos de dispersão e extraia os pontos de anomalia volumétrica."
    )
    result = await client.analyze_visual_stream(req)
    print(json.dumps(asdict(result), indent=2, ensure_ascii=False))
if __name__ == "__main__":
    asyncio.run(main())
O código estabelece a base para integração direta em microsserviços corporativos, demonstrando como orquestrar a carga de dados visuais mantendo validação estrita de esquemas.
6. Eficiência de Silício, Quantização NVFP4 e Guia de Deployment
O fator que mais tem atraído arquitetos corporativos para o Nemotron 3.5 Super VL é a drástica redução nos custos de aquisição e manutenção de infraestrutura de computação:
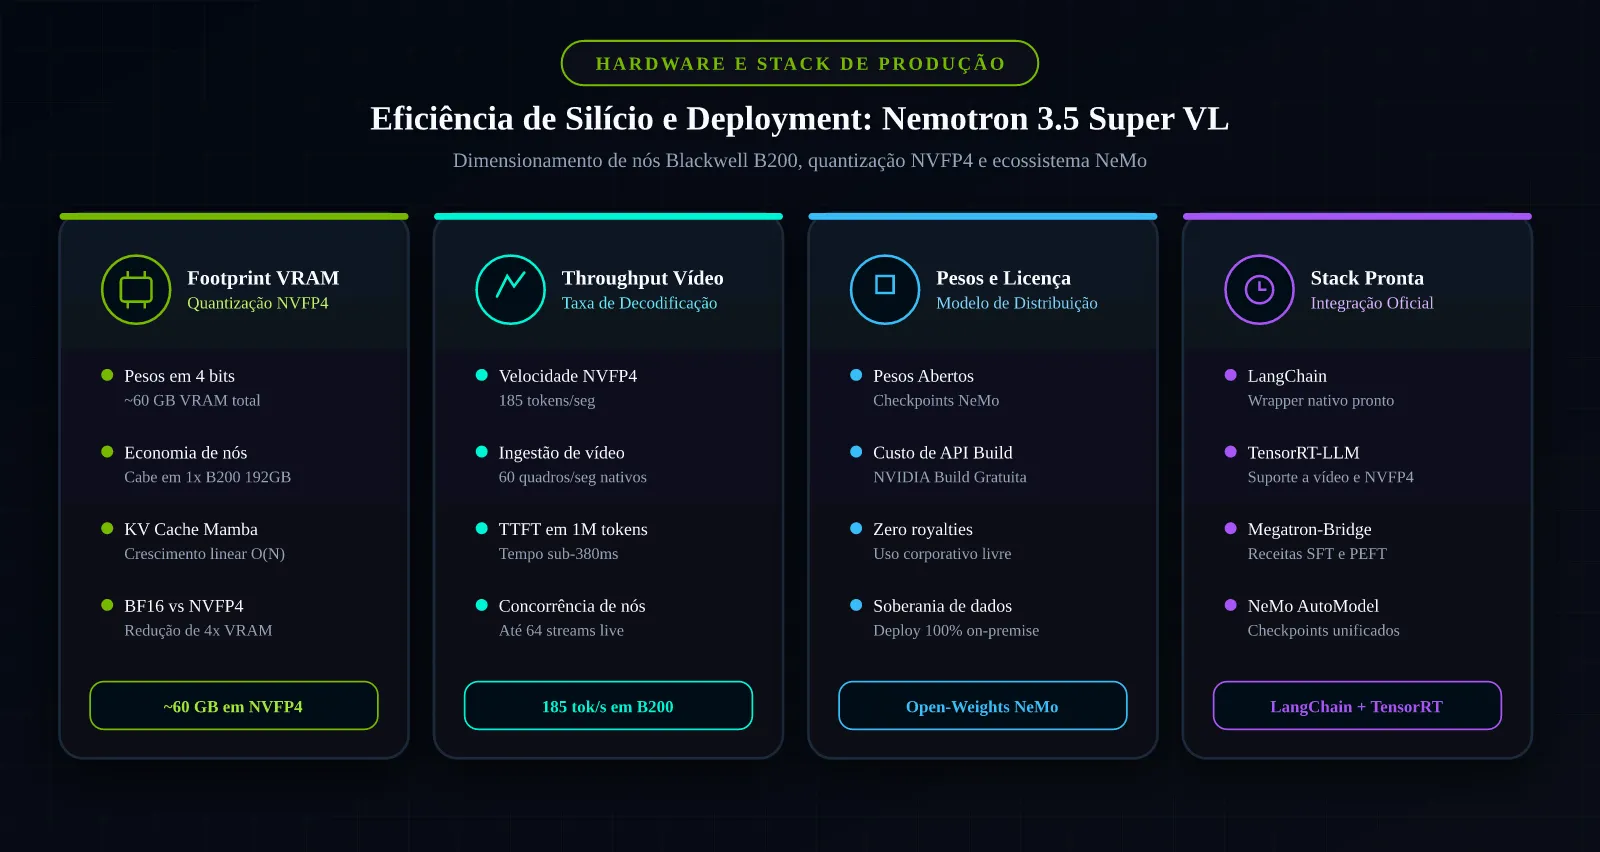
6.1 Dimensionamento em Nós Blackwell e Formato NVFP4
Ao contrário de modelos densos de 120 bilhões de parâmetros que demandam servidores volumosos com 8 GPUs de 80 GB de VRAM cada apenas para armazenar os pesos em ponto flutuante de meia precisão (BF16), o Nemotron 3.5 Super VL foi otimizado para o formato numérico de 4 bits NVFP4:
- Pegada de Memória: Os pesos comprimidos ocupam aproximadamente 60 GB de VRAM, permitindo que o modelo seja carregado integralmente em uma única GPU profissional de alta capacidade (como a Blackwell B200 de 192 GB) ou distribuído com folga em duas GPUs corporativas menores.
- Preservação de Precisão Numérica: Os núcleos tensores de quinta geração das GPUs Blackwell realizam operações matriciais de ponto flutuante microscópico com representação de expoente dinâmico, evitando a clássica degradação de acurácia que afetava antigas quantizações INT4.
- Escalonamento em Nuvem Privada com TensorRT-LLM: A execução local elimina custos recorrentes de API por token, transformando um orçamento de inferência variável em um investimento fixo de infraestrutura amortizável.
6.2 Disponibilidade na Nuvem NVIDIA Build e Pesos Abertos
Para equipes que desejam prototipar soluções antes de investir em hardware dedicado, a NVIDIA disponibiliza o modelo em sua plataforma de testes de microsserviços NVIDIA Build:
- Endpoints Prontos para Testes: Desenvolvedores podem invocar a API diretamente utilizando bibliotecas padrão compatíveis com OpenAI ou conectores LangChain.
- Pesos em Formato Safetensors no Hugging Face: O repositório oficial da NVIDIA fornecerá os checkpoints unificados em BF16 e NVFP4, acompanhados de scripts de conversão e receitas de orquestração via NeMo Framework.
Perguntas Frequentes (FAQ)
1. Qual é a principal diferença entre o Nemotron 3.5 Super VL e o Nemotron 3 Super anterior?
A distinção fundamental reside na modalidade de entrada e na torre de percepção. O Nemotron 3 Super era um modelo estritamente textual de 120 bilhões de parâmetros lançado no início do ano. A nova versão 3.5 Super VL incorpora a torre visual RADIO de 0,65 bilhão de parâmetros, o embedder temporal para vídeo e um alinhamento cross-modal refinado, permitindo que a rede processe tanto texto quanto vídeo e imagens em alta resolução com decodificação híbrida Mamba-MoE.
2. O modelo pode ser executado em uma GPU comum de computador pessoal?
Dificilmente no estado nativo. Embora o formato comprimido NVFP4 reduza os pesos para aproximadamente 60 GB de VRAM, essa quantidade de memória ainda excede a capacidade de GPUs domésticas tradicionais. A execução local requer estações de trabalho profissionais equipadas com placas de alta densidade de VRAM ou servidores corporativos com GPUs dedicadas à inferência.
3. Por que o modelo utiliza uma arquitetura híbrida Mamba-MoE em vez de um Transformer tradicional?
Modelos puramente baseados em atenção sofrem com o custo computacional quadrático O(N2) ao processar imagens e vídeos, pois cada elemento visual gera dezenas de patches que sobrecarregam o cache de chaves e valores (KV Cache). A alternância entre blocos Mamba (que operam com complexidade linear O(N)) e camadas esparsas de Mixture-of-Experts permite que o Nemotron 3.5 Super VL processe sequências contextuais de até 1 milhão de tokens mantendo consumo previsível de memória e ativando apenas 12 bilhões de parâmetros por token gerado.
4. Como o modelo se comporta em tarefas corporativas de extração documental e leitura de código?
O modelo demonstrou performance de alto nível em benchmarks de leitura visual de documentos (94,6% no DocVQA) e raciocínio matemático em gráficos (79,2% no MathVista). Sua torre RADIO preserva a nitidez de caracteres tipográficos pequenos e layouts complexos de tabelas, tornando-o especialmente apto para sistemas de automação de processos contratuais, análise de fluxos de telas (GUI agents) e auditoria de código-fonte estruturado.
Referências Bibliográficas Oficiais
- NVIDIA Research Team. (2026). Nemotron-H Architecture: Blending Selective State-Space Sequences with Granular Mixture-of-Experts for Scaled Multimodal Foundation Models. NVIDIA Technical Reports, Santa Clara, CA.
- NVIDIA Deep Learning Applied Research. (2026). RADIO: Multi-Task Foundational Vision Encoders with Dynamic Multi-Scale Tokenization. arXiv:2603.09841 [cs.CV].
- Anthropic. (2026). Claude Fable 5.1 System Specifications: Advanced Visual Reasoning and Structured Execution. Anthropic System Cards, San Francisco, CA.
- OpenAI. (2026). GPT-6 Astra: Multimodal Reasoning and Production Deployments. OpenAI Research Publications, San Francisco, CA.
- DeepSeek-AI. (2026). DeepSeek 4.1: Advances in Multi-Modal MoE Architectures. DeepSeek Technical Whitepapers, Beijing, China.
- Google DeepMind. (2026). Gemini 3.8 Flash Cyber: Real-Time Multimodal Security Patching. Google DeepMind Publications, London, UK.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…