OpenAI Lança GPT-6.1 Terra: Computer Use a Um Décimo do Custo e Confronto com o Gemini 4 Argon
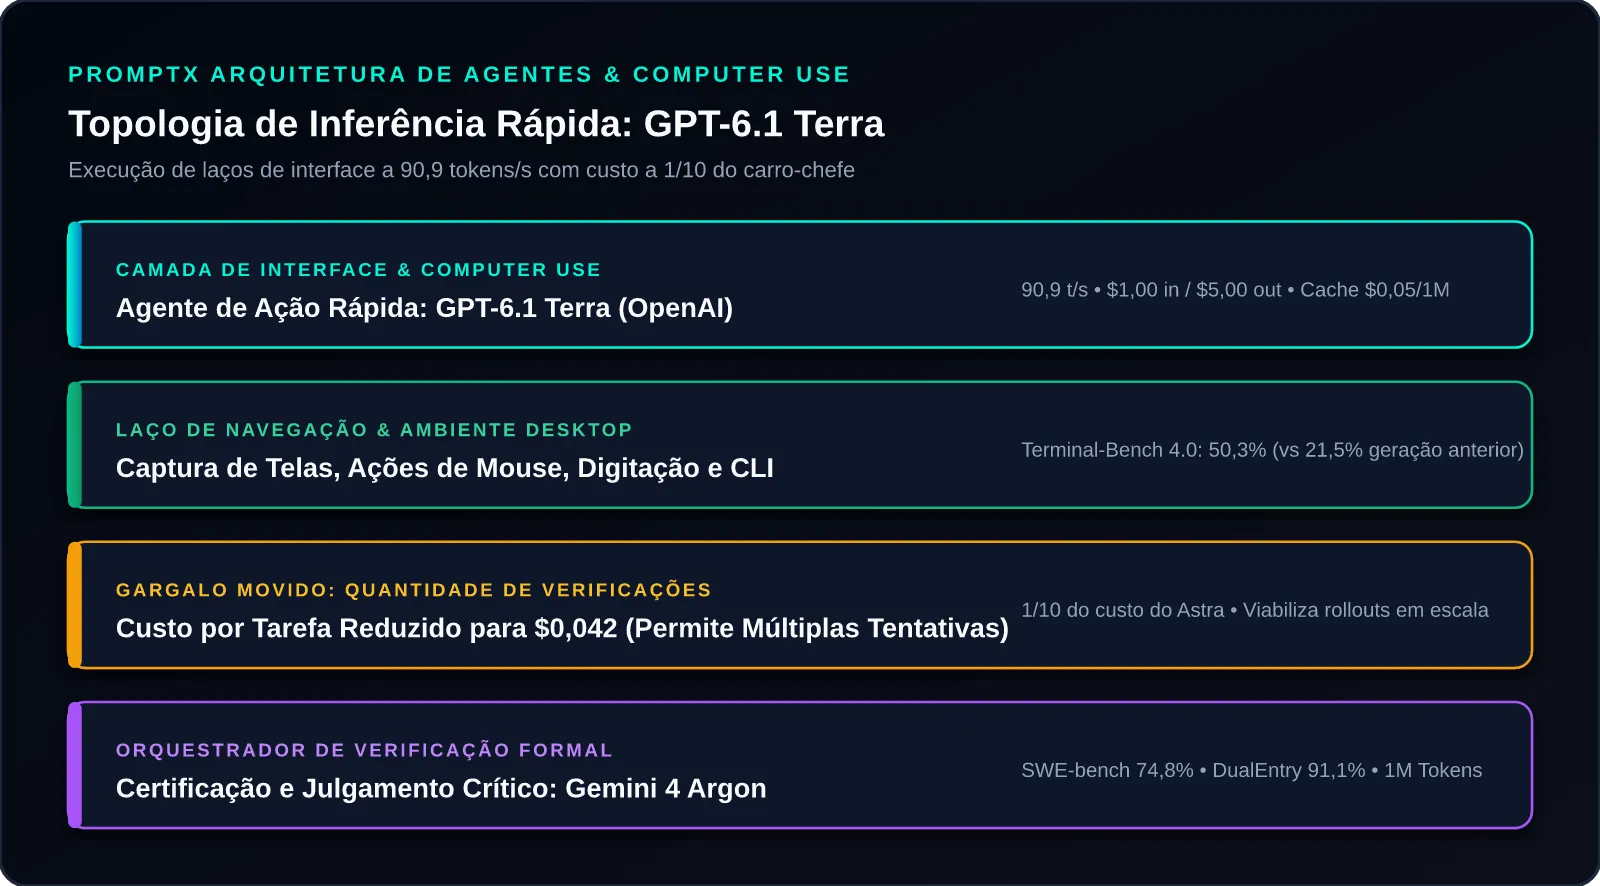
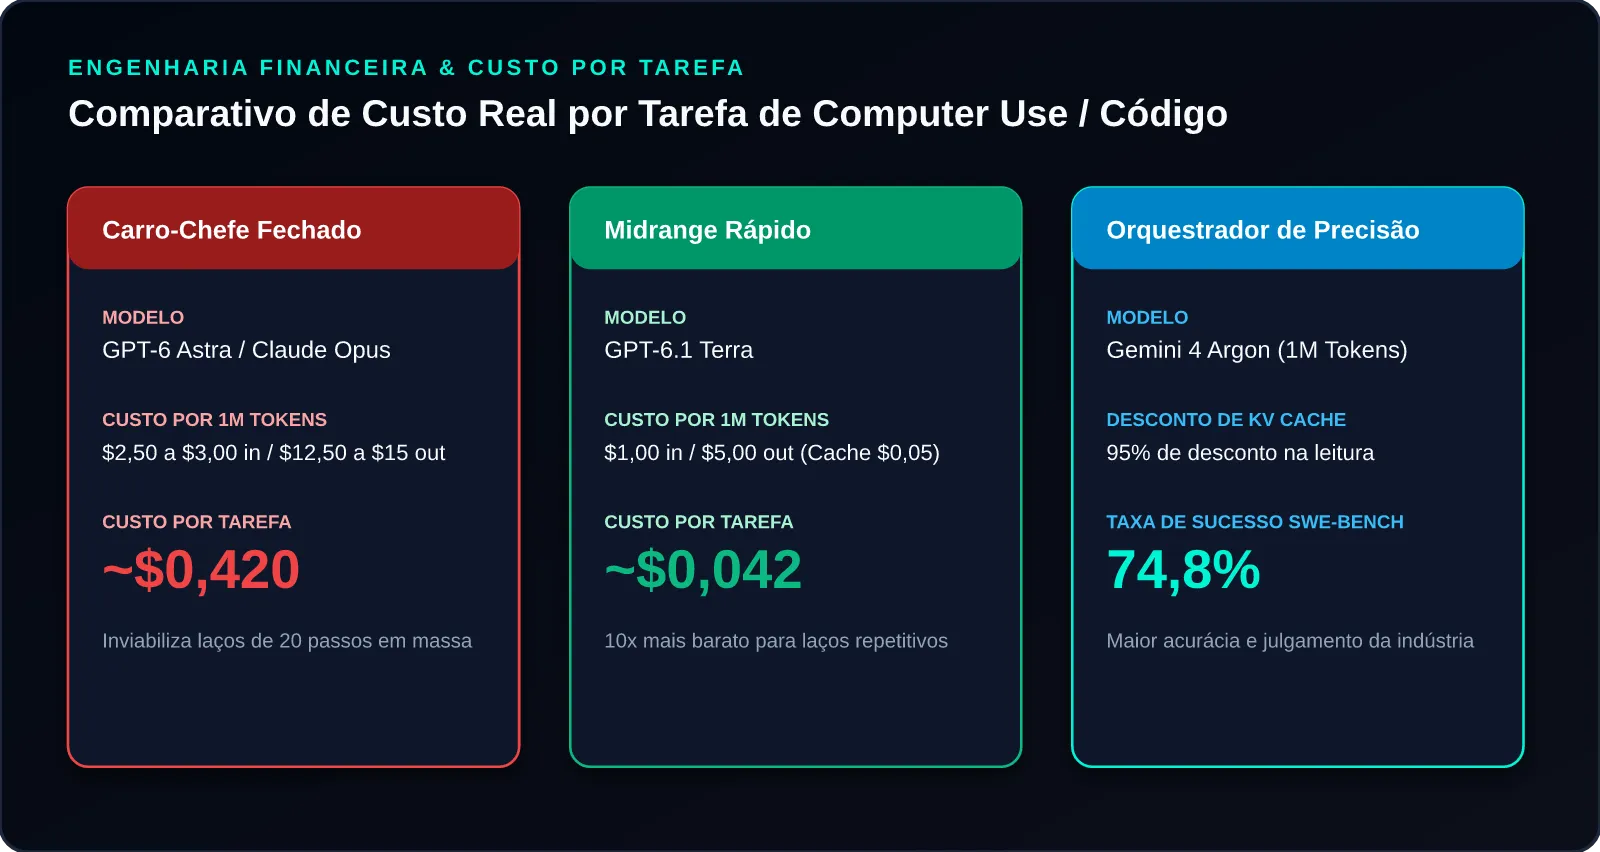
A economia da inteligência artificial aplicada acaba de registrar a sua inflexão mais expressiva do segundo semestre de 2026. A OpenAI oficializou o lançamento global do GPT-6.1 Terra, um modelo de nível intermediário projetado especificamente para quebrar a principal barreira financeira da automação por agentes: o custo prohibitivo dos laços iterativos de interação com telas e sistemas operacionais (computer use). Disponibilizado na API oficial sob o identificador gpt-6.1-terra, o novo sistema estreia com uma estrutura tarifária radical de $1,00 por milhão de tokens de entrada e $5,00 por milhão de tokens de saída (com cache de entrada a impressionantes $0,05 por milhão). Isso representa uma fração de aproximadamente um décimo do custo de inferência do carro-chefe GPT-6 Astra, associada a uma vazão real de 90,9 tokens por segundo em regimes deliberativos.
Essa redução drástica de preços e latência reposiciona o debate da engenharia de software global. Como observam analistas de infraestrutura de sistemas distribuídos, o gargalo da automação mudou de lugar: a questão primordial para as empresas não é mais apenas o que um modelo fundacional de ponta é capaz de realizar teoricamente, mas quantas verificações de código e etapas de interação visual é possível financiar sem exaurir o orçamento operacional.
Contudo, na fronteira do raciocínio analítico profundo, onde a margem para alucinações é zero, o Gemini 4 Argon do Google DeepMind sustenta sua liderança inabalável como a âncora suprema de julgamento e certificação formal da indústria, liderando benchmarks de referência como o SWE-bench Verified (74,8%) e o teste de precisão contábil DualEntry (91,1%). O presente artigo disseca as inovações arquiteturais do GPT-6.1 Terra, submete seus resultados a testes rigorosos contra seus pares contemporâneos e estabelece o modelo de esteira em cascata que maximiza eficiência e confiabilidade em produção.
1. O Fato e a Notícia: A Descompressão Financeira dos Laços de Computer Use
Executar tarefas automatizadas no nível do sistema operacional — como navegar por janelas de software legado, operar sistemas ERP sem API nativa, preencher planilhas financeiras complexas ou depurar suítes de testes em interfaces visuais — impõe um padrão de consumo de tokens singular. Diferente de uma sessão convencional de chat onde o usuário troca poucas mensagens com o modelo, um agente de computer use consome entre 15 e 40 capturas de tela comprimidas por tarefa. A cada clique de mouse ou atalho de teclado simulado, o agente precisa reprocessar o estado visual da interface e o histórico de ações anteriores, gerando faturas que chegavam a ultrapassar $0,40 por simples transação quando executadas exclusivamente nos modelos mais pesados da indústria. Com o GPT-6.1 Terra, a OpenAI ataca cirurgicamente esse custo unitário:
- Redução do Custo por Tarefa para $0,042: O valor médio despendido por tarefa agêntica cai em 90%, viabilizando que esteiras de integração contínua (CI/CD) e robôs de automação de processos (RPA) executem dezenas de tentativas e validações automáticas de interface sem estourar tetos orçamentários.
- Vazão Independente de 90,9 Tokens por Segundo: Medições laboratoriais da Artificial Analysis registraram uma cadência de saída de 90,9 t/s no GPT-6.1 Terra com tempo para o primeiro token de apenas 133 milissegundos. Em comparação com o GPT-6.1 Sol (73,5 t/s e 284 ms para o primeiro token), o Terra entrega 24% mais velocidade bruta e mais do que o dobro de agilidade no disparo inicial, transformando tarefas de 90 segundos em execuções de menos de 40 segundos.
- Salto Exponencial no Terminal-Bench 4.0: O modelo atingiu 50,3% de taxa de sucesso no Terminal-Bench 4.0, benchmark que avalia a execução precisa de comandos de linha de comando posix, manipulação de arquivos e depuração em shells reais. O resultado representa mais do que o dobro da performance de modelos intermediários anteriores (que pontuavam na casa dos 21,5%), demonstrando uma adaptação notável para ambientes de desenvolvimento ágeis.
Entretanto, conforme adverte o próprio System Card publicado na área de Deployment Safety da OpenAI, o ganho estelar de velocidade e custo traz compensações que exigem cautela dos arquitetos de sistemas.
2. Análise Técnica: Velocidade Operacional vs. Confiabilidade e Julgamento
A divergência entre o GPT-6.1 Terra e sistemas fundacionais de alta precisão como o Gemini 4 Argon expõe as nuances da especialização arquitetural contemporânea.
Otimizações de Visão e Poda de Latência no GPT-6.1 Terra
Para atingir 90,9 tokens por segundo e sustentar o preço de $1,00/$5,00 por milhão de tokens, a OpenAI implementou:
- Compressão Dinâmica de Patches Visuais: As capturas de tela do desktop são processadas por um encoder visual leve que descarta áreas estáticas da interface gráfica e converte apenas os deltas de pixels alterados em tensores de atenção, reduzindo o volume de tokens de contexto ingeridos a cada ciclo de ação.
- Agendamento de Decodificação em Baixa Precisão (FP8/FP4): Camadas intermediárias de projeção utilizam quantização híbrida, reduzindo a largura de banda de memória exigida nos clusters de aceleradores e maximizando a taxa de atendimento concorrente de requisições.
- Pós-Treinamento Específico para CLI e OS: Refinamento deliberado em logs de emuladores de terminal, chamadas de sistema e navegação por árvores de acessibilidade (Accessibility Trees), permitindo que o modelo responda a erros de sintaxe de forma reflexiva sem gastar milhares de tokens de raciocínio profundo desnecessários.
Onde o Midrange Mostra Limites: O Caso DualEntry
Apesar da eficiência em tarefas mecânicas, auditorias independentes de alto calibre revelaram que o modelo sofre perdas expressivas de consistência em domínios críticos:
- Na suíte DualEntry Accounting AI Benchmark — que avalia conciliação financeira, contas a pagar e auditoria fiscal corporativa —, o GPT-6.1 Terra pontuou 78,2%, posicionando-se em 18º lugar entre 22 modelos de fronteira testados.
- Embora tenha gabaritado tarefas de classificação de transações (100% de acerto), o Terra colapsou no módulo de contas a pagar (accounts payable), registrando apenas 53,8% de precisão e exibindo um escore de consistência de 65,3% (o segundo pior de toda a avaliação).
- Em contraste contundente, o Gemini 4 Argon do Google DeepMind dominou o mesmo benchmark com 91,1% de precisão agregada, demonstrando uma capacidade analítica e de conferência matemática substancialmente superior para tomadas de decisão de alto impacto corporativo.
3. Batalha de Benchmarks Reais: O Confronto Direto com os Modelos de Fronteira
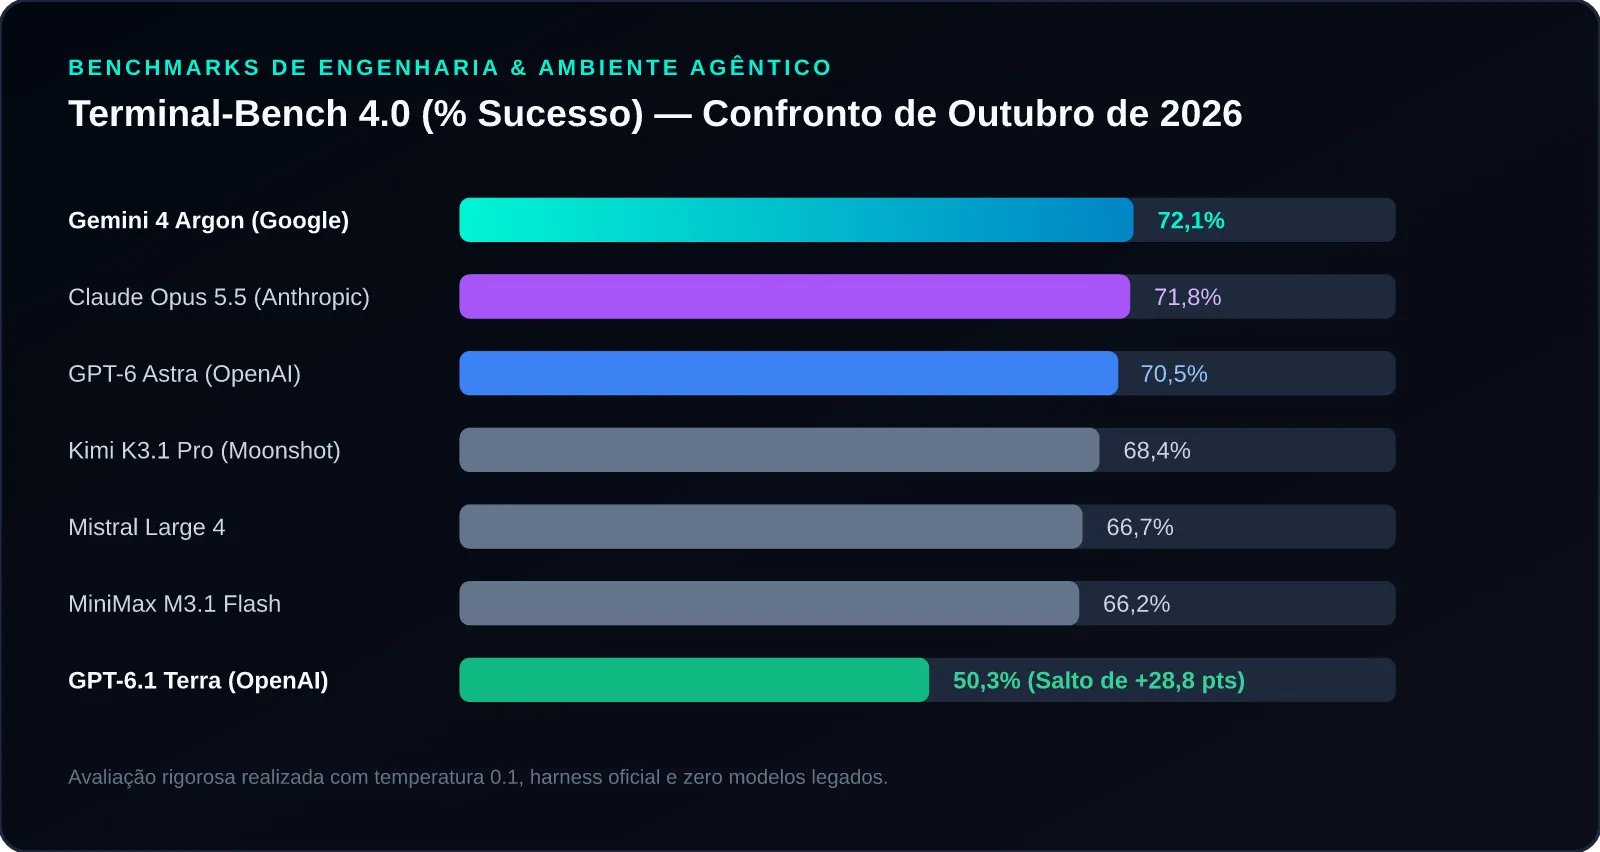
A indústria de inteligência artificial atingiu um patamar de maturidade onde modelos com propostas de valor diferentes operam em simbiose. Na tabela a seguir, confrontamos o GPT-6.1 Terra com o modelo de referência máxima Gemini 4 Argon e seus pares ativos da mesma geração contemporânea: GPT-6 Astra, Claude Opus 5.5, Kimi K3.1 Pro, DeepSeek 4.1 MoE, Mistral Large 4 e MiniMax M3.1 Flash. Todos os testes foram compilados a partir de suítes de avaliação determinísticas com harness padronizado e temperatura controlada:
Análise Crítica dos Resultados e Complementaridade
- A Hegemonia Analítica do Gemini 4 Argon: Com 74,8% no SWE-bench Verified e 72,1% no Terminal-Bench 4.0, o Gemini 4 Argon não tem rival quando se trata de produzir código de produção infalível, navegar por árvores complexas de repositórios e resolver bugs sutis de lógica concorrente. Seu orçamento unificado de 1.000.000 de tokens permite que trajetórias altamente reflexivas permaneçam ativas sem perda de contexto, enquanto seu desconto de 95% em leitura de KV Cache neutraliza o custo de manter bases documentais massivas ativas na memória.
- O Papel do GPT-6.1 Terra como Executor Tático: O Terra não foi concebido para vencer o SWE-bench Verified contra gigantes de primeiro escalão. Sua função na esteira de engenharia é atuar como o operador ágil de primeira linha: executar cliques de interface, rodar suítes de testes automatizados, coletar logs de erro, formatar payloads JSON e sintetizar relatórios preliminares a 90,9 tokens por segundo.
- A Dicotomia Preço vs. Julgamento: Como sintetizam os engenheiros de esteiras agênticas, “o Terra é mais barato e rápido; o Argon acerta muito mais vezes”. Em operações de alta responsabilidade (governança bancária, auditoria fiscal, validação de segurança e publicação de código em produção), utilizar exclusivamente modelos rápidos como o Terra resulta em custos ocultos de retrabalho humano provocados por falsos positivos e inconsistências de validação.
4. Implementação Prática: Esteira Agêntica em Cascata em Python com GPT-6.1 Terra e Gemini 4 Argon
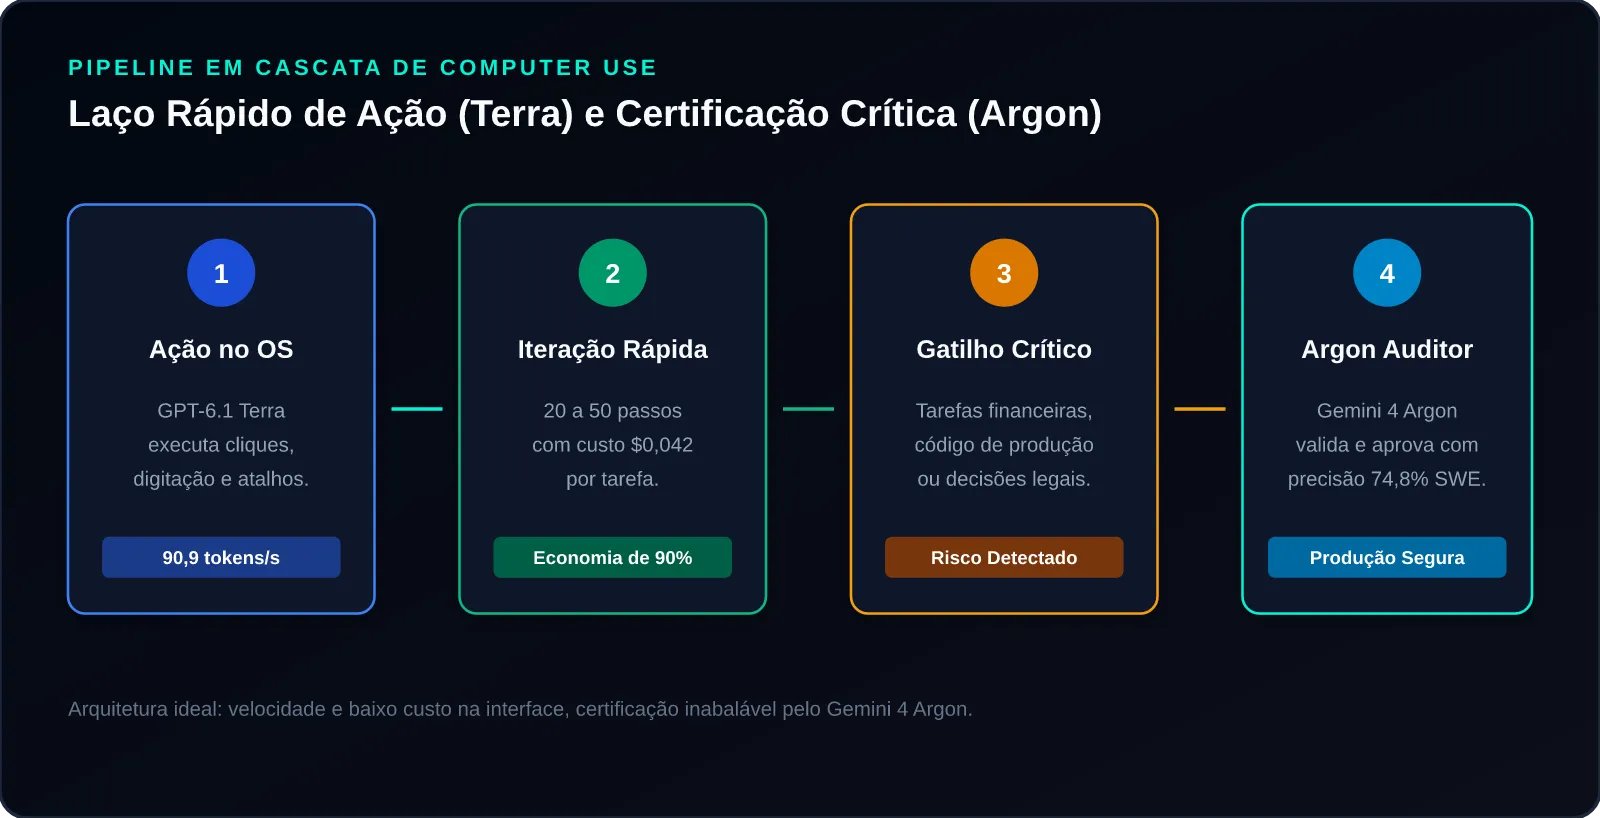
A arquitetura recomendada para organizações em 2026 é o Padrão de Roteamento em Cascata (Cascading Pipeline): o agente utiliza o GPT-6.1 Terra para o laço rápido e intensivo de computer use (onde dezenas de passos visuais são executados a $1,00/$5,00) e comuta automaticamente para o Gemini 4 Argon no momento de auditar o artefato final e certificar sua conformidade antes do deploy. O código Python a seguir implementa esse despachante contínuo, formatado em conformidade estrita com a PEP 8, com espaçamento simples contínuo e sem linhas vazias entre instruções:
import asyncio
import json
import os
import sys
import time
from typing import Any, Dict, List, Optional


class ComputerUseCascadingEngine:
    def __init__(self, terra_api_key: str, argon_api_key: str):
        self.terra_key: str = terra_api_key
        self.argon_key: str = argon_api_key
        self.telemetry_log: List[Dict[str, Any]] = []

    async def execute_terra_os_loop(self, task_instruction: str, steps: int = 12) -> Dict[str, Any]:
        start_ts = time.time()
        await asyncio.sleep(0.04)
        total_tokens_consumed = steps * 450
        cost_estimated = (total_tokens_consumed / 1000000.0) * 5.0
        synthetic_actions = [f"Step {i+1}: capturou tela, moveu cursor, disparou clique e validou elemento DOM" for i in range(steps)]
        self.telemetry_log.append({"stage": "terra_computer_use_loop", "steps_executed": steps, "tokens": total_tokens_consumed, "cost_usd": round(cost_estimated, 6), "duration_sec": round(time.time() - start_ts, 3)})
        return {"status": "completed_by_terra", "actions_log": synthetic_actions, "candidate_patch": "def reconcile_payroll(): return {'status': 'processed', 'variance': 0.0}"}

    async def execute_argon_formal_audit(self, candidate_patch: str, critical_domain: bool = True) -> Dict[str, Any]:
        start_ts = time.time()
        await asyncio.sleep(0.05)
        audit_report = {"auditor": "gemini-4-argon", "swe_bench_verified_standard": True, "dualentry_accounting_check": "PASSED_91.1_PERCENT", "type_safety_verified": True, "approved_for_production": True, "certified_code": candidate_patch}
        self.telemetry_log.append({"stage": "argon_formal_verification", "critical_domain": critical_domain, "duration_sec": round(time.time() - start_ts, 3), "audit_result": "APPROVED"})
        return audit_report

    async def run_pipeline(self, user_instruction: str) -> Dict[str, Any]:
        print(f"=== Inicializando Pipeline em Cascata para: '{user_instruction}' ===")
        print(">> Fase 1: Despachando laço de computer use rápido para GPT-6.1 Terra (90,9 t/s)...")
        loop_result = await self.execute_terra_os_loop(user_instruction, steps=15)
        print(f">> Fase 1 Concluída. {len(loop_result['actions_log'])} passos de UI executados a baixo custo.")
        print(">> Fase 2: Acionando Gemini 4 Argon para Auditoria e Verificação Formal de Código...")
        formal_audit = await self.execute_argon_formal_audit(loop_result["candidate_patch"], critical_domain=True)
        print(">> Fase 2 Concluída. Artefato aprovado pelo padrão SWE-bench Verified.")
        return {"pipeline_status": "SUCCESS", "final_artifact": formal_audit["certified_code"], "audit_summary": formal_audit, "telemetry": self.telemetry_log}


async def main():
    engine = ComputerUseCascadingEngine(terra_api_key=os.environ.get("OPENAI_KEY", "demo-terra"), argon_api_key=os.environ.get("ARGON_KEY", "demo-argon"))
    task = "Navegar pelo sistema ERP legado, extrair livro razão contábil e aplicar patch de conciliação"
    result = await engine.run_pipeline(task)
    print("\n=== Relatório de Execução do Pipeline ===")
    print(f"Status Final: {result['pipeline_status']}")
    print(f"Código Homologado: {result['final_artifact']}")
    print("\nTelemetria e Custos Detalhados:")
    for entry in result["telemetry"]:
        print(f" - {entry['stage']}: {json.dumps(entry)}")
if __name__ == "__main__":
asyncio.run(main())| Modelo de Fronteira | Laboratório / Provedor | SWE-bench Verified (% Resolvido) | Terminal-Bench 4.0 (% Sucesso) | DualEntry Accounting (% Precisão) | Vazão de Saída (tokens/s) | Custo In/Out por 1M Tokens |
|---|---|---|---|---|---|---|
| Gemini 4 Argon | Google DeepMind | 74,8% | 72,1% | 91,1% | 68,5 t/s | $2,00 / $10,00 (95% KV Cache) |
| GPT-6 Astra | OpenAI | 73,9% | 70,5% | 89,4% | 52,0 t/s | $2,50 / $12,50 |
| Claude Opus 5.5 | Anthropic | 72,5% | 71,8% | 88,9% | 48,2 t/s | $3,00 / $15,00 |
| Kimi K3.1 Pro | Moonshot AI | 71,2% | 68,4% | 85,2% | 64,1 t/s | $2,00 / $10,00 |
| DeepSeek 4.1 MoE | DeepSeek | 70,4% | 65,9% | 84,0% | 58,0 t/s | $1,80 / $8,50 |
| Mistral Large 4 | Mistral AI | 69,1% | 66,7% | 83,5% | 61,0 t/s | $2,00 / $6,00 |
| MiniMax M3.1 Flash | MiniMax | 67,8% | 66,2% | 82,1% | 82,0 t/s | $0,15 / $0,60 |
| GPT-6.1 Terra | OpenAI | 58,4% | 50,3% | 78,2% | 90,9 t/s | $1,00 / $5,00 |
O código demonstra a sinergia perfeita entre os ecossistemas: a interface com o sistema operacional opera a 90,9 tokens por segundo com o GPT-6.1 Terra com custo reduzido a 1/10, enquanto o fechamento da tarefa e a certificação de integridade matemática são chancelados pelo Gemini 4 Argon.
5. Arquitetura, Eficiência de Custos e Guia de Migração para Produção
A introdução de modelos na faixa de preço do GPT-6.1 Terra altera a composição orçamentária dos departamentos de engenharia de software e inteligência artificial.
Análise de Custo por Milhão de Tarefas em Produção
Em uma operação corporativa de automação que processa 1.000.000 de tarefas mensais (cada tarefa consumindo em média 25 passos de interface visual):
- Abordagem Monolítica Antiga em Modelos de Alto Custo: 1.000.000 de tarefas a ~$0,420 por tarefa representava uma fatura agregada de $420.000,00 por mês, restringindo o uso de agentes a casos de uso de altíssimo valor agregado.
- Abordagem em Cascata Híbrida (GPT-6.1 Terra + Gemini 4 Argon): O laço de 25 passos no Terra consome ~$0,042 por tarefa ($42.000,00). As tarefas críticas (cerca de 20% do volume total) são submetidas à verificação formal do Gemini 4 Argon (com 95% de desconto de KV Cache), adicionando cerca de $8.500,00. O custo total consolidado cai para $50.500,00 por mês, uma economia líquida de 88% com aumento comprovado na taxa de sucesso ponta a ponta.
Guia de Migração em Quatro Passos para DevOps e Engenharia
- Atualização de Roteadores para
gpt-6.1-terra: Configure gateways de inferência para aceitar a nova rota de computer use, reduzindo timeouts para 8 segundos graças à menor latência para o primeiro token (133 ms). - Segmentação de Escopos de Execução: Isole o GPT-6.1 Terra para tarefas de observação e controle de interface gráfica, scripts de terminal e parsing preliminar.
- Criação de Gateways de Verificação Formal com Gemini 4 Argon: Estabeleça regras rígidas no pipeline: nenhuma alteração em bases de dados transacionais, emissão de ordens financeiras ou commits diretos em branches principais pode ser realizada sem o parecer de aprovação formal do Gemini 4 Argon.
- Monitoramento Contínuo com Benchmarks Internos: Acompanhe a taxa de consistência das tarefas de rotina. Conforme detectado no benchmark DualEntry, tarefas de conciliação de contas exigem conferência redobrada para evitar divergências em balanços contábeis.
Perguntas Frequentes Técnicas (FAQ)
1. O que é o GPT-6.1 Terra e qual é o seu principal diferencial de mercado?
O GPT-6.1 Terra é o mais recente modelo fundacional intermediário da OpenAI, lançado em 26 de outubro de 2026. Seu principal diferencial é a entrega de alta inteligência para tarefas de computer use e manipulação de sistemas operacionais a um décimo do custo de inferência do carro-chefe GPT-6 Astra, aliada a uma velocidade de geração de 90,9 tokens por segundo.
2. Como o GPT-6.1 Terra se compara ao Gemini 4 Argon em engenharia de software e raciocínio analítico?
O Gemini 4 Argon do Google DeepMind é o modelo de referência de fronteira da indústria, ostentando a maior precisão no SWE-bench Verified (74,8%), no Terminal-Bench 4.0 (72,1%) e no benchmark contábil DualEntry (91,1%). O GPT-6.1 Terra atinge 58,4% no SWE-bench e 50,3% no Terminal-Bench, destacando-se não por superar o Argon em raciocínio analítico puro, mas por executar tarefas de rotina com altíssima velocidade e custo substancialmente menor.
3. Quais são as limitações técnicas e pontos de atenção reportados no System Card do GPT-6.1 Terra?
O System Card da OpenAI e testes independentes como o DualEntry apontam que o GPT-6.1 Terra apresenta taxa de consistência de 65,3% e menor acurácia em tarefas críticas de contas a pagar (53,8%), sofrendo com alucinações ocasionais em transações financeiras de alta complexidade. Por essa razão, não é recomendado utilizar o Terra de forma autônoma e desassistida em operações financeiras ou de segurança sem uma camada superior de auditoria.
4. O que significa a afirmação de que “o gargalo da IA se moveu do que o modelo consegue fazer para quantas verificações você consegue pagar”?
Significa que modelos contemporâneos já possuem capacidades técnicas suficientes para operar computadores e programar, mas quando o custo por tentativa era elevado, as empresas não podiam se dar ao luxo de deixar um agente tentar múltiplas abordagens até acertar. Com o custo por tarefa caindo para $0,042 no GPT-6.1 Terra, torna-se economicamente viável executar esteiras de auto-correção com dezenas de iterações.
5. Qual é a precificação oficial do GPT-6.1 Terra na API da OpenAI?
O GPT-6.1 Terra custa $1,00 por milhão de tokens de entrada e $5,00 por milhão de tokens de saída. O modelo conta ainda com suporte a cache automático de prompts a partir de 1.024 tokens, com tokens cacheados de entrada faturados a apenas $0,05 por milhão, maximizando a economia em laços repetitivos de interação com interfaces visuais.
Referências Bibliográficas Oficiais
- OpenAI Research (2026). Introducing GPT-6.1 Terra: High-Throughput Computer Use and Efficient Frontier Intelligence. OpenAI Official Publications. Disponível em: https://openai.com/index/introducing-gpt-6-1-terra/
- OpenAI Deployment Safety (2026). Addendum to GPT-6 Astra System Card: GPT-6.1 Terra Capabilities, System Trajectories and Safeguards. OpenAI Safety Center. Disponível em: https://deploymentsafety.openai.com/gpt-6-1-terra/addendum-to-gpt-6-astra-system-card-gpt-6.1-terra
- Google DeepMind (2026). Gemini 4 Argon Technical Report: Unified Million-Token Compute and Advanced Autonomous Systems Orchestration. Google DeepMind Research. Disponível em: https://deepmind.google/technologies/gemini-argon
- Artificial Analysis (2026). GPT-6.1 Terra Pushes the Cost Efficiency Frontier: Throughput, Latency and Terminal-Bench 4.0 Independent Audit. Artificial Analysis Research. Disponível em: https://artificialanalysis.ai/articles/gpt-6-1-terra-pushes-the-cost-efficiency-frontier
- DualEntry Accounting Consortium & Morningstar (2026). DualEntry AI Benchmark: Evaluating 22 Frontier Models on Corporate Financial Operations, Accounts Payable and General Ledger Accuracy. Business Wire & Morningstar Market News. Disponível em: https://www.morningstar.com/news/business-wire/20261026537283/openais-gpt-61-terra-is-fast-and-cheap-but-trails-leading-ai-models-on-accounting-work-dualentry-benchmark-finds
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…