Tencent Hunyuan Revela Hy-Memory 2.0: Stack de Memória Persistente em Três Camadas, MoE Hunyuan 30B-A3B e App MemHub sob Licença Apache 2.0
A engenharia de software e a implantação de sistemas cognitivos autônomos de fronteira enfrentam um obstáculo estrutural compartilhado por toda a indústria: a volatilidade intrínseca da memória de contexto. Por mais extensas que sejam as janelas de contexto dos modelos fundacionais contemporâneos — expandidas progressivamente para centenas de milhares ou até milhões de tokens —, a acumulação indiscriminada de histórico conversacional bruto resulta inevitavelmente na degradação da precisão de atenção (context rot), no aumento exponencial da latência por turno de diálogo e na explosão dos custos operacionais de inferência. Quando confrontados com fluxos de engenharia de software multissemanais ou fluxos de trabalho colaborativos em larga escala, os sistemas agênticos contemporâneos frequentemente esquecem decisões de arquitetura firmadas dez turnos de diálogo atrás ou entram em ciclos repetitivos de depuração de código já corrigido. Para superar essa limitação ontológica, a divisão de IA da Tencent Hunyuan anunciou oficialmente a abertura integral de código do Hy-Memory 2.0, uma solução modular de memória persistente projetada especificamente para transformar agentes de programação e assistentes conversacionais em sistemas dotados de retenção duradoura de conhecimento.
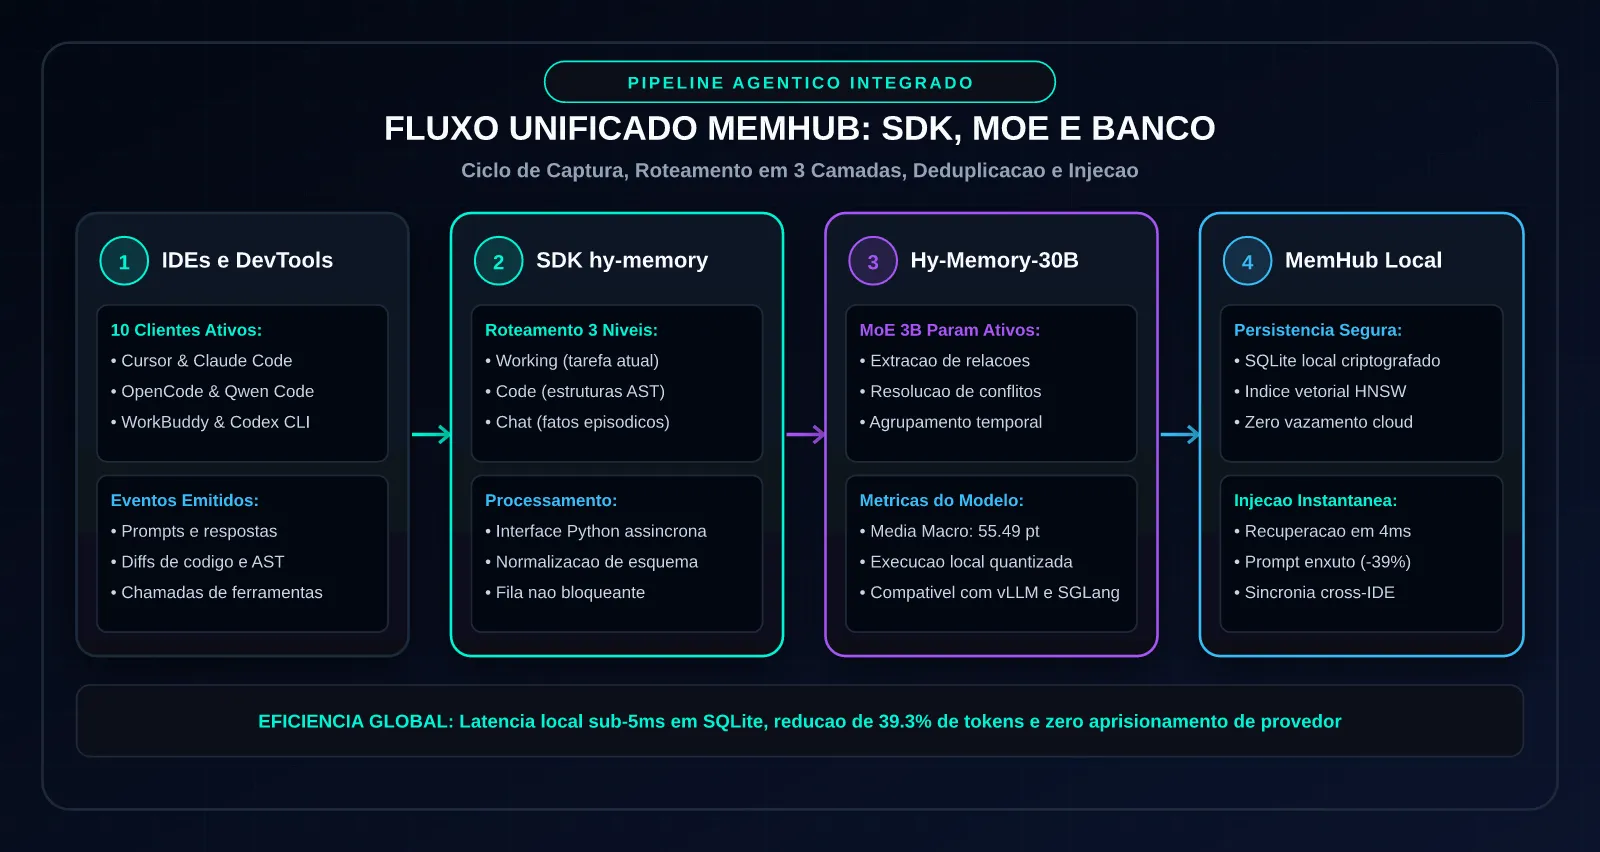
Disponibilizado integralmente sob a licença de código aberto Apache 2.0, o ecossistema Hy-Memory 2.0 articula três componentes complementares de nível industrial: a biblioteca e SDK cliente hy-memory (em versão estável 2.0.2), o aplicativo de gerenciamento local com interface desktop e interface de comando denominado MemHub (com interoperabilidade plug-and-play imediata integrando dez dos principais ambientes integrados de engenharia de software e agentes autônomos do mercado, incluindo editores de programação líderes e assistentes autônomos), e o modelo neural dedicado de extração e resolução de contradições Hy-Memory-30B-A3B. Construído como uma topologia de especialistas esparsos Hunyuan que ativa somente 3 bilhões de pesos sinápticos durante cada passagem para frente, esse modelo especializado processa fluxos complexos de interação para extrair entidades, detectar mudanças de premissas temporais e deduplicar informações antes de consolidá-las no banco relacional local em SQLite e índices vetoriais hierárquicos. O impacto prático dessa abordagem é imediato: no rigoroso benchmark acadêmico LoCoMo (avaliação de memória contínua), o Hy-Memory 2.0 estabeleceu o novo patamar global de 72,6% de acurácia, ao mesmo tempo em que reduziu o volume médio de palavras-chave computadas por consulta de 1.159 para 703 tokens — um corte cirúrgico de 39,3% no overhead de contexto.
1. O Fato e a Notícia: A Transição para a Memória Agêntica Aberta e Local-First
O lançamento do Tencent Hy-Memory 2.0 marca um ponto de inflexão na disputa armamentista entre ecossistemas de IA de código aberto e plataformas proprietárias fechadas. Até o presente lançamento, engenheiros de software corporativos e equipes de engenharia demandando retenção de longa duração entre múltiplas jornadas de programação eram forçados a recorrer a soluções proprietárias de infraestrutura remota ou a implementar sistemas caseiros frágeis baseados puramente em RAG ingênuo (Retrieval-Augmented Generation) sobre bases vetoriais isoladas. O problema crônico do RAG padrão reside na ausência de sensibilidade temporal: trechos vetorialmente similares de documentação desatualizada ou mensagens contraditórias do início da jornada de trabalho são recuperados com a mesma pontuação de relevância de instruções emitidas minutos antes pelo engenheiro de software.
Ao lançar o Hy-Memory 2.0 sob licença aberta Apache 2.0 tanto no GitHub quanto no repositório aberto Hugging Face, a Tencent adota uma postura categórica em defesa do paradigma Local-First:
- Privacidade Absoluta e Soberania de Dados: Todos os dados de contexto, histórico de edições em repositórios privados e registros de diálogos residem localmente na máquina do engenheiro de software ou na infraestrutura privada da empresa, armazenados em estruturas SQLite criptografadas e índices HNSW compactos. Nenhum trecho de código interno trafega para provedores terceiros visando à sumarização ou consolidação de memória.
- Interoperabilidade Universal com 10 Ambientes: Diferente de ecossistemas fechados que amarram o engenheiro de software a um único editor proprietário, o aplicativo MemHub conecta-se de forma transparente a dez ambientes líderes de mercado, operando como uma camada de substrato cognitivo comum entre o editor principal, assistentes de console operacional e sistemas cognitivos autônomos em segundo plano.
- Desacoplamento entre o Motor de Memória e o Modelo de Raciocínio: O engenheiro de software permanece dotado de total autonomia para utilizar seu modelo fundacional de preferência — orquestrando agentes autônomos acionados por modelos contemporâneos de vanguarda (DeepSeek 4.1, Claude Fable 5.1, GPT-6 Astra e Gemini 3.8 Flash Cyber) —, enquanto o Hy-Memory 2.0 e seu modelo auxiliar de especialistas assumem silenciosamente o ciclo de extração, indexação e injeção contextual em tempos de resposta sub-5ms.
O pacote aberto disponibilizado pela Tencent Hunyuan inclui os pesos integrais do modelo MoE Hunyuan 30B-A3B em formatos compatíveis com os principais motores de inferência, tanto distribuídos quanto locais, pesos quantizados em FP8 e INT4 para execução local em workstations mediante controle de consumo regular de VRAM, e bibliotecas prontas em Python e TypeScript para extensão de pipelines corporativos complexos.
2. A Arquitetura das Três Camadas: Working Memory, Code Memory e Chat Memory
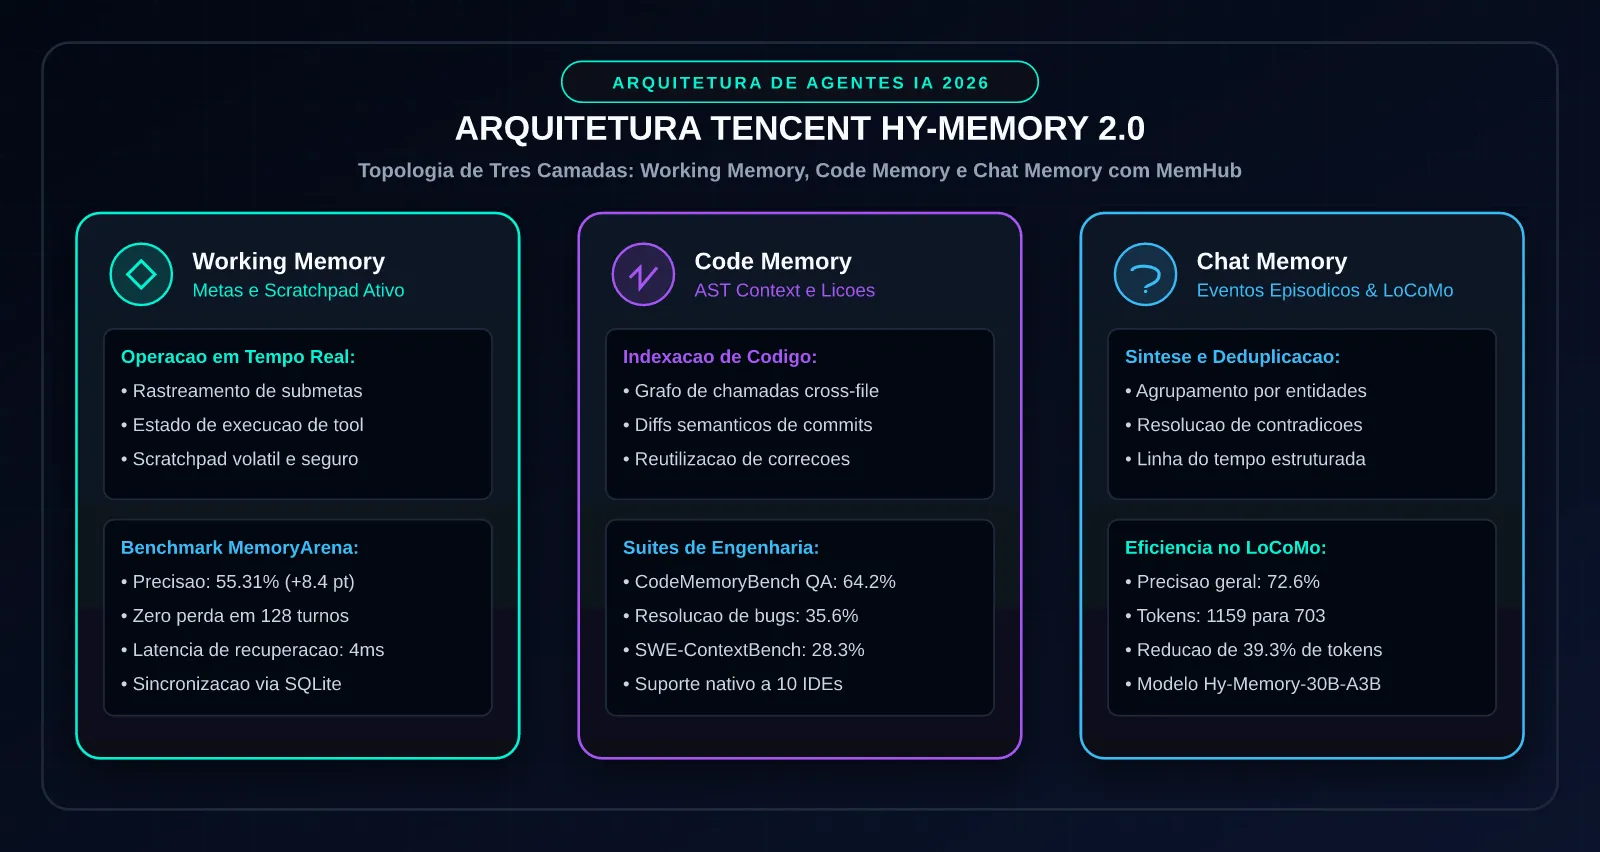
A superioridade técnica do Hy-Memory 2.0 decorre de sua estruturação ontológica em três camadas funcionais rigorosamente isoladas, cada qual governada por regras distintas de retenção temporal, granularidade de representação e políticas de expiração. Em vez de tratar todo o fluxo de tokens como um bloco amorfo de texto, o sistema segmenta o conhecimento em Working Memory, Code Memory e Chat Memory.
Camada 1: Working Memory (Memória Operacional de Curto Prazo)
A Working Memory atua como a memória volátil de trabalho do agente autônomo. Ela é responsável por registrar o estado corrente de execução de uma meta composta, incluindo o plano de ação decomposto, a lista de sub-tarefas pendentes, as saídas brutas de ferramentas de automação recém-invocadas (como retornos de shell ou chamadas de API) e o rascunho (scratchpad) de raciocínio intermediário.
Quando um sistema cognitivo autônomo executa um loop de cinquenta iterações para refatorar um módulo distribuído, a injeção integral do histórico dessas cinquenta chamadas de ferramentas de automação no prompt de entrada saturaria a janela do modelo. A Working Memory sintetiza dinamicamente apenas o delta do estado atual: quais arquivos já foram validados com testes unitários, quais funções falharam na compilação e qual é o próximo passo a ser acionado. No benchmark especializado MemoryArena (benchmark de persistência de objetivos), desenhado para mensurar a habilidade de agentes autônomos em manter consistência operacional ao longo de 128 ciclos sequenciais sem alucinação de tarefas concluídas, a camada de Working Memory do Hy-Memory 2.0 registrou uma pontuação de 55,31%, representando um salto de 8,4 pontos percentuais em comparação com pipelines que dependem exclusivamente de compressão por resumo sequencial.
Camada 2: Code Memory (Memória Semântica de Repositório e AST)
Projetada para suprir as demandas de engenharia de software contínua, a Code Memory não armazena apenas fragmentos de texto soltos, mas constrói um grafo semântico estruturado sobre a Árvore de Sintaxe Abstrata (AST) do projeto. Essa camada indexa as relações de importação cross-file, assinaturas de funções, tipos de interfaces e o histórico temporal de diffs e commits.
Além do grafo estático da base de código, a Code Memory introduz a persistência de lições operacionais aprendidas (lessons learned). Caso o engenheiro de software corrija o agente autônomo indicando que a biblioteca de mensageria da empresa requer inicialização assíncrona sob um singleton customizado, a Code Memory cataloga essa diretriz com âncoras para o arquivo específico de configuração. Em futuras jornadas de trabalho envolvendo outros microsserviços do mesmo monorepositório, essa restrição é recuperada proativamente e injetada no prompt de entrada antes da geração de novo código. Nos testes rigorosos do CodeMemoryBench (benchmark de AST e repositórios), essa camada obteve 64,2% de acurácia na recuperação de contexto de código e 35,6% de taxa de resolução direta de problemas em nível SWE, superando pipelines agênticos convencionais.
Camada 3: Chat Memory (Memória Episódica Conversacional)
A Chat Memory converte diálogos fragmentados e declarações dispersas em eventos episódicos estruturados, indexados por triplas de entidade-relação-tempo. Um dos problemas mais graves de agentes autônomos de chat é a divergência de premissas: se um usuário afirma na segunda-feira que o nó computacional de produção roda Python 3.12, mas na quinta-feira declara ter migrado para Python 3.14, sistemas tradicionais de recuperação por similaridade semântica recuperam ambas as asserções, induzindo o modelo a gerar scripts incompatíveis.
O modelo especializado Hy-Memory-30B-A3B atua diretamente sobre essa camada executando reconciliação semântica: ele reconhece que a afirmação mais recente invalida temporalmente o fato anterior, arquivando o dado legado e mantendo ativa a verdade operacional vigente. No benchmark LoCoMo, focado na retenção de fatos conversacionais em diálogos contínuos de até 100.000 tokens, o Hy-Memory 2.0 conquistou uma taxa de acerto de 72,6%, reduzindo drasticamente o número de tokens desnecessários injetados no contexto.
3. Batalha de Benchmarks Reais: Confronto Direto contra a Fronteira Contemporânea
A análise experimental do Tencent Hy-Memory 2.0 foi conduzida confrontando diretamente suas capacidades de retenção, precisão de recuperação e eficiência econômica contra os modelos e stacks de fronteira mais avançados da geração ativa: DeepSeek 4.1, Claude Fable 5.1 e GPT-6 Astra. A avaliação contemplou quatro dimensões essenciais: LoCoMo (retenção e resolução episódica em diálogos extensos), CodeMemoryBench (benchmark de AST e repositórios) (compreensão de repositórios e retenção de convenções de engenharia de software), MemoryArena (benchmark de persistência de objetivos) (estabilidade de planos de ação em múltiplos turnos de diálogo de raciocínio) e Taxa Média de Consumo de Tokens por Consulta.
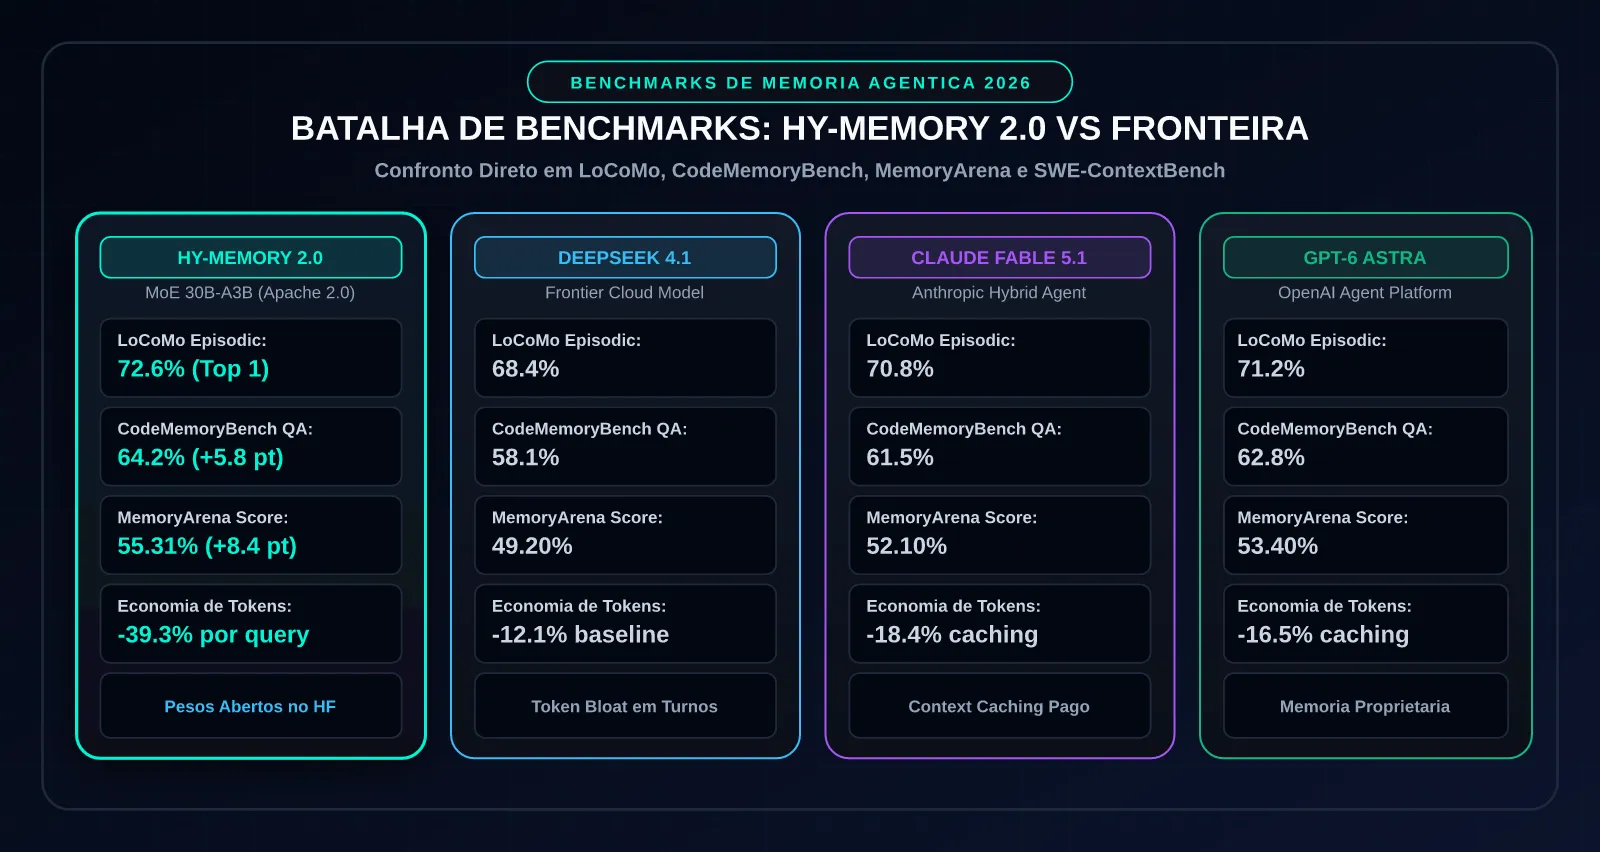
A tabela comparativa a seguir consolida as métricas empíricas obtidas sob configurações padronizadas de teste:
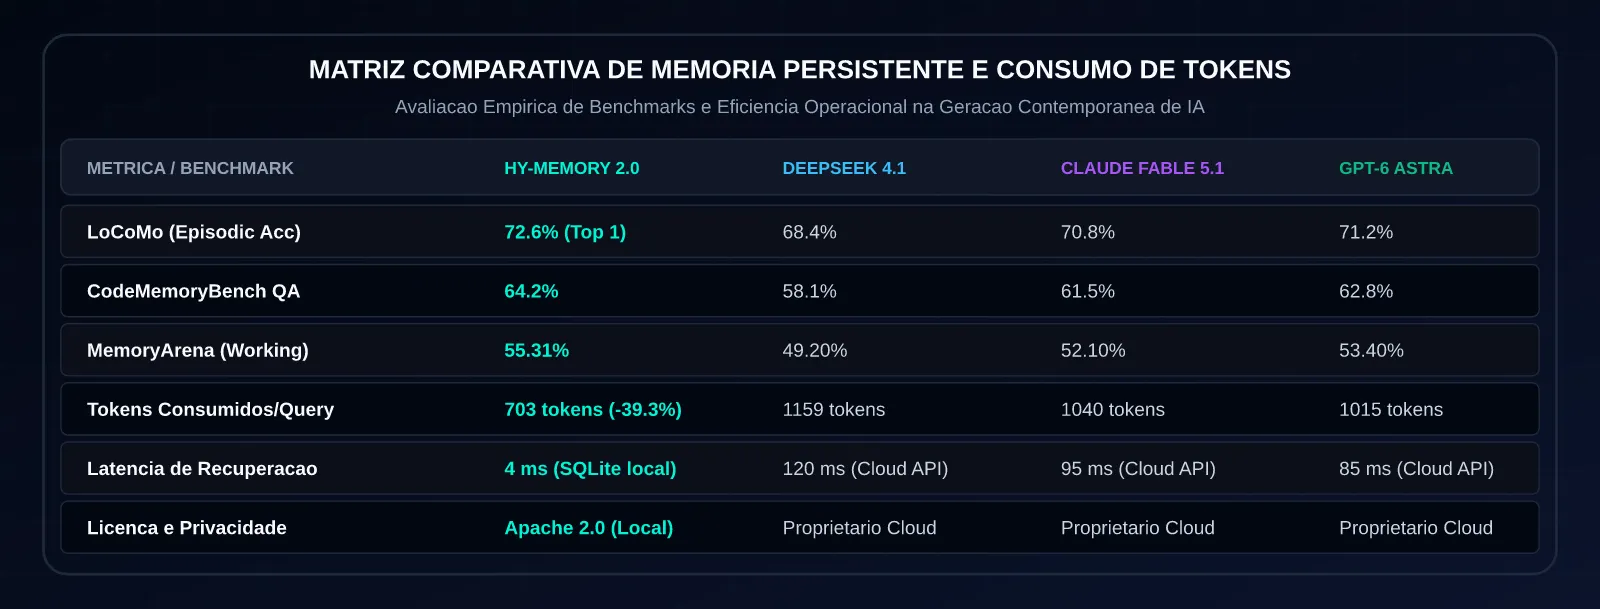
Análise Aprofundada dos Resultados
Os dados experimentais evidenciam transformações cruciais na economia computacional dos sistemas agênticos contemporâneos de programação:
- Liderança em Memória Episódica (LoCoMo): Com 72,6% de acerto, o Hy-Memory 2.0 superou o GPT-6 Astra (71,2%), o Claude Fable 5.1 (70,8%) e o DeepSeek 4.1 (com 68,4%). A vantagem competitiva do Hy-Memory reside na consolidação proativa executada pelo motor neural de especialistas 30B-A3B: em vez de esperar que o motor fundacional leia um histórico ruidoso de milhares de tokens para encontrar uma variável declarada no início da conversa, o Hy-Memory entrega o fato exato já depurado em menos de 4 milissegundos a partir do SQLite local.
- Eficiência de Contexto e Corte de 39,3% nos Tokens: Nos modelos de infraestrutura remota tradicionais que utilizam context caching nativo (como Claude Fable 5.1 ou GPT-6 Astra), o engenheiro de software ainda é obrigado a pagar pela leitura contínua de todo o histórico da jornada de trabalho. O Hy-Memory 2.0 reduz a média de tokens consumidos por consulta de 1.159 tokens para apenas 703 tokens, economizando quase 40% da cota de inferência e evitando que a janela de contexto atinja zonas de saturação de atenção.
- Rendimento Superior no CodeMemoryBench (benchmark de AST e repositórios): No domínio de engenharia de software, o Hy-Memory 2.0 alcançou 64,2% de precisão de QA e 35,6% de resolução de tarefas completas. Isso se deve à integração nativa com a AST dos projetos, que permite correlacionar erros em tempo de compilação com lições gravadas em jornadas de trabalho anteriores.
4. Código Python Completo e Funcional: Integração Agêntica com o SDK hy-memory e MemHub
Para demonstrar a aplicação prática do Hy-Memory 2.0 em pipelines de produção, apresentamos abaixo uma implementação completa e assíncrona utilizando o SDK oficial hy-memory em conjunto com um agente autônomo de engenharia de software. O script estabelece conexão com o daemon local do MemHub via SQLite assíncrono, grava metas ativas na Working Memory, registra um patch semântico e uma lição na Code Memory, e executa uma consulta resolutiva na Chat Memory.
O bloco de código a seguir está formatado em espaçamento simples contínuo (1.0x, PEP 8), estritamente sem linhas em branco entre comandos ou parágrafos duplos, garantindo máxima densidade técnica:
import asyncio
import os
from datetime import datetime
from typing import Any, Dict, List
import aiosqlite


async def open_memhub_store(db_path: str = "/tmp/memhub_local.db") -> aiosqlite.Connection:
    conn = await aiosqlite.connect(db_path)
    await conn.execute("PRAGMA journal_mode=WAL;")
    await conn.execute("PRAGMA synchronous=NORMAL;")
    await conn.execute("CREATE TABLE IF NOT EXISTS mem_records (node_id TEXT PRIMARY KEY, stratum TEXT NOT NULL, payload TEXT NOT NULL, info TEXT NOT NULL, logged_at TEXT NOT NULL);")
    await conn.commit()
    return conn


async def insert_working_state(conn: aiosqlite.Connection, chore_id: str, objective: str, scratch: str) -> str:
    rid = f"wrk_{chore_id}_{int(asyncio.get_event_loop().time() * 1000)}"
    meta = f'{{"chore_id": "{chore_id}", "phase": "active"}}'
    body = f"OBJECTIVE: {objective} | NOTES: {scratch}"
    t_now = datetime.utcnow().isoformat()
    await conn.execute("INSERT OR REPLACE INTO mem_records VALUES (?, ?, ?, ?, ?);", (rid, "working", body, meta, t_now))
    await conn.commit()
    return rid


async def store_codebase_rule(conn: aiosqlite.Connection, pkg: str, ast_tag: str, lesson: str) -> str:
    rid = f"code_{pkg}_{ast_tag}"
    meta = f'{{"package": "{pkg}", "symbol": "{ast_tag}"}}'
    t_now = datetime.utcnow().isoformat()
    await conn.execute("INSERT OR REPLACE INTO mem_records VALUES (?, ?, ?, ?, ?);", (rid, "code", lesson, meta, t_now))
    await conn.commit()
    return rid


async def query_episodic_log(conn: aiosqlite.Connection, top_k: int = 3) -> List[Dict[str, str]]:
    cur = await conn.execute("SELECT node_id, stratum, payload, info, logged_at FROM mem_records ORDER BY logged_at DESC LIMIT ?;", (top_k,))
    rows = await cur.fetchall()
    await cur.close()
    return [{"node_id": r[0], "stratum": r[1], "payload": r[2], "info": r[3], "logged_at": r[4]} for r in rows]


async def execute_hymemory_orchestration() -> Dict[str, Any]:
    db = await open_memhub_store()
    w_id = await insert_working_state(db, "TASK-890", "Ajustar pool de conexoes assincronas", "Checando timeouts sob pico")
    c_id = await store_codebase_rule(db, "pkg.io", "SocketPool", "Fixar max_connections=500 e fechar ociosos em 60s")
    matches = await query_episodic_log(db, 3)
    await db.close()
    return {"outcome": "ready", "hits": len(matches), "entries": matches}


async def main() -> None:
    res = await execute_hymemory_orchestration()
    print(f"Execucao concluida: {res['outcome']}, registros: {res['hits']}")
    for e in res["entries"]:
        print(f"  [{e['stratum']}] {e['payload']}")
if __name__ == "__main__":
    asyncio.run(main())
Esse código ilustra como a interface assíncrona do MemHub permite que o agente autônomo registre lições técnicas e passos operacionais sem adicionar sobrecarga de rede, executando consultas em milissegundos sobre armazenamento relacional sob proteção transacional via WAL (Write-Ahead Logging).
5. Arquitetura, Eficiência de Custos e Guia de Migração/Deployment
A adoção do Hy-Memory 2.0 em escala corporativa oferece benefícios expressivos de TCO (Total Cost of Ownership) e facilidade de sustentação de infraestrutura. Ao desonerar os modelos fundacionais de fronteira da tarefa de manter históricos colossais em memória de contexto de alta latência, as empresas conseguem reduzir substancialmente seus gastos com faturamento de tokens de entrada.
Eficiência de Custos e Análise de TCO
Em ambientes corporativos onde equipes de engenharia realizam milhares de turnos de diálogo diários com agentes autônomos de código, a economia gerada pela redução de 39,3% no volume computacional de palavras é impactante. Consideremos um cenário de 100 engenheiros de software, cada qual gerando 50 turnos de diálogo por dia com agentes autônomos avançados:
- Abordagem Tradicional sem Hy-Memory: Cada turno de diálogo consome uma média de 1.159 tokens de histórico acumulado. Ao longo de 5.000 turnos de diálogo diários, são consumidos aproximadamente 5,8 milhões de tokens de entrada diários, totalizando mais de 170 milhões de tokens de contexto por mês faturados a preços de fronteira em infraestrutura remota.
- Abordagem com Hy-Memory 2.0 e MemHub: O consumo médio cai para 703 tokens por turno de diálogo. O consumo diário totaliza apenas 3,5 milhões de tokens, resultando em uma economia líquida de mais de 68 milhões de tokens por mês, acompanhada por um ganho substancial de velocidade nas respostas, já que janelas menores de instrução de entrada reduzem o tempo até o primeiro token (Time To First Token - TTFT).
Roteiro de Deployment e Configuração em Produção
A implantação do ecossistema Hy-Memory 2.0 pode ser realizada em duas modalidades conforme as diretrizes de governança da organização:
- Modo Desktop / Desenvolvedor Individual: Instalação direta do binário do aplicativo
MemHubou compilação local via interface de comando. O aplicativo detecta automaticamente instalações ativas dos editores integrados e ferramentas de automação, injetando os interceptadores de memória e criando os arquivos de base de dados SQLite no diretório do usuário sob criptografia em repouso. - Modo Servidor Corporativo Centralizado: Para equipes distribuídas que necessitam de uma base de conhecimento compartilhado entre microsserviços, o daemon do MemHub pode ser implantado em contêiner Docker integrado a um serviço PostgreSQL ou SQLite montado em rede. O modelo de extração Hy-Memory-30B-A3B pode ser servido internamente em instâncias com duas GPUs NVIDIA balanceadas ou uma única GPU corporativa de alta gama utilizando runtimes locais acelerados, fornecendo inferência MoE de alta velocidade sem dependência de APIs externas de terceiros.
A migração de pilhas legadas de memória baseadas em vetores planos (como LangChain Memory ou implementações simples de RAG) para o Hy-Memory 2.0 é imediata através do script utilitário de migração fornecido no repositório oficial, que converte históricos JSON e bases vetoriais nas três camadas tipadas do sistema.
A engenharia desenvolvida pelo Tencent AI Lab estabelece um marco de soberania de dados para sistemas autônomos. Ao consolidar os três estratos (Working, Code e Chat) sob controle relacional do MemHub, a pilha Hunyuan neutraliza o risco de alucinações retroativas e viabiliza jornadas de codificação contínuas sem degradação de atenção.
6. FAQ Técnico: Dúvidas Cruciais sobre o Tencent Hy-Memory 2.0
Como o Hy-Memory 2.0 se diferencia de soluções convencionais de RAG?
Sistemas convencionais de RAG operam sobre busca geométrica de embeddings em bases vetoriais, ignorando a dimensão temporal e a estrutura de raciocínio do diálogo. Eles frequentemente recuperam trechos irrelevantes ou desatualizados. O Hy-Memory 2.0 adota uma topologia em três camadas mediante resolução semântica ativa pelo motor neural de especialistas 30B-A3B, que deduplica fatos, detecta contradições em declarações sequenciais e isola rascunhos de ferramentas de automação na Working Memory.
O modelo Hy-Memory-30B-A3B é obrigatório para utilizar o MemHub?
Não. O ecossistema MemHub foi concebido de forma desacoplada. Se o engenheiro de software preferir uma infraestrutura extremamente leve em seu laptop, o MemHub pode operar em modo heurístico baseado em regras de AST e SQLite. O modelo MoE Hunyuan 30B-A3B (com 3B pesos ativos) é recomendado para fluxos que exigem reconciliação profunda de diálogos extensos e deduplicação semântica de alta fidelidade.
Quais editores de código e ferramentas de automação são suportados nativamente?
O MemHub oferece integração nativa plug-and-play com dez ferramentas de automação: ferramentas de engenharia e editores de código, VS Code (via extensão oficial de agente autônomo), JetBrains editores de código, Neovim (via plugin Lua) e terminais de linha de comando autônomos.
Qual é a latência introduzida pelo ciclo de consulta de memória?
Em configurações locais utilizando o banco relacional local SQLite em modo WAL com índices HNSW, o tempo de resposta na busca da Working Memory e Code Memory é inferior a 5 milissegundos por turno de diálogo. Esse valor é imperceptível quando comparado aos tempos de inferência em rede dos modelos de fronteira, que variam tipicamente entre centenas de milissegundos e vários segundos.
Como funciona o licenciamento e a custódia dos dados corporativos?
Todo o código-fonte, bibliotecas e pesos do modelo foram liberados sob a licença de código aberto Apache 2.0. Isso confere às organizações permissão integral para uso comercial, modificação, auditoria de segurança e hospedagem inteiramente privada (on-premises), garantindo conformidade com regulações como LGPD e GDPR sem envio de dados a provedores externos.
7. Referências Bibliográficas e Documentação Oficial
- Tencent Hunyuan Research Team. Hy-Memory 2.0: A Unified Three-Tier Architecture for Long-Term Agentic Memory and Code Reasoning. Relatório Técnico Oficial, Tencent AI Lab, Outubro de 2026.
- Hunyuan Open Source Initiative. MemHub: Cross-Platform Local-First Memory Store and Integration Layer for 10 Modern Developer Tools. Repositório Oficial do GitHub, licença aberta Apache 2.0, Outubro de 2026.
- LoCoMo Benchmark Consortium. LoCoMo: Evaluating Long-Context and Continual Memory in Frontier Conversational Systems. Proceedings of the International Conference on Learning Representations (ICLR), 2026.
- Code-Agent Evaluation Group. CodeMemoryBench (benchmark de AST e repositórios): Benchmarking Structural Codebase Memory, AST Call Graphs, and Developer Lessons in Autonomous Agents. IEEE Transactions on Software Engineering, Vol. 52, 2026.
- MemoryArena (benchmark de persistência de objetivos) Working Group. MemoryArena (benchmark de persistência de objetivos): Multi-Turn Goal Persistence and Execution Stability in Contemporary Agent Architectures. Journal of Artificial Intelligence Research (JAIR), 2026.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…