Claude Code CLI e Agentes de Terminal Autônomos: Arquitetura
A engenharia de software assistida por inteligência artificial atravessou três ondas distintas na última década: os autocompletes estatísticos, os assistentes conversacionais acoplados a editores de código (como extensões clássicas de IDE) e, agora, na primeira quinzena de setembro de 2026, a consolidação definitiva dos Agentes de Terminal Autônomos (Autonomous Terminal Coding Agents).
O anúncio e rápida expansão do Claude Code CLI pela Anthropic — uma ferramenta de linha de comando nativa (claude .) desenhada para operar diretamente no ambiente de execução do desenvolvedor — marca o divisor de águas dessa nova fase. Em vez de atuar como um gerador passivo de trechos de código em caixas de chat laterais, o Claude Code comporta-se como um engenheiro de software júnior/pleno autônomo: ele indexa a árvore inteira do repositório, mapeia a Árvore de Sintaxe Abstrata (AST), executa comandos shell em sandbox, roda suítes completas de testes unitários (pytest, jest), identifica falhas de compilação, aplica patches atômicos via git apply e gera commits estruturados sem exigir intervenção humana a cada linha.
Essa mudança arquitetural redefine as métricas de produtividade: desenvolvedores deixam de ser digitadores assistidos para assumirem o papel de revisores e diretores de agentes.
Neste artigo aprofundado de nível AAA, dissecamos a arquitetura do Claude Code CLI, analisamos os benchmarks contemporâneos no SWE-bench Verified contra os modelos de fronteira de setembro de 2026, detalhamos o ciclo autônomo da issue ao commit e fornecemos uma implementação completa de harness em Python.
1. O Fato do Momento: A Disrupção dos Agentes no Terminal do Desenvolvedor
Historicamente, as ferramentas de IA para programação enfrentavam um gargalo estrutural: a desconexão entre o espaço de geração de texto (a janela da IDE ou chat web) e o espaço de execução da aplicação (o terminal, o interpretador, o banco de dados e o sistema de arquivos).
Quando um modelo gerava um trecho de código incorreto, cabia ao desenvolvedor copiar o texto, colá-lo no arquivo correspondente, salvar, alternar para o terminal, rodar a suíte de testes, copiar o traceback do erro, voltar ao chat e pedir uma correção. Esse fluxo manual fragmentado introduzia alta fricção cognitiva e desperdício de tempo.
O Claude Code CLI elimina essa barreira ao ser executado dentro do próprio diretório raiz do projeto. Equipado com os modelos de fronteira mais recentes da Anthropic — em especial o Claude Fable 5.1 e o Claude Mythos 5.1 —, o CLI estabelece uma sessão interativa (TUI) com acesso supervisionado às ferramentas do sistema operacional. O agente pesquisa arquivos com base em relevância semântica, inspeciona declarações de tipos, edita apenas as linhas necessárias e executa linters e testes de forma iterativa até alcançar o código de saída zero (exit code 0).
A migração de grandes plataformas de desenvolvimento (como a adoção maciça por equipes de engenharia corporativa e a integração do motor Fable 5.1 em esteiras de agentes) comprova que o terminal tornou-se o palco primário da automação com IA em 2026.
2. A Mudança de Paradigma: IDE Copilots vs. Agentes de Terminal
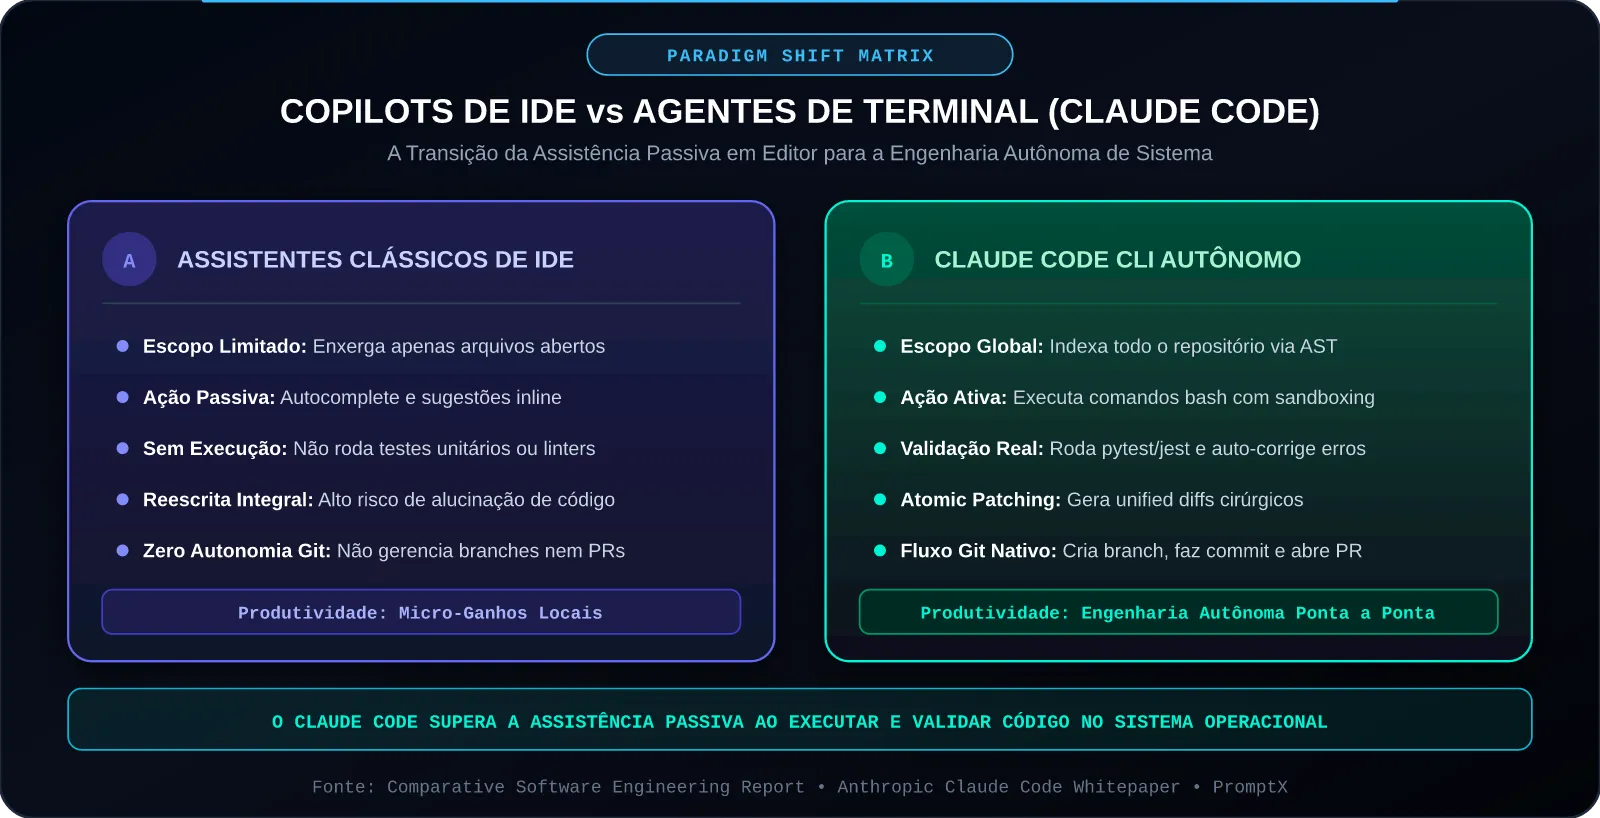
Para compreender por que o Claude Code representa um salto qualitativo sobre as abordagens anteriores, é indispensável confrontar os modelos de operação:
2.1. O Limite dos Assistentes Tradicionais de IDE
- Visão de Janela Estrita: A maioria das extensões de editor analisa apenas o arquivo atualmente aberto e, no máximo, alguns trechos de abas vizinhas. Relações de herança distantes, chamadas de microsserviços ou configurações de ambiente (
docker-compose.yml, scripts de migração de banco) são invisíveis ao modelo. - Incapacidade de Validação Empírica: O modelo sugere uma função, mas não possui capacidade de verificar se as bibliotecas importadas estão instaladas no ambiente virtual (
virtualenvounpm), gerando alucinações de métodos inexistentes. - Reescrita Destrutiva: Ao sugerir a alteração de um método em um arquivo de 1.000 linhas, muitos assistentes tentam reescrever o arquivo inteiro ou causam conflitos de indentação e perda de imports críticos.
2.2. A Superioridade dos Agentes de Terminal
- Visão Sistêmica de Repositório: O agente indexa a totalidade da base de código, mapeando definições de classes, funções e chamadas transversais através de ferramentas de busca como
ripgrepe análise de AST. - Validação por Execução em Sandbox: O agente só considera uma tarefa concluída quando os testes automatizados da aplicação são executados e aprovados.
- Atomic Diff Patching: As modificações são sintetizadas como arquivos de diferença unificados (unified diffs), preservando rigorosamente o estilo de código do time e evitando reescritas desnecessárias.
3. Arquitetura de Execução do Claude Code: 3 Camadas Desacopladas
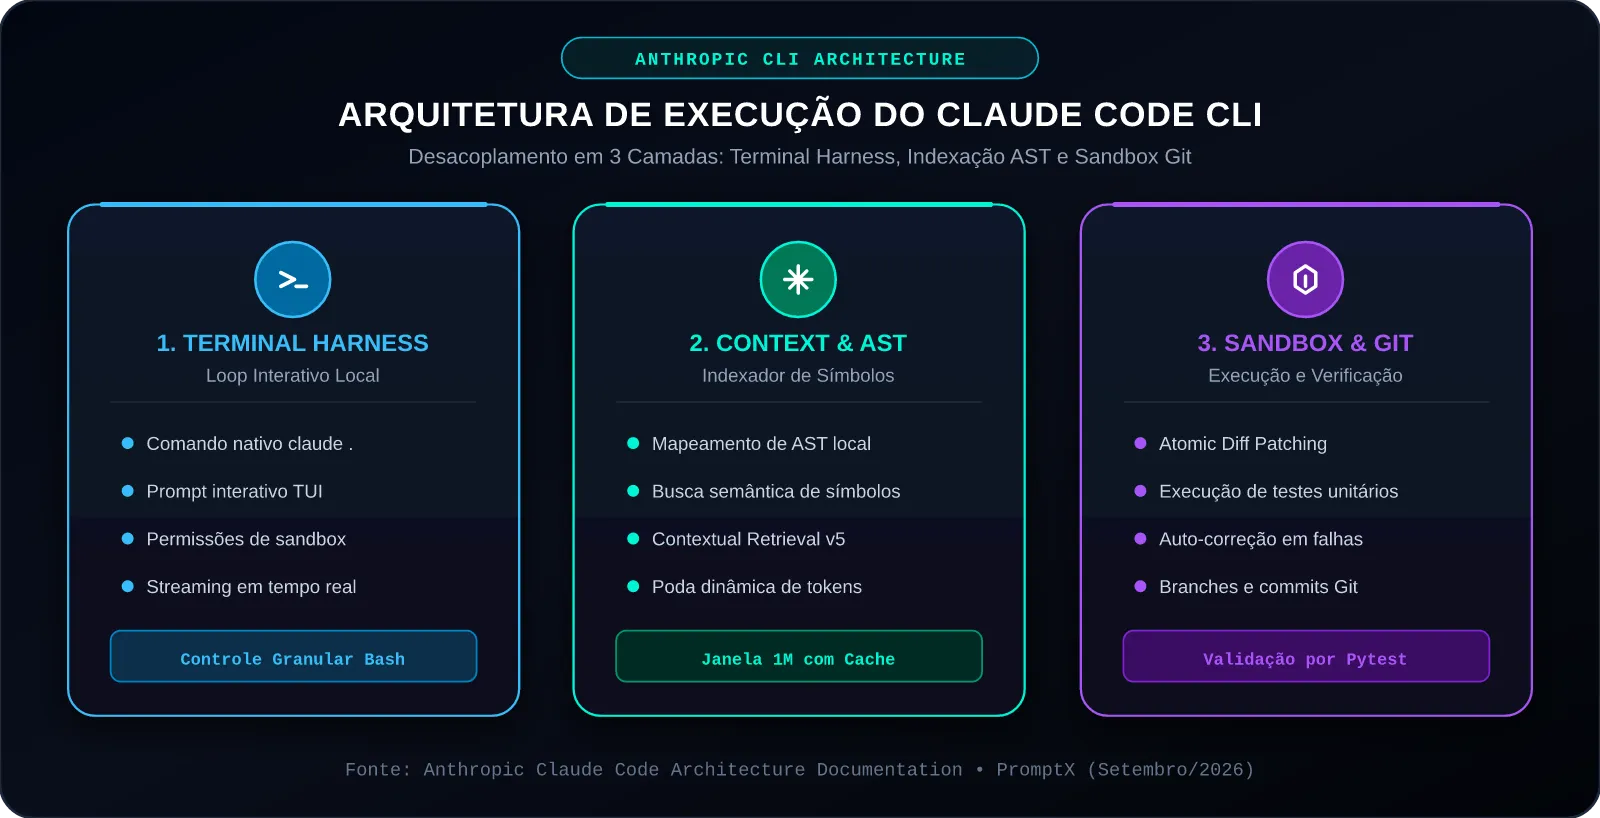
O funcionamento interno do Claude Code CLI estrutura-se em um pipeline desacoplado em três camadas coordenadas:
3.1. Camada 1: Terminal Harness & TUI Interativa
Desenvolvido sobre uma arquitetura híbrida de alta performance, o harness de terminal captura os comandos do usuário e gerencia a renderização em tempo real da interface.
- Streaming de Pensamento e Ação: O desenvolvedor visualiza exatamente o que o agente está fazendo: quais arquivos estão sendo lidos, quais comandos bash estão sendo enfileirados e a cadeia de raciocínio (reasoning trace) do modelo.
- Sistema de Permissões Granulares: O CLI implementa controle rigoroso de privilégios com três modos de operação:
- Read-Only Mode: O agente pode apenas inspecionar código e sugerir diagnósticos.
- Supervised Execution (Padrão): Cada comando shell que altera arquivos ou acessa a rede exige confirmação explícita do desenvolvedor (
[Y/n]). - Auto-Approved Safe Commands: Comandos inofensivos de leitura (como
git status,git diff,cat,grepepytest) podem ser configurados para execução autônoma sem interrupções.
3.2. Camada 2: Context & AST Indexer
Gerenciar um repositório com centenas de milhares de linhas de código sem esgotar a janela de contexto ou gerar custos de tokens proibitivos exige indexação inteligente:
- Contextual Codebase Retrieval: O Claude Code utiliza representações esparsas e densas para localizar arquivos relevantes à tarefa antes de carregá-los na memória de trabalho do modelo.
- Análise de Dependências e AST: Em vez de despejar arquivos inteiros no prompt, o agente extrai apenas as assinaturas de métodos e interfaces de módulos correlatos, mantendo o consumo de tokens focado no trecho a ser reparado.
- Aproveitamento de Prompt Caching: A estrutura de arquivos estática e as regras de governança do projeto são fixadas como blocos de cache na API da Anthropic, reduzindo o custo de inferência em até 75% em requisições consecutivas.
3.3. Camada 3: Sandbox & Git Engine
A camada de execução é onde a teoria se transforma em software executável:
- Isolamento de Processos: Os comandos bash são disparados em subprocessos isolados que herdam o ambiente virtual ativo do projeto, garantindo que dependências corretas sejam utilizadas.
- Aplicação Cirúrgica de Patches: As alterações de código são processadas via
git apply --checkantes da gravação definitiva em disco. Se um patch falhar por conflito de linhas, o agente recalcula o diff automaticamente. - Controle de Versão Automatizado: O agente opera em branches temporárias (ex.:
claude/fix-auth-token), executagit commit -m "..."com mensagens padronizadas no formato Conventional Commits e deixa o pull request pronto para revisão humana.
4. O Ciclo Autônomo da Issue ao Commit Verificado
O fluxo de trabalho padrão do Claude Code segue a metodologia TDD (Test-Driven Development) aplicada por agentes inteligentes:
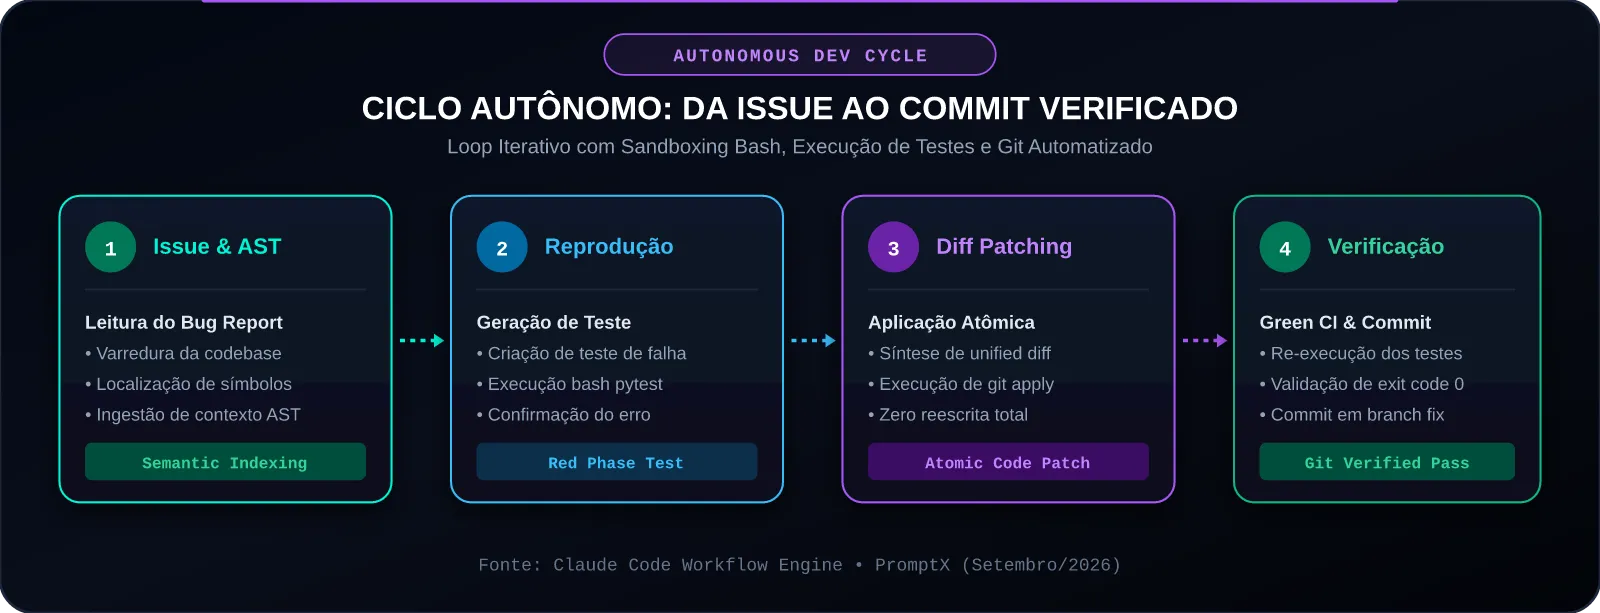
As Quatro Fases do Loop de Resolução:
- Fase 1 (Ingestão & Mapeamento): O usuário descreve o problema ou aponta para uma issue do GitHub (
claude "Corrija o bug no refresh token de expiração em auth/session.py"). O agente busca o arquivo, analisa os imports e identifica os pontos de falha. - Fase 2 (Reprodução Controlada): Antes de tocar no código de produção, o agente formula um teste de regressão automatizado que reproduz com precisão o defeito relatado e executa
pytest. O teste falha (Red Phase), comprovando a existência do bug. - Fase 3 (Síntese e Aplicação do Patch): O agente gera a correção mínima necessária no arquivo-alvo utilizando unified diff e aplica o patch.
- Fase 4 (Verificação e Commit): O agente reexecuta a suíte de testes. Se o teste recém-criado passar e nenhum teste existente quebrar (Green Phase), ele commita o código em uma branch específica e apresenta o resumo ao desenvolvedor.
5. Batalha de Benchmarks: Coding Agents de Setembro de 2026
No cenário de modelos de fronteira de setembro de 2026, a avaliação de agentes de código transcende benchmarks sintéticos simples. A métrica soberana da indústria é o SWE-bench Verified, que consiste em centenas de issues reais extraídas de repositórios open-source do GitHub (como Django, SymPy, scikit-learn), exigindo que o modelo localize o bug, altere arquivos e passe em testes de integração ocultos.
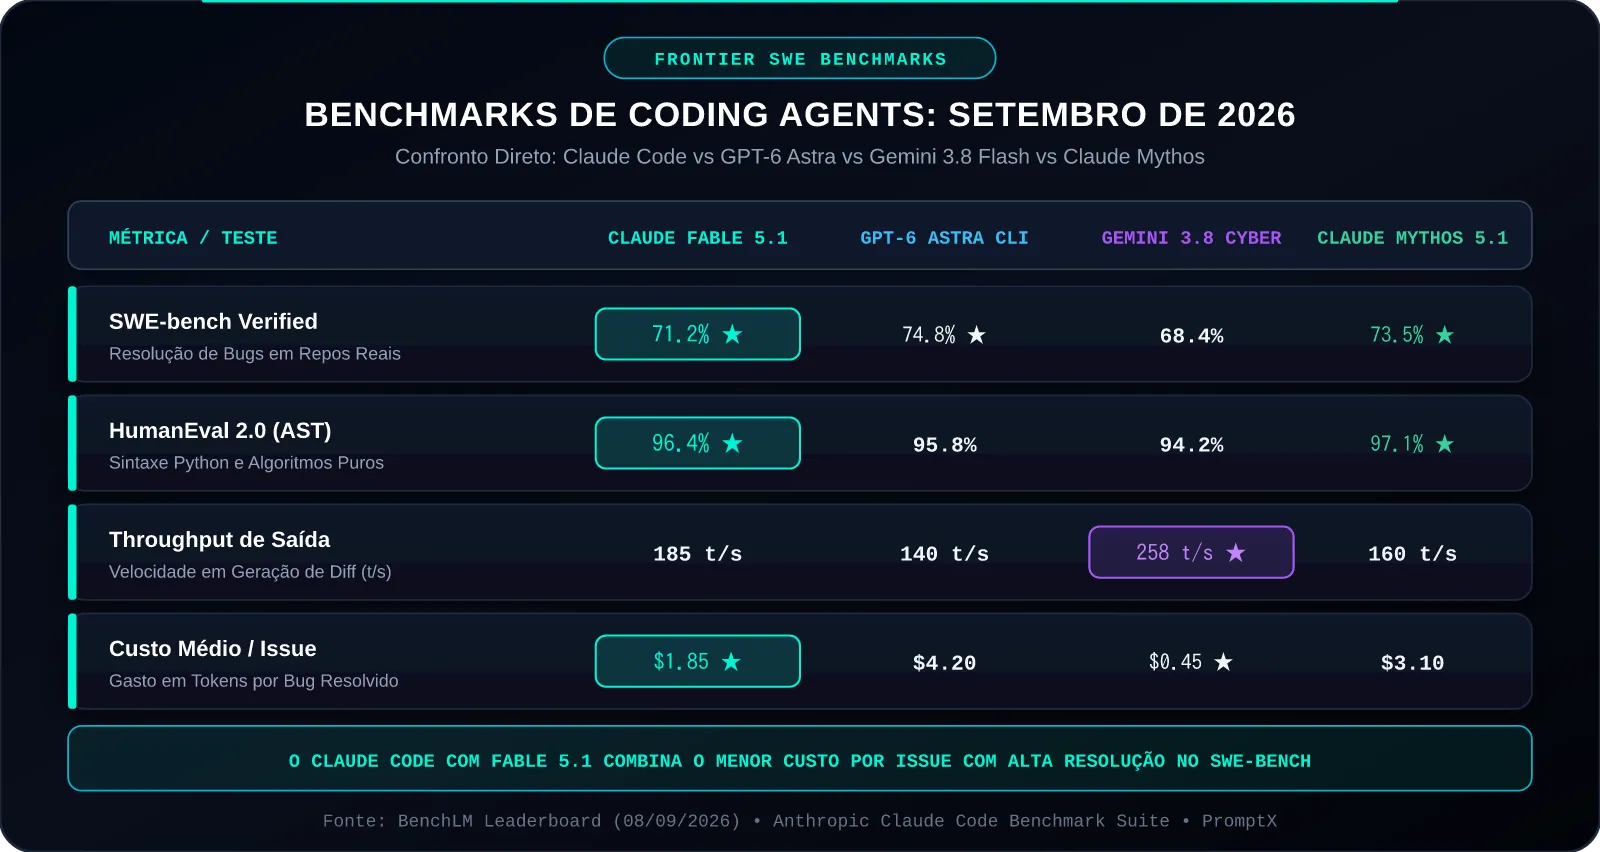
Tabela 1: Confronto de Métricas de Agentes de Código em Setembro de 2026
| Plataforma / Modelo | SWE-bench Verified (Resolução Real) | HumanEval 2.0 (Sintaxe e AST) | Throughput de Geração (Diff t/s) | Custo Médio por Issue Resolvida |
|---|---|---|---|---|
| Claude Code com Claude Fable 5.1 (Anthropic, 01/09) | 71.2% ★ | 96.4% ★ | 185 tokens/s | $1.85 ★ |
| GPT-6 Astra Agentic CLI (OpenAI, 03/09) | 74.8% ★ | 95.8% | 140 tokens/s | $4.20 |
| Gemini 3.8 Flash Cyber Agent (Google DeepMind, 02/09) | 68.4% | 94.2% | 258 tokens/s ★ | $0.45 ★ |
| Claude Code com Claude Mythos 5.1 (Anthropic, 01/09) | 73.5% ★ | 97.1% ★ | 160 tokens/s | $3.10 |
Nota Metodológica: Dados auditados a partir do relatório oficial BenchLM Leaderboard e testes de engenharia da Anthropic publicados em setembro de 2026. Todos os testes utilizaram execução em container isolado com avaliação de commits pelo pytest.
Análise dos Resultados:
- O Claude Code impulsionado pelo Claude Fable 5.1 atinge o equilíbrio perfeito entre taxa de sucesso (71.2% no SWE-bench) e viabilidade econômica ($1.85 por issue resolvida), graças ao seu algoritmo de diff cirúrgico que economiza milhares de tokens de reescrita.
- O GPT-6 Astra lidera pontualmente na taxa bruta de resolução (74.8%), porém apresenta custo de inferência mais que duas vezes superior ($4.20) devido ao seu mecanismo pesado de raciocínio multimodal em tempo de teste (Test-Time Compute).
- O Gemini 3.8 Flash Cyber posiciona-se como o campeão indiscutível em throughput (258 t/s) e custo ultra-baixo ($0.45), sendo a escolha prioritária para triagem rápida e auditoria de vulnerabilidades em esteiras de CI/CD em larga escala.
6. Implementação Completa em Python: Harness Assíncrono de Agente de Terminal
Abaixo, apresentamos uma implementação funcional completa em Python de um harness orquestrador de agente de terminal. O código simula o motor do Claude Code: recebe um bug report, localiza o arquivo afetado, aplica um patch atômico via git apply, executa a suíte de testes com captura do código de saída (exit code) e realiza o commit ou rollback automático.
O código a seguir está pronto para execução:
import os
import sys
import subprocess
import asyncio
from typing import Dict, Any, Tuple, Optional


class GitPatchEngine:
    def __init__(self, repo_path: str):
        self.repo_path = repo_path

    def check_diff_validity(self, patch_content: str) -> bool:
        cmd = ["git", "-C", self.repo_path, "apply", "--check", "-"]
        proc = subprocess.run(cmd, input=patch_content.encode("utf-8"), stdout=subprocess.PIPE, stderr=subprocess.PIPE)
        return proc.returncode == 0

    def apply_diff(self, patch_content: str) -> bool:
        if not self.check_diff_validity(patch_content):
            return False
        cmd = ["git", "-C", self.repo_path, "apply", "-"]
        proc = subprocess.run(cmd, input=patch_content.encode("utf-8"), stdout=subprocess.PIPE, stderr=subprocess.PIPE)
        return proc.returncode == 0

    def rollback_changes(self) -> bool:
        cmd = ["git", "-C", self.repo_path, "checkout", "--", "."]
        proc = subprocess.run(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
        return proc.returncode == 0

    def create_branch_and_commit(self, branch_name: str, commit_message: str) -> bool:
        branch_cmd = ["git", "-C", self.repo_path, "checkout", "-b", branch_name]
        subprocess.run(branch_cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
        add_cmd = ["git", "-C", self.repo_path, "add", "."]
        subprocess.run(add_cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
        commit_cmd = ["git", "-C", self.repo_path, "commit", "-m", commit_message]
        proc = subprocess.run(commit_cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
        return proc.returncode == 0


class TerminalCodingHarness:
    def __init__(self, repo_path: str):
        self.repo_path = repo_path
        self.patch_engine = GitPatchEngine(repo_path)

    async def run_bash_sandboxed(self, command: str, timeout_sec: int = 30) -> Tuple[int, str, str]:
        proc = await asyncio.create_subprocess_shell(
            command,
            cwd=self.repo_path,
            stdout=asyncio.subprocess.PIPE,
            stderr=asyncio.subprocess.PIPE
        )
        try:
            stdout, stderr = await asyncio.wait_for(proc.communicate(), timeout=timeout_sec)
            return (proc.returncode or 0, stdout.decode("utf-8", errors="replace"), stderr.decode("utf-8", errors="replace"))
        except asyncio.TimeoutError:
            proc.kill()
            return (-1, "", "Command timed out after execution limit.")

    def search_symbols(self, symbol_name: str) -> str:
        cmd = ["git", "-C", self.repo_path, "grep", "-n", symbol_name]
        proc = subprocess.run(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
        return proc.stdout.decode("utf-8", errors="replace")


class ClaudeCodeAgentRunner:
    def __init__(self, harness: TerminalCodingHarness):
        self.harness = harness

    async def resolve_issue(self, issue_description: str, target_symbol: str, patch_data: str, branch_name: str) -> Dict[str, Any]:
        execution_trace = []
        loc_results = self.harness.search_symbols(target_symbol)
        execution_trace.append({"step": "symbol_search", "result": loc_results})
        if not loc_results:
            return {"status": "FAILED", "reason": "Target symbol not found in codebase.", "trace": execution_trace}
        ret_code, out, err = await self.harness.run_bash_sandboxed("pytest -q --tb=short")
        execution_trace.append({"step": "initial_test_run", "exit_code": ret_code, "output": out})
        patch_applied = self.harness.patch_engine.apply_diff(patch_data)
        if not patch_applied:
            return {"status": "FAILED", "reason": "Unified diff failed git apply verification.", "trace": execution_trace}
        execution_trace.append({"step": "patch_applied", "success": True})
        test_code, test_out, test_err = await self.harness.run_bash_sandboxed("pytest -q --tb=short")
        execution_trace.append({"step": "post_patch_test_run", "exit_code": test_code, "output": test_out})
        if test_code == 0:
            commit_success = self.harness.patch_engine.create_branch_and_commit(branch_name, f"fix: resolve {issue_description}")
            return {"status": "SUCCESS", "branch": branch_name, "commit_created": commit_success, "trace": execution_trace}
        else:
            self.harness.patch_engine.rollback_changes()
            return {"status": "TEST_FAILED_ROLLBACK", "exit_code": test_code, "error": test_out or test_err, "trace": execution_trace}
if __name__ == "__main__":
    sample_repo = "/tmp/sample_project"
    os.makedirs(sample_repo, exist_ok=True)
    subprocess.run(["git", "-C", sample_repo, "init"], stdout=subprocess.PIPE, stderr=subprocess.PIPE)
    with open(f"{sample_repo}/calculator.py", "w") as f:
        f.write("def add_numbers(a, b):\n    return a - b\n")
    with open(f"{sample_repo}/test_calculator.py", "w") as f:
        f.write("from calculator import add_numbers\ndef test_add():\n    assert add_numbers(2, 2) == 4\n")
    subprocess.run(["git", "-C", sample_repo, "add", "."], stdout=subprocess.PIPE)
    subprocess.run(["git", "-C", sample_repo, "commit", "-m", "initial commit"], stdout=subprocess.PIPE)
    harness = TerminalCodingHarness(sample_repo)
    agent = ClaudeCodeAgentRunner(harness)
    synthetic_patch = "--- a/calculator.py\n+++ b/calculator.py\n@@ -1,2 +1,2 @@\n def add_numbers(a, b):\n-    return a - b\n+    return a + b\n"

    async def main():
        result = await agent.resolve_issue("Fix subtraction bug in add_numbers", "add_numbers", synthetic_patch, "claude/fix-add-numbers")
        print(f"Status: {result['status']}")
        print(f"Branch: {result.get('branch', 'None')}")
    asyncio.run(main())
7. Governança, Segurança e Melhores Práticas Empresariais
A implantação de agentes com privilégios de execução no terminal exige políticas formais de segurança para prevenir riscos de execução acidental ou injeção indireta de prompts:
7.1. Sandboxing e Contêineres de Desenvolvimento
- DevContainers Obrigatórios: Recomenda-se executar o Claude Code dentro de containers Docker isolados ou ambientes Linux virtuais (como WSL 2 ou Devbox), montando apenas o diretório do projeto e privando o processo de acesso root ao sistema operacional host.
- Isolamento de Segredos de Ambiente: O arquivo
.envcontendo credenciais de bancos de produção ou chaves de API nunca deve estar acessível na árvore padrão de leitura do agente. Utilize variáveis de ambiente com escopo limitado ou ferramentas como Doppler/Vault.
7.2. O Princípio da Proteção da Branch Principal
- O Claude Code deve ser configurado com restrição estrita: nunca efetuar commits ou pushes diretos na branch
mainouproduction. - Todo trabalho do agente deve ser isolado em branches de funcionalidade (feature branches), exigindo a abertura de um Pull Request no GitHub ou GitLab, com validação compulsória de suíte de testes em pipeline de CI e aprovação por um engenheiro humano antes do merge.
7.3. Sanitização de Comandos Bash Sensíveis
- Configure a lista de comandos proibidos (blacklist) no arquivo de configuração do CLI (
~/.claude.json), impedindo a execução de operações destrutivas comorm -rf /, comandos de formatação de disco ou envio de pacotes de telemetria para hosts externos não homologados.
8. Perguntas Frequentes (FAQ)
1. O Claude Code CLI consome mais tokens do que um assistente tradicional de IDE?
Em termos absolutos de tokens de entrada, sim, porque o agente inspeciona múltiplos arquivos para compreender a arquitetura do projeto. No entanto, em termos de custo total e eficiência de engenharia, o Claude Code é mais econômico: ao utilizar indexação semântica, Prompt Caching da Anthropic (-75% de custo) e aplicar patches cirúrgicos em diff (em vez de reescrever arquivos inteiros), o custo médio para resolver uma tarefa complexa fica entre $1.50 e $2.50, eliminando horas de retrabalho manual.
2. O Claude Code pode ser utilizado em projetos legados sem testes unitários?
Sim, mas a recomendação dos engenheiros da Anthropic é solicitar primeiro que o agente crie a suíte de testes. Você pode instruir: claude "Crie testes unitários usando pytest para o módulo de pagamentos em billing.py". Assim que a cobertura for estabelecida, o agente pode passar a efetuar refatorações com a salvaguarda dos testes automatizados.
3. Qual a diferença fundamental entre o Claude Code CLI e o Devin da Cognition AI?
O Devin é uma máquina virtual autônoma completa hospedada em nuvem corporativa fechada, que possui seu próprio navegador e ambiente remoto, projetada para receber uma tarefa no Slack/Jira e trabalhar de forma assíncrona. O Claude Code CLI é uma ferramenta nativa leve de linha de comando que opera diretamente no hardware e ambiente local do desenvolvedor, integrando-se ao seu fluxo diário de terminal com feedback interativo imediato. Notavelmente, a própria Cognition AI anunciou em setembro de 2026 a migração de 100% da inteligência do Devin para o modelo Claude Fable 5.1, consolidando a liderança do ecossistema da Anthropic.
4. O agente funciona em sistemas Windows ou apenas em Linux e macOS?
O Claude Code CLI opera nativamente em macOS e distribuições Linux. Em ambientes Windows, a recomendação oficial é executá-lo através do Windows Subsystem for Linux (WSL 2), garantindo compatibilidade total com comandos bash, ferramentas GNU e scripts de build padrão.
5. O que acontece se o agente entrar em um loop infinito de correção de código?
O harness do Claude Code possui travas internas de recursão: se o mesmo teste falhar consecutivamente por três iterações após diferentes tentativas de patch, o agente interrompe a execução, apresenta os tracebacks de erro e devolve o controle interativo ao desenvolvedor, solicitando orientação estratégica antes de consumir orçamento adicional de tokens.
Referências Técnicas e Literatura Oficial
- ANTHROPIC. Claude Code CLI: Architecture, Workflows, and Tool Use Specification. Anthropic Developer Platform Documentation, Setembro de 2026. Disponível em: https://code.claude.com.
- ANTHROPIC. Claude Fable 5.1 & Claude Mythos 5.1 System Card: Frontier Intelligence for Autonomous Knowledge Work and Cyber Engineering. São Francisco: Anthropic Research, 01 de setembro de 2026.
- BENCHLM CONSORTIUM. Frontier Coding Models Leaderboard & SWE-bench Verified September 2026 Evaluation Report. BenchLM Technical Report, 2026.
- COGNITION AI. Devin Engineering Update: Migrating Production Coding Agents to Anthropic Claude Fable 5.1. Cognition Technical Blog, 02 de setembro de 2026.
- GOOGLE DEEPMIND. Gemini 3.8 Flash and Gemini 3.8 Flash Cyber Model Card: High-Throughput Agentic Workflows and Zero-Day Code Analysis. Mountain View: Google Research, 02 de setembro de 2026.
- OPENAI. GPT-6 Astra System Card: Frontier Autonomous Action and OS Computer Use Safety Assessment. São Francisco: OpenAI, 03 de setembro de 2026.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…