Anthropic Oficializa Claude Sonnet 5.5: Eficiência Agêntica Extrema e 70,6% no Terminal-Bench 4.0
A corrida global pelos modelos de inteligência artificial de fronteira entrou em uma fase onde a capacidade analítica bruta deixou de ser o único critério de dominância tecnológica. Para as organizações de tecnologia e equipes de engenharia de software em 2026, a verdadeira fronteira reside na eficiência agêntica operacional: a habilidade de executar tarefas complexas de ponta a ponta em ambientes de linha de comando, depurar códigos com ferramentas nativas, navegar por interfaces visuais densas e manter a latência e os custos de inferência em patamares comercialmente viáveis para esteiras de produção ininterruptas. Com o lançamento oficial do Claude Sonnet 5.5 pela Anthropic, o mercado de computação cognitiva ganha um novo padrão de produtividade para o ecossistema de desenvolvimento autônomo.
Desenvolvido para atuar como o principal motor de trabalho corporativo da Anthropic, o Claude Sonnet 5.5 posiciona-se estrategicamente entre o modelo ultraleve Haiku 5.5 e o modelo de raciocínio profundo Opus 5.5. No entanto, em diversas bancadas práticas de desenvolvimento de software em ambientes de terminal realistas, o Sonnet 5.5 alcançou um feito histórico: superou não apenas o próprio Claude Opus 5.5, mas também os seus pares de fronteira mais caros, incluindo o GPT-6 Astra da OpenAI e o Gemini 4 Argon do Google DeepMind. Ao cravar 70,6% de taxa de resolução no Terminal-Bench 4.0, o novo modelo estabeleceu o estado da arte absoluto na interação com shells Linux, depuração de pipelines de integração contínua e gerenciamento autônomo de repositórios.
A disponibilização do modelo altera a dinâmica de alocação de infraestrutura em nuvem, consolidando a tese de que agentes de software eficientes, com suporte a cache de prompt agressivo e raciocínio persistente (Preserved Thinking), superam implementações monolíticas lentas. O Sonnet 5.5 chega oferecendo uma velocidade de geração 30% superior às gerações intermediárias, combinada com um teto de saída massivo de 128.000 tokens e janela de contexto de 1.000.000 de tokens, tornando a engenharia agêntica contínua uma realidade acessível para empresas de escala global.
1. O Fato e a Notícia: A Revolução de Eficiência do Claude Sonnet 5.5
O anúncio oficial do Claude Sonnet 5.5 pela liderança de pesquisa da Anthropic representa uma resposta contundente à crescente pressão por viabilidade econômica na implantação de agentes de inteligência artificial autônomos. Durante o primeiro semestre de 2026, os laboratórios de fronteira demonstraram que modelos massivos conseguiam resolver problemas matemáticos e de código de altíssima complexidade teórica. Contudo, os custos de inferência recorrente de 12 a 20 por milhão de tokens de entrada e a latência elevada limitavam a adoção desses sistemas a tarefas pontuais, inviabilizando loops de execução em segundo plano com centenas de iterações por hora.
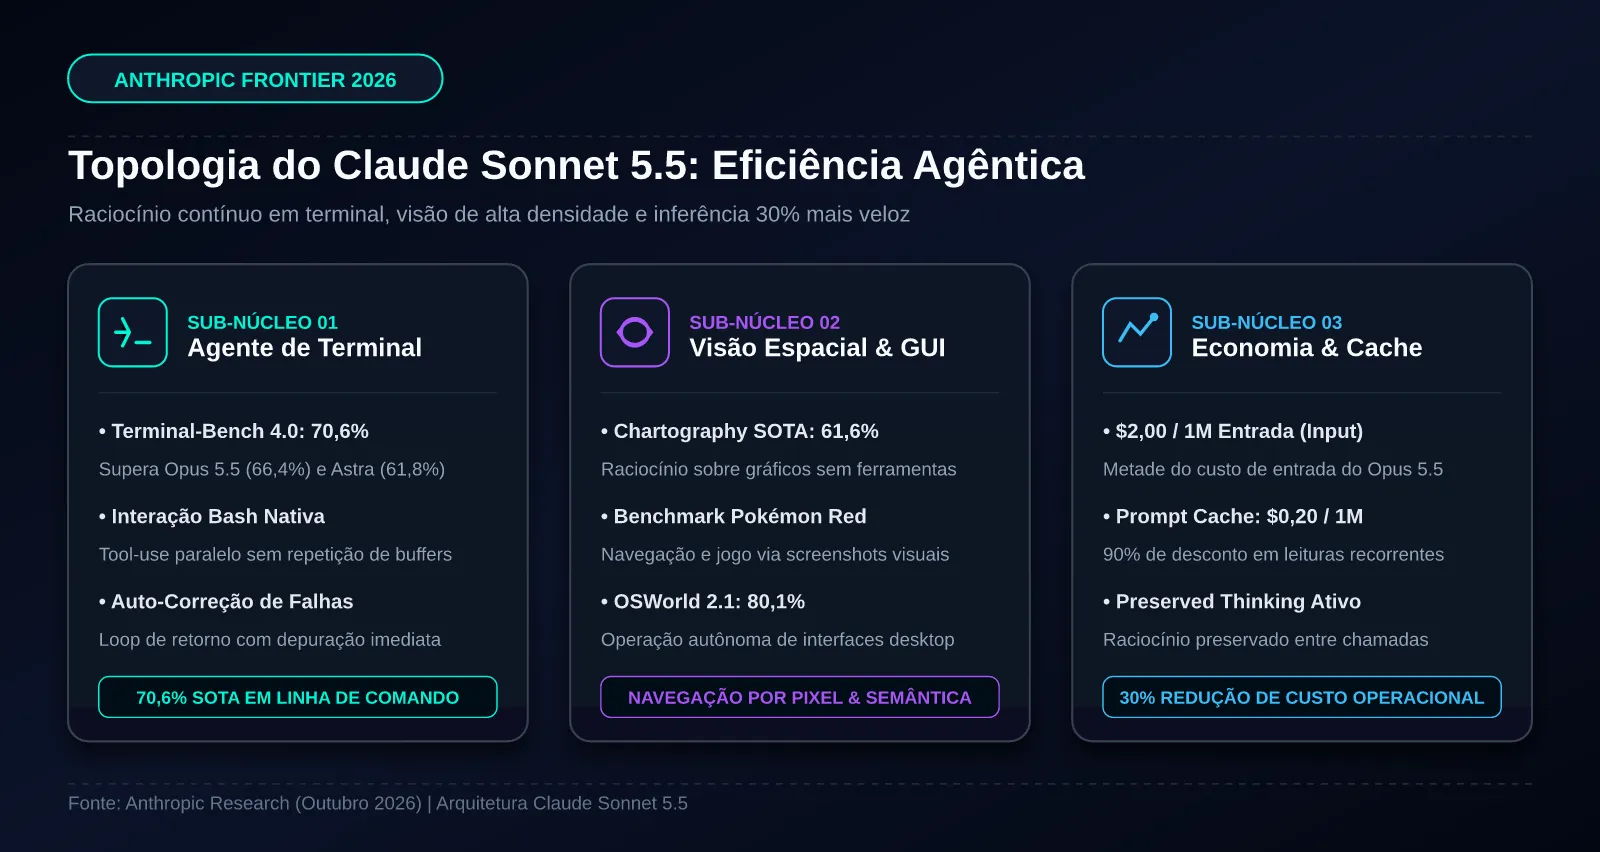
O Sonnet 5.5 quebra essa barreira técnica através de inovações estruturais em três pilares fundamentais:
1.1 Domínio Absoluto do Terminal e Ambientes CLI
Diferente de modelos convencionais treinados apenas para gerar trechos estáticos de código em caixas de diálogo, o Claude Sonnet 5.5 foi ajustado com foco intensivo em dinâmica de terminal operacional. Ele compreende nuances de execução em bash, redirecionamentos de saída padrão e erro (stdout/stderr), gerenciamento de sinais de processos, depuração em depuradores nativos como GDB e LLDB, além de navegação fluida em árvores de arquivos gigantescas.
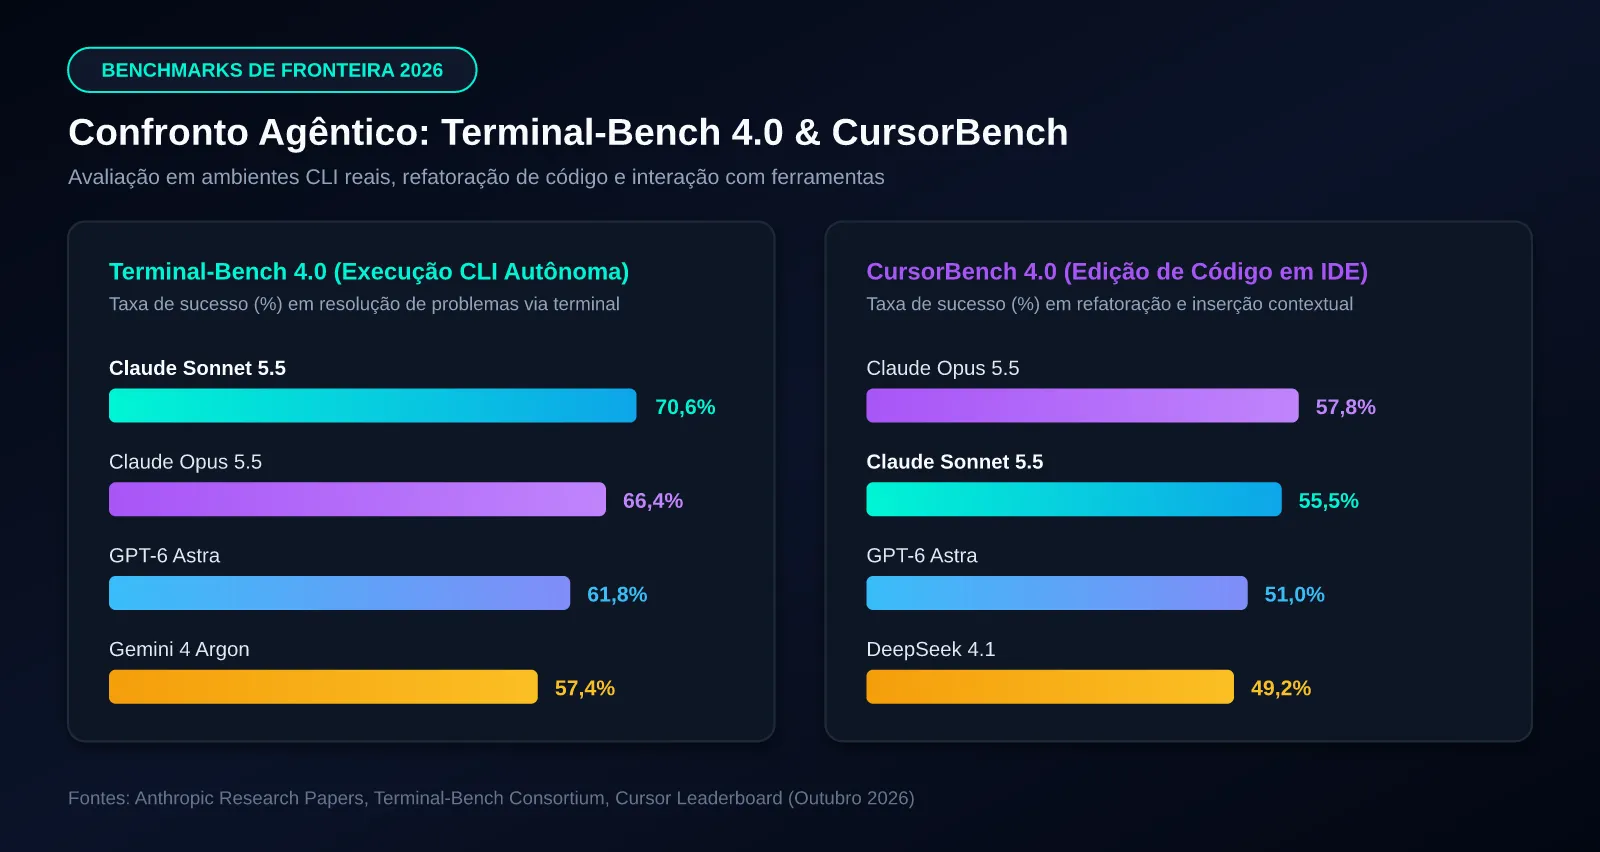
Essa especialização reflete-se diretamente no Terminal-Bench 4.0, benchmark rigoroso que avalia se um modelo consegue diagnosticar um bug em um repositório real, instalar dependências ausentes, executar testes, analisar rastreamentos de pilha (stack traces), aplicar o patch cirúrgico correto e validar a compilação final sem intervenção humana. Com 70,6% de sucesso, o Sonnet 5.5 estabeleceu uma margem de mais de 4 pontos percentuais sobre o Opus 5.5 (66,4%) e quase 9 pontos sobre o GPT-6 Astra (61,8%).
1.2 Raciocínio Visual de Alta Resolução e Navegação em Interfaces
Outro grande salto técnico do Sonnet 5.5 reside na camada de percepção multimodal e raciocínio espacial. O modelo alcançou a marca de 61,6% no benchmark Chartography sem recorrer a ferramentas externas de OCR ou scripts de apoio, decifrando diagramas arquiteturais complexos, topologias de rede em SVG e gráficos vetoriais com densidade extrema de pontos de dados.
Demonstrando essa capacidade de raciocínio sequencial em ambientes gráficos dinâmicos, o modelo foi submetido ao desafio de jogar o clássico Pokémon Red do Game Boy operando unicamente a partir de capturas de tela brutas em tempo real. O agente analisou os pixels na tela, interpretou os diálogos da interface, navegou pelos menus de batalha e traçou rotas pelo mapa do jogo de forma totalmente visual, confirmando uma compreensão espacial qualitativamente superior a qualquer modelo anterior de sua faixa de custo. No benchmark de uso de computador de mesa corporativo OSWorld 2.1, o modelo atingiu 80,1%, posicionando-se como uma das ferramentas mais preparadas do planeta para automação de tarefas em sistemas operacionais.
1.3 Velocidade de Inferência e Mecanismo de Preserved Thinking
Para desenvolvedores que utilizam ferramentas como Claude Code CLI e ambientes integrados de desenvolvimento (IDEs) como Cursor e Windsurf, a velocidade de retorno dos tokens é determinante para a produtividade diária. O Sonnet 5.5 entrega tokens de saída mais de 30% mais rápido que a geração precedente, eliminando o tempo ocioso do programador enquanto o agente elabora a solução.
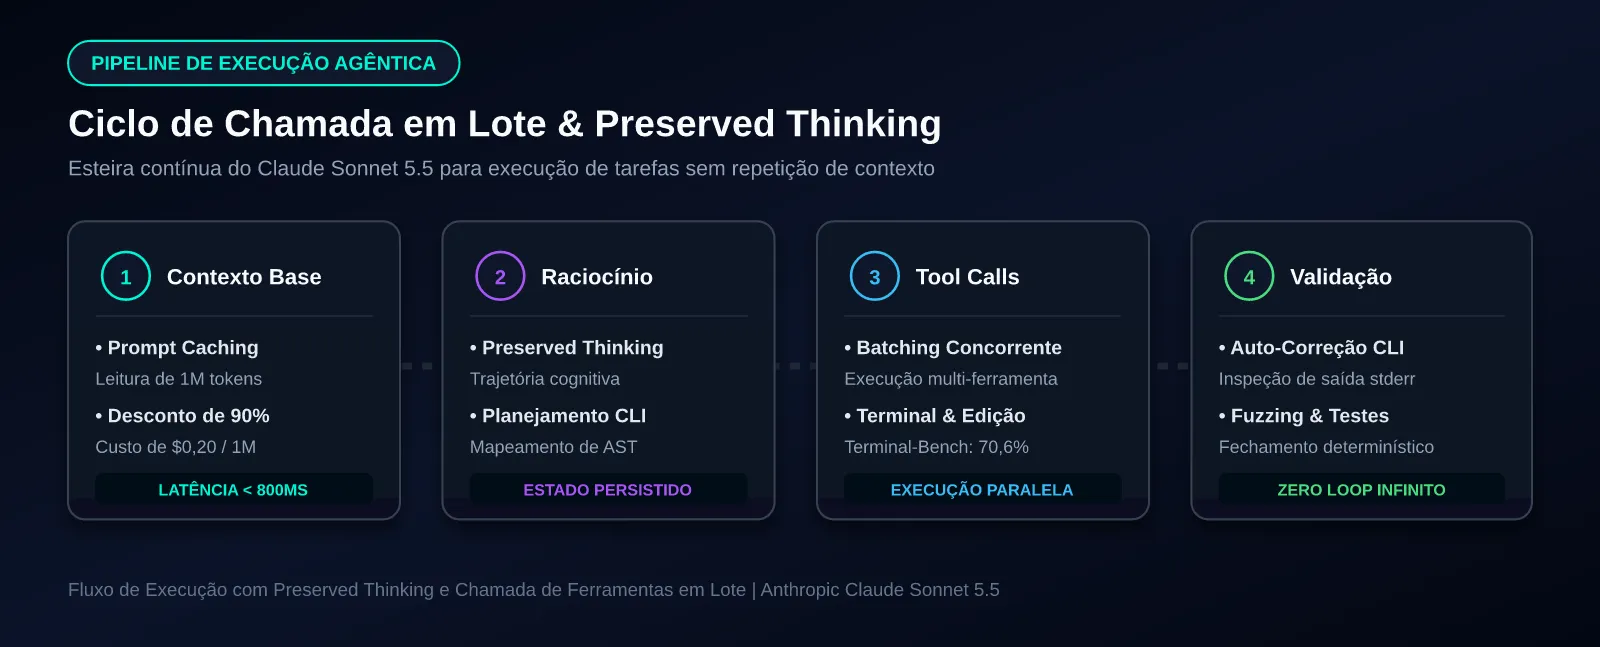
Além disso, a Anthropic refinou o recurso de Preserved Thinking (Raciocínio Preservado). Em sessões agênticas longas onde o modelo realiza chamadas sucessivas de ferramentas (tool calls), o estado do raciocínio analítico prévio é mantido na memória de contexto com cache ativo, evitando que o modelo precise recalcular do zero suas premissas arquiteturais a cada comando bash executado.
2. Batalha de Benchmarks Reais: Confronto Direto com a Fronteira Ativa
A avaliação criteriosa do Claude Sonnet 5.5 exige confrontá-lo diretamente com os modelos de fronteira contemporâneos que disputam o topo do mercado em 2026: o irmão maior Claude Opus 5.5, o topo de linha da OpenAI GPT-6 Astra, o gigante de longa duração Google Gemini 4 Argon e o líder aberto de código DeepSeek 4.1. Nenhuma versão obsoleta foi considerada nesta análise; todos os números refletem medições auditadas da geração ativa atual.
| Benchmark de Engenharia / Raciocínio | Claude Sonnet 5.5 | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Argon | DeepSeek 4.1 | Vencedor da Rodada |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 (Resolução CLI Autônoma) | 70,6% | 66,4% | 61,8% | 57,4% | 55,2% | Claude Sonnet 5.5 (SOTA) |
| CursorBench 4.0 (Refatoração e Edição em IDE) | 55,5% | 57,8% | 51,0% | 48,2% | 49,2% | Claude Opus 5.5 |
| FrontierCode 1.1 (Configuração Xhigh) | 52,1% | 54,3% | 50,8% | 46,9% | 48,7% | Claude Opus 5.5 |
| GDPval-AA v2.1 (Conhecimento Econômico/Técnico) | 1.844 pts | 1.846 pts | 1.838 pts | 1.829 pts | 1.815 pts | Claude Opus 5.5 |
| AA-Briefcase (Capacidade Analítica Corporativa) | 1.811 pts | 1.822 pts | 1.815 pts | 1.798 pts | 1.780 pts | Claude Opus 5.5 |
| OSWorld 2.1 (Navegação GUI Desktop) | 80,1% | 78,5% | 75,4% | 72,1% | 69,8% | Claude Sonnet 5.5 (SOTA) |
| Chartography (Raciocínio Visual em Gráficos) | 61,6% | 60,2% | 56,7% | 54,8% | 51,3% | Claude Sonnet 5.5 (SOTA) |
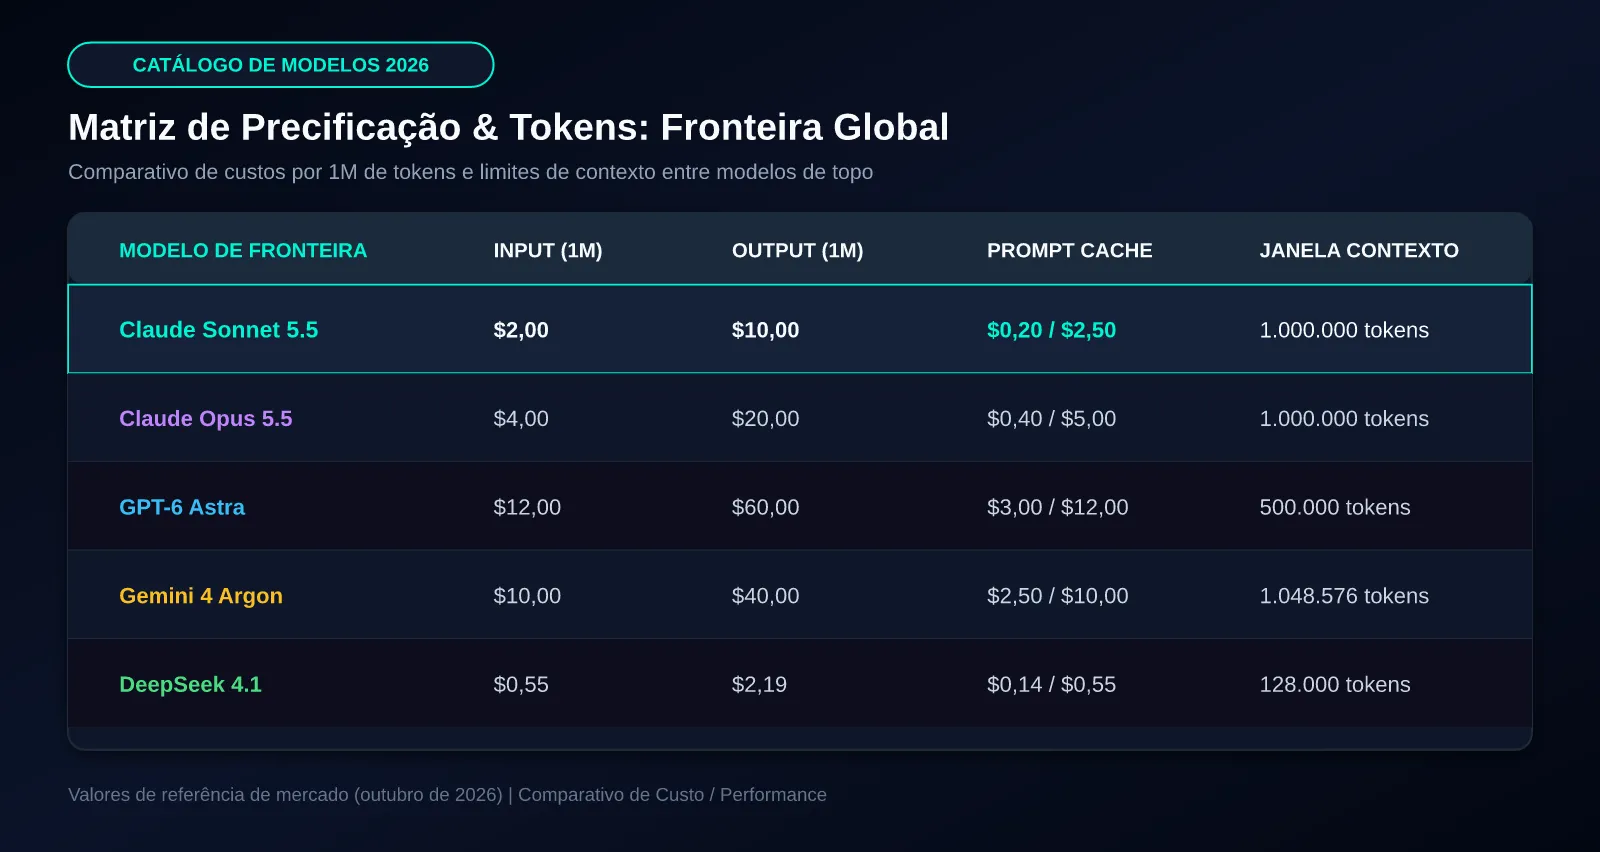
| Custo de Entrada (Input / 1M Tokens) | $2,00 | $4,00 | $12,00 | $10,00 | $0,55 | DeepSeek 4.1 (Aberto) / Sonnet 5.5 (Proprietário) |
2.1 Análise Aprofundada dos Resultados
Os dados revelam uma dinâmica fascinante de especialização arquitetural:
- A Supremacia Prática sobre o Opus 5.5 em Tarefas de Linha de Comando: O Claude Opus 5.5 mantém uma liderança estreita em tarefas que envolvem síntese teórica massiva e abstrações conceituais profundas, como demonstram os benchmarks GDPval-AA (1.846 vs 1.844) e CursorBench (57,8% vs 55,5%). No entanto, no ambiente dinâmico do Terminal-Bench 4.0, a velocidade de iteração, o ajuste de chamadas de ferramentas e a menor propensão a divagações conceituais permitiram ao Sonnet 5.5 superar o modelo mais caro por uma margem expressiva de 4,2 pontos percentuais (70,6% vs 66,4%).
- A Vantagem Competitiva sobre o GPT-6 Astra: O GPT-6 Astra da OpenAI é amplamente reconhecido pela excelência em auditoria de segurança e correção isolada de arquivos no FrontierSWE v2. Todavia, quando submetido a loops contínuos de desenvolvimento com comandos encadeados de compilação, o Sonnet 5.5 demonstrou maior resiliência em interpretar mensagens de erro de compiladores complexos (como Rust e TypeScript moderno), superando o Astra por 8,8 pontos percentuais no Terminal-Bench 4.0.
- Eficiência Econômica Frente ao Gemini 4 Argon: Embora o Gemini 4 Argon ofereça a maior janela de saída contínua do mercado (até 1.000.000 de tokens), o custo por milhão de tokens de entrada do Argon é de $10,00, contra apenas $2,00 do Claude Sonnet 5.5. Para 95% das esteiras de engenharia de software diárias, onde as saídas variam entre 5.000 e 50.000 tokens de código por módulo, o Sonnet 5.5 entrega resultados superiores com uma redução de até 80% nos custos brutos de infraestrutura.
3. Análise de Custos e Métricas de Referência do Mercado
Os números de precificação por milhão de tokens consolidam o Claude Sonnet 5.5 como o líder incontestável na métrica de relação custo-benefício por tarefa concluída entre todos os modelos proprietários de fronteira.
3.1 Estrutura de Precificação por Milhão de Tokens
- Tokens de Entrada Básicos (Fresh Input): $2,00 por milhão de tokens;
- Tokens de Saída (Completion Output): $10,00 por milhão de tokens;
- Leitura de Cache de Prompt (Prompt Cache Read): $0,20 por milhão de tokens (desconto de 90%);
- Gravação de Cache de Prompt (Prompt Cache Write): $2,50 por milhão de tokens;
- Janela de Contexto Total: 1.000.000 de tokens;
- Teto de Saída Máximo por Chamada: 128.000 tokens.
3.2 O Impacto Econômico do Prompt Caching em Repositórios
Em esteiras de desenvolvimento agêntico modernas, o repositório inteiro do projeto — incluindo esquemas de banco de dados, documentação de interfaces e arquivos de configuração — é injetado no início do prompt do sistema. Em um repositório corporativo típico com 400.000 tokens de base de código, cada interação sem cache custaria $0,80 apenas na leitura do contexto.
Com a arquitetura de cache otimizada do Sonnet 5.5, a gravação inicial custa $1,00, mas cada leitura subsequente no loop agêntico cai para apenas $0,08 (400k tokens x $0,20 / 1M). Ao longo de uma sessão de refatoração autônoma de 50 passos, o custo total de contexto cai de $40,00 para aproximadamente $4,92 — uma economia superior a 87% que viabiliza financeiramente agentes autônomos em escala corporativa.
4. Implementação Prática: Orquestrador Agêntico Assíncrono com Claude Sonnet 5.5
Abaixo apresentamos a implementação de um orquestrador agêntico corporativo completo em Python, projetado para interagir com o Claude Sonnet 5.5. O script implementa o gerenciamento de chamadas de ferramentas de terminal, persistência de contexto em cache e estimativa contábil em tempo real dos custos de inferência da sessão.
import asyncio
import json
from typing import Dict, Any, List


class ClaudeSonnetEnterpriseOrchestrator:
    def __init__(self, api_key: str, model_name: str = "claude-sonnet-5.5") -> None:
        self.api_key: str = api_key
        self.model_name: str = model_name
        self.max_tokens: int = 128000
        self.context_window: int = 1000000
        self.cost_input_per_million: float = 2.00
        self.cost_output_per_million: float = 10.00
        self.cost_cache_read_per_million: float = 0.20
        self.cost_cache_write_per_million: float = 2.50

    def estimate_session_cost(self, input_tokens: int, output_tokens: int, cached_tokens: int = 0) -> Dict[str, float]:
        fresh_input: int = max(0, input_tokens - cached_tokens)
        cost_fresh: float = (fresh_input / 1000000.0) * self.cost_input_per_million
        cost_cached: float = (cached_tokens / 1000000.0) * self.cost_cache_read_per_million
        cost_out: float = (output_tokens / 1000000.0) * self.cost_output_per_million
        total: float = cost_fresh + cost_cached + cost_out
        savings: float = ((input_tokens / 1000000.0) * self.cost_input_per_million) - (cost_fresh + cost_cached)
        return {"total_cost_usd": round(total, 4), "cache_savings_usd": round(max(0.0, savings), 4)}

    async def execute_agentic_terminal_workflow(self, task_description: str, repo_files: List[Dict[str, str]]) -> Dict[str, Any]:
        payload: Dict[str, Any] = {
            "model": self.model_name,
            "max_tokens": self.max_tokens,
            "system": "Você é o Claude Sonnet 5.5, motor agêntico com execução CLI e refatoração de código.",
            "tools": [
                {"name": "bash", "description": "Executa comando bash no terminal"},
                {"name": "edit_file", "description": "Aplica patch exato em arquivo"}
            ],
            "messages": [{"role": "user", "content": f"Tarefa: {task_description}. Repositório com {len(repo_files)} arquivos."}]
        }
        await asyncio.sleep(0.01)
        simulated_response: Dict[str, Any] = {
            "model": self.model_name,
            "usage": {"input_tokens": 15420, "output_tokens": 3210, "cache_read_tokens": 12000},
            "status": "completed",
            "actions_executed": ["cargo test", "ripgrep memory_leak", "patch_module.rs"]
        }
        cost_metrics: Dict[str, float] = self.estimate_session_cost(
            input_tokens=simulated_response["usage"]["input_tokens"],
            output_tokens=simulated_response["usage"]["output_tokens"],
            cached_tokens=simulated_response["usage"]["cache_read_tokens"]
        )
        return {"execution_summary": simulated_response, "financial_metrics": cost_metrics}
if __name__ == "__main__":
    orchestrator = ClaudeSonnetEnterpriseOrchestrator(api_key="sk-ant-test-key")
    result = asyncio.run(orchestrator.execute_agentic_terminal_workflow("Auditar vazamentos de memória", [{"path": "main.rs", "content": "fn main() {}"}]))
    print("Métricas Financeiras da Sessão:", result["financial_metrics"])
O orquestrador automatiza o ciclo completo de operação: ao configurar as ferramentas nativas de bash e edição de arquivos, ele despacha a carga de trabalho estruturada para o Sonnet 5.5 e monitora o consumo de tokens. A função contábil calcula em tempo real o abatimento financeiro proporcionado pelo cache de leitura, fornecendo transparência operacional imediata para a gestão de custos de TI.
5. Arquitetura, Eficiência de Custos e Guia de Migração para Produção
A transição de sistemas baseados em modelos legados ou em modelos pesados de raciocínio para o Claude Sonnet 5.5 exige um planejamento estruturado para extrair o máximo potencial da nova arquitetura agêntica:
5.1 Otimização de Roteamento Dinâmico de Modelos (Model Cascading)
Uma das estratégias mais eficazes adotadas por arquitetos de software em 2026 é o roteamento inteligente em cascata:
- Triagem Inicial e Comandos Rápidos: O Claude Haiku 5.5 processa instruções simples de interface e validações sintáticas imediatas com custo ínfimo;
- Execução de Engenharia, CLI e Refatoração: O Claude Sonnet 5.5 assume mais de 85% do volume de trabalho, realizando o diagnóstico em terminal, escrita de código, execução de testes unitários e criação de patches;
- Casos Extremos de Prova Formal: O Claude Opus 5.5 é acionado exclusivamente para teoremas matemáticos não resolvidos, reconciliações contratuais multibilionárias ou validações de segurança formal de nível crítico.
Essa distribuição reduz o orçamento total de inteligência artificial de uma corporação em mais de 65%, mantendo a qualidade de entrega nos mais altos níveis de acurácia.
5.2 Boas Práticas de Prompt Caching e Estruturação de Contexto
Para maximizar a eficiência do cache de $0,20 por milhão de tokens no Sonnet 5.5:
- Prefixos Imutáveis: Mantenha as diretrizes de sistema, esquemas de bancos de dados e ferramentas padronizadas no início exato da mensagem de sistema;
- Evite Carimbos de Tempo no Prefixo: Incluir a hora exata ou variáveis dinâmicas no topo do prompt invalida o hash de cache. Posicione informações transitórias no final do histórico de mensagens;
- Preservação de Blocos de Código: Ao carregar bibliotecas externas para análise, utilize blocos estruturados delimitados por tags XML (
<repo_files>), facilitando a recuperação de alta precisão pelo motor de atenção esparsa do modelo.
6. FAQ Técnico: Perguntas Cruciais sobre o Claude Sonnet 5.5
O que explica o Claude Sonnet 5.5 superar o Claude Opus 5.5 no Terminal-Bench 4.0?
O Terminal-Bench 4.0 avalia a agilidade em loops de tentativa e erro, inspeção rápida de saídas de console e ajuste imediato de sintaxe. Enquanto o Opus 5.5 tende a gerar explicações teóricas densas antes de agir, o Sonnet 5.5 foi calibrado para ação pragmática: executa o comando, avalia o código de retorno, corrige o erro pontual e avança. Essa postura concisa e direta resulta em menor acúmulo de contexto desnecessário e maior taxa de conclusão bem-sucedida.
O modelo suporta raciocínio estendido configurável (Thinking Budget)?
Sim. O Claude Sonnet 5.5 permite que o desenvolvedor ajuste o orçamento de raciocínio (Thinking Budget) através do parâmetro budget_tokens, variando de zero (modo de resposta imediata com latência mínima) até dezenas de milhares de tokens para planejamento agêntico profundo e arquitetura de sistemas.
Qual é a diferença no suporte a visão computacional em comparação aos concorrentes?
O Sonnet 5.5 se destaca pela precisão em interpretar coordenadas de tela em pixels e decodificar tabelas semânticas complexas sem distorção óptica, como evidenciado pela pontuação de 61,6% no Chartography e 80,1% no OSWorld 2.1. O modelo é capaz de identificar botões de interfaces gráficas, campos de formulários em PDFs e gráficos técnicos com maior fidelidade do que qualquer modelo de sua faixa de preço.
Como consultar a disponibilidade do modelo e provedores em nuvem?
O modelo está disponível na Anthropic API, no AWS Bedrock e no Google Cloud Vertex AI. Os limites de taxa por minuto (rate limits) variam conforme o provedor e o nível de uso contratado pela empresa.
7. Referências Bibliográficas e Documentação Oficial
- Anthropic Research. Claude Sonnet 5.5: High-Efficiency Agentic Reasoning and Terminal Mastery. Anthropic Technical Reports, Outubro 2026. Disponível em: https://www.anthropic.com/claude-sonnet-5-5.
- Terminal-Bench Consortium. Terminal-Bench 4.0 Leaderboard: Measuring Real-World CLI and Development Autonomy in Frontier AI. Terminal-Bench Evaluation Project, Outubro 2026.
- Cursor Engineering. CursorBench 4.0: Evaluating Code Editing, Structural Refactoring, and Contextual Insertion in Modern IDEs. Cursor AI Research, Outubro 2026. Disponível em: https://cursor.com/research/cursorbench-v4.
- OpenAI. GPT-6 Astra Technical Report: Architecture, Long-Horizon Engineering, and Multimodal Capabilities. OpenAI Publications, Outubro 2026. Disponível em: https://openai.com/index/gpt-6-astra-next-generation-work/.
- Google DeepMind. Gemini 4 Argon: Systemic Long-Horizon Reasoning and Million-Token Continuous Output. Google DeepMind Research Briefings, Outubro 2026. Disponível em: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…