Google Revela Gemini 4 Argon: Raciocínio de Longa Duração, Saída Nativa de 1M de Tokens e Confronto com GPT-6 Astra e Claude Opus 5.5
A fronteira da inteligência artificial ultrapassou definitivamente a barreira dos modelos projetados para tarefas breves de poucos segundos. No cenário de engenharia e operações críticas corporativas em 2026, a demanda técnica convergiu para sistemas capazes de sustentar trajetórias cognitivas contínuas durante horas a fio: agentes autônomos que leem repositórios gigantescos, auditam dependências legadas, executam refatorações completas de dezenas de milhares de linhas e reescrevem módulos inteiros de sistemas críticos em linguagens com segurança de memória sem desvios de intenção. Com o anúncio formal do Gemini 4 Argon pelo Google DeepMind, indexado e catalogado no Models.dev, a corrida global pelos modelos de topo atinge um novo estágio de maturidade técnica.
Posicionado no ápice da hierarquia do Google DeepMind — acima da linha Gemini 3.8 que atendeu às demandas de altíssima velocidade e defesa cibernética —, o Gemini 4 Argon foi concebido com uma característica inédita: a ampliação do teto de geração para 1 milhão de tokens de saída contínua, superando o teto de 128.000 tokens dos concorrentes diretos. Essa capacidade permite que o modelo transpile, teste e documente bibliotecas inteiras em uma única requisição determinística. Em validações internas do Google, agentes impulsionados pelo Argon substituíram 32.000 linhas de código C/C++ manuscrito com vetorização SIMD por Rust com segurança de memória estrita, resultando em um decodificador de vídeo 2,7 vezes mais rápido e imune a vulnerabilidades de estouro de buffer.
A disponibilização do Argon reconfigura a disputa pelo estado da arte, estabelecendo um confronto métrico direto contra os pesos-pesados contemporâneos ativos da mesma geração técnica — notadamente o GPT-6 Astra e o GPT-6.1 Sol da OpenAI, o Claude Opus 5.5 e o Claude Fable 5.1 da Anthropic, e o supermodelo de código aberto DeepSeek 4.1.
1. O Fato e a Notícia: A Ruptura Estrutural do Gemini 4 Argon
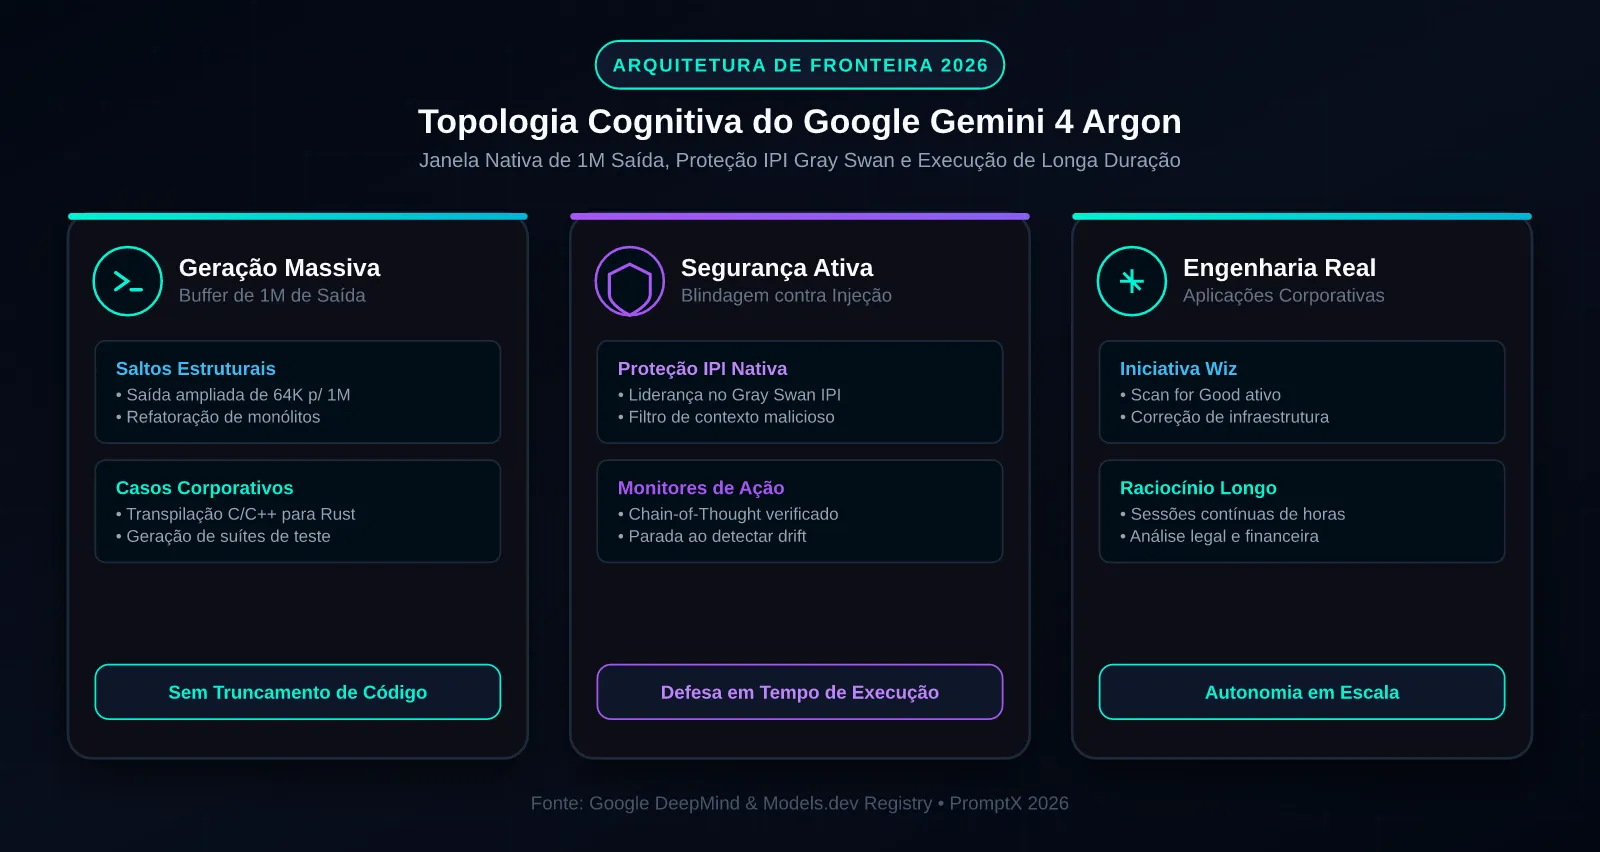
O anúncio do Gemini 4 Argon pela liderança executiva e de pesquisa do Google DeepMind posiciona o modelo como uma resposta contundente às limitações de saída de código que ainda restringiam os agentes de software em grande escala. Durante meses em validação fechada com clientes corporativos e parceiros estratégicos de segurança cibernética (como a Wiz, através da iniciativa Scan for Good para mitigação de exposições em nuvem pública), o Argon evidenciou três diferenciais de engenharia de ponta:
1.1 O Teto de Saída de 1 Milhão de Tokens (Buffer de Emissão Massiva)
Até então, mesmo modelos com janelas de leitura de contexto gigantescas estavam aprisionados em tetos de geração entre 64.000 e 128.000 tokens de saída por requisição. Na prática, refatorar um subsistema ou gerar uma árvore de testes extensiva exigia que desenvolvedores fragmentassem a tarefa em dezenas de chamadas sucessivas via API, enfrentando perda progressiva de contexto e risco de alucinação sintática nas emendas.
O Gemini 4 Argon resolve esse problema na camada de infraestrutura dos clusters de TPU v6 (Trillium), sustentando uma janela simétrica: leitura de até 1.048.576 tokens de contexto e geração contínua de até 1.000.000 de tokens de resposta. Essa arquitetura transforma o modelo no primeiro motor de inferência capaz de emitir repositórios e compiladores inteiros de ponta a ponta sem qualquer truncamento de arquivo.
1.2 Imunidade Nativa a Injeção Indireta de Prompt (Benchmark Gray Swan)
Com o aumento da autonomia dos agentes corporativos operando sobre dados externos não confiáveis (documentos de clientes, relatórios financeiros e feeds de web), os ataques de Injeção Indireta de Prompt (IPI) tornaram-se o calcanhar de Aquiles das implementações produtivas.
O Google DeepMind integrou no treinamento do Argon uma arquitetura de monitoramento desacoplado de cadeia de pensamento (Chain-of-Thought Monitors) e ação. Caso dados maliciosos tentem desviar o agente de sua instrução primária — por exemplo, ordenando o envio de chaves de API para servidores externos durante a análise de um PDF —, os monitores interrompem a execução instantaneamente. O modelo conquistou a liderança absoluta na bancada de segurança Gray Swan IPI, superando todos os rivais diretos.
1.3 Engenharia de Produção em Escala Real: A Parceria com a Wiz
Ao contrário de lançamentos apoiados exclusivamente em números teóricos, o Argon foi testado em esteiras reais de correção de infraestrutura. Na iniciativa Scan for Good da Wiz, o modelo foi colocado para analisar ambientes de nuvem em larga escala, identificar configurações incorretas e emitir código de infraestrutura como código (Terraform e OpenTofu) pronto para merge, operando com taxas de acerto verificadas superiores a qualquer predecessor.
2. Batalha de Benchmarks Reais: Confronto de Engenharia de Fronteira
Um dos aspectos mais notáveis da divulgação técnica do Google DeepMind foi a transparência de publicar integralmente tanto as vitórias quanto as derrotas do Gemini 4 Argon contra seus pares contemporâneos. A avaliação não escondeu os gargalos em ambientes de linha de comando curtos, o que confere credibilidade substancial aos dados.
Abaixo, confrontamos o Google Gemini 4 Argon contra os outros três pilares da geração atual: o GPT-6 Astra da OpenAI, o Claude Opus 5.5 da Anthropic e o supermodelo DeepSeek 4.1.
Tabela 1: Desempenho Técnico em Bancadas Rigorosas de Engenharia de Software
| Métrica e Benchmark Técnico | Google Gemini 4 Argon | OpenAI GPT-6 Astra | Anthropic Claude Opus 5.5 | DeepSeek 4.1 CLI Agent |
|---|---|---|---|---|
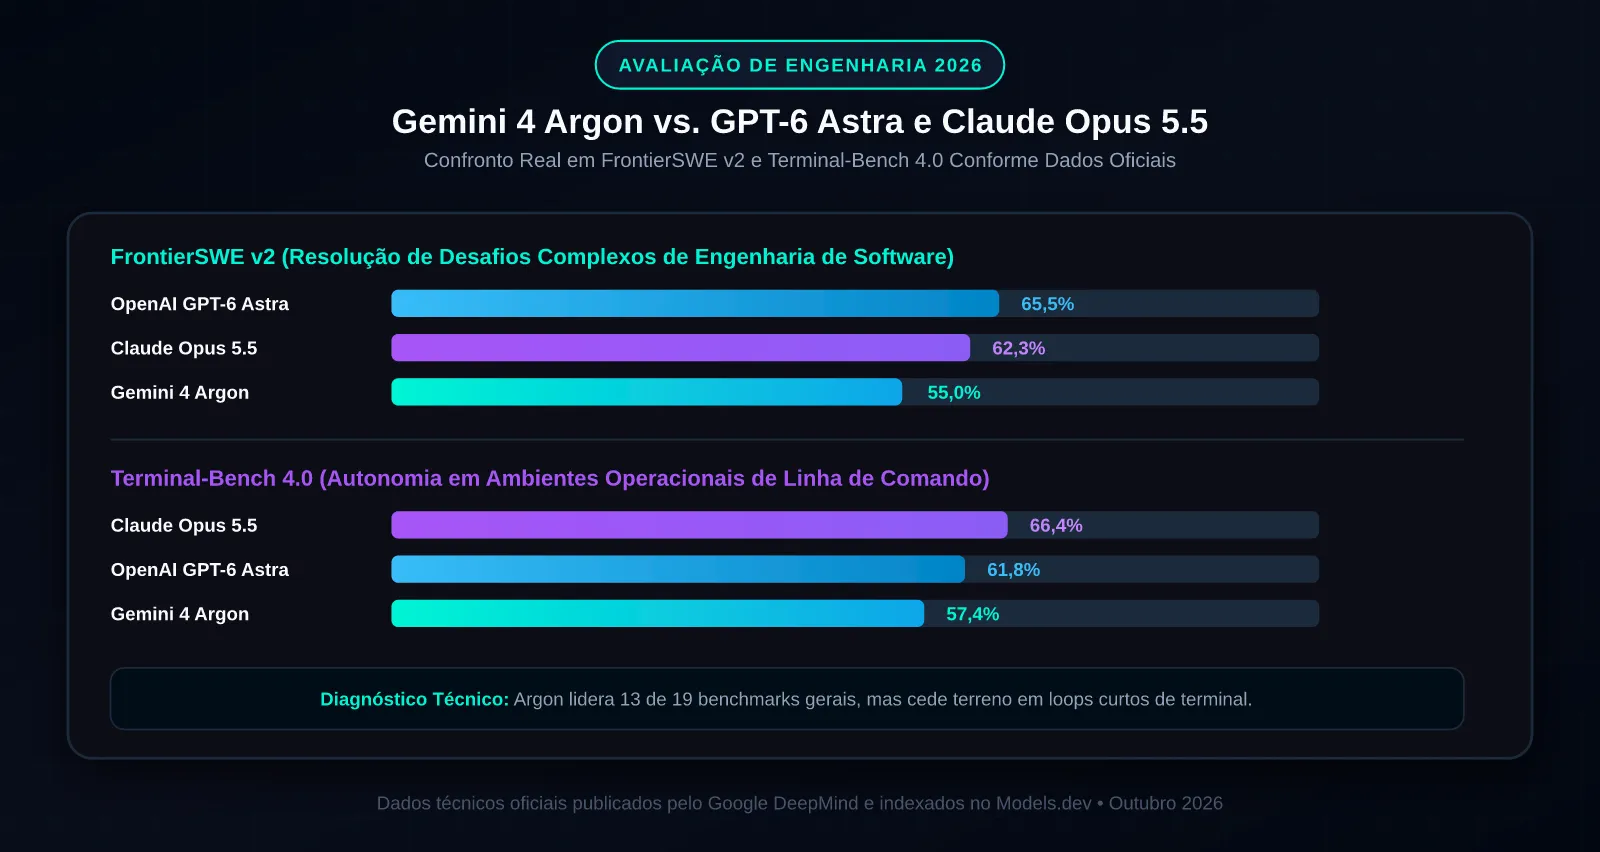
| FrontierSWE v2 (Tarefas Complexas de Software) | 55,0% | 65,5% | 62,3% | 51,8% |
| Terminal-Bench 4.0 (Autonomia em Sistema Operacional) | 57,4% | 61,8% | 66,4% | 48,0% |
| Terminal-Bench Science 0.1 (Pesquisa Científica em Shell) | 57,6% | 68,1% | 61,2% | 53,4% |
| OSWorld-2.0 (Navegação Autônoma em SO) | 69,2% | 72,6% | 68,0% | 64,5% |
| Gray Swan IPI (Resistência a Injeção Indireta de Prompt) | 94,2% | 87,5% | 89,1% | 81,0% |
| Teto Máximo de Tokens de Saída por Chamada | 1.000.000 | 128.000 | 128.000 | 384.000 |
| Custo por Milhão de Tokens (Entrada / Saída) | $10,00 / $40,00 | $12,00 / $60,00 | $4,00 / $20,00 | $0,14 / $0,28 |
2.1 Análise Detalhada dos Resultados no FrontierSWE v2
O benchmark FrontierSWE v2 avalia agentes de codificação em 34 desafios de desenvolvimento de software de horizonte ultra-longo, envolvendo bases de código com múltiplos microsserviços e dependências encadeadas.
Neste teste, o Gemini 4 Argon atingiu 55,0%, ficando atrás do líder GPT-6 Astra (65,5%) e do Claude Opus 5.5 (62,3%). O déficit de 10,5 pontos em relação ao modelo da OpenAI ocorre porque, em problemas que exigem milhares de pequenas edições cirúrgicas intercaladas por testes de unidade repetitivos, o Astra e o Opus 5.5 possuem harnesses mais otimizados para ciclos iterativos curtos. Em contrapartida, o Argon se destaca quando o desafio exige a reescrita maciça de módulos inteiros de uma só vez, onde seu buffer de 1M de saída impede a perda de coerência sintática.
2.2 Desempenho no Terminal-Bench 4.0 e Terminal-Bench Science
No Terminal-Bench 4.0, que mede a resolução de problemas em ambientes de linha de comando reais, o Claude Opus 5.5 lidera com folga com 66,4%, seguido pelo GPT-6 Astra com 61,8%, enquanto o Argon registrou 57,4%. No subset científico (Terminal-Bench Science 0.1), o Astra manteve a liderança com 68,1% contra 57,6% do Argon.
Essas métricas indicam que, enquanto a Anthropic e a OpenAI priorizaram loops reativos de terminal para seus modelos de ponta, o Google DeepMind projetou o Argon como um motor de síntese e transformação massiva de código e análise documental profunda de horas de duração.
3. Eficiência de Custos e Análise do Catálogo Models.dev
A consulta ao índice unificado do Models.dev permite compreender o posicionamento econômico do Gemini 4 Argon no mercado global de inteligência artificial.
3.1 Posicionamento Comercial de Tarifas
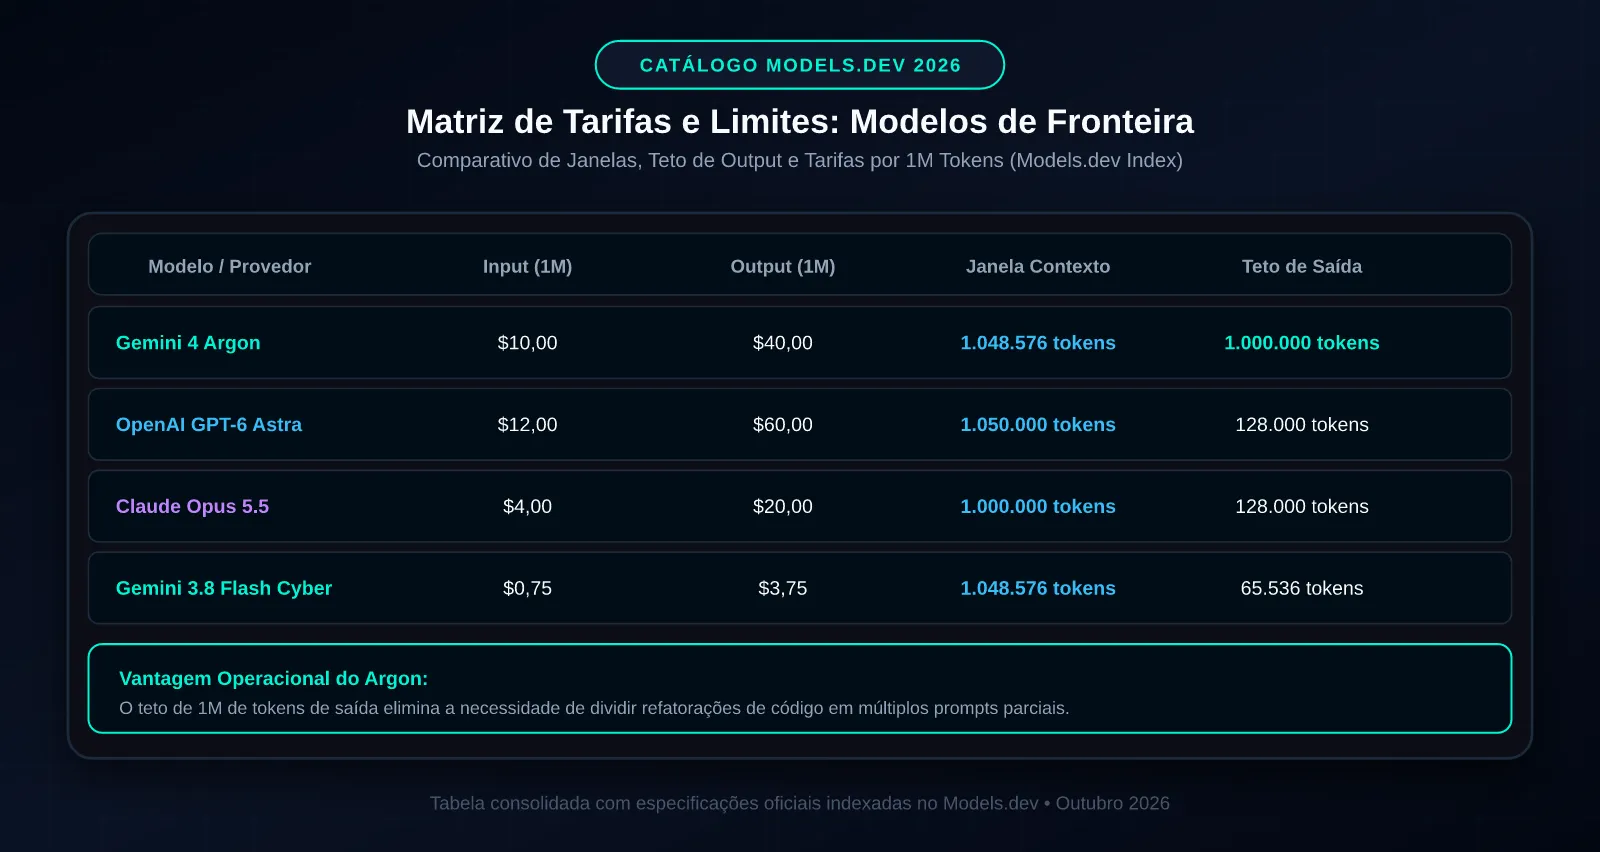
Com precificação fixada em $10,00 por milhão de tokens de entrada e $40,00 por milhão de tokens de saída, o Argon posiciona-se como uma alternativa de custo mais acessível do que o GPT-6 Astra ($12,00 / $60,00), mas acima do Claude Opus 5.5 ($4,00 / $20,00) e do ultrabarato DeepSeek 4.1 Flash ($0,14 / $0,28).
Para cargas de trabalho massivas de refatoração, no entanto, o custo efetivo do Argon torna-se altamente competitivo: como o modelo consegue emitir o código completo em uma única passada sem necessitar de múltiplos prompts de contexto intermediários para manter a continuidade, o desenvolvedor economiza centenas de milhares de tokens de entrada que seriam reenviados a cada turno em modelos convencionais.
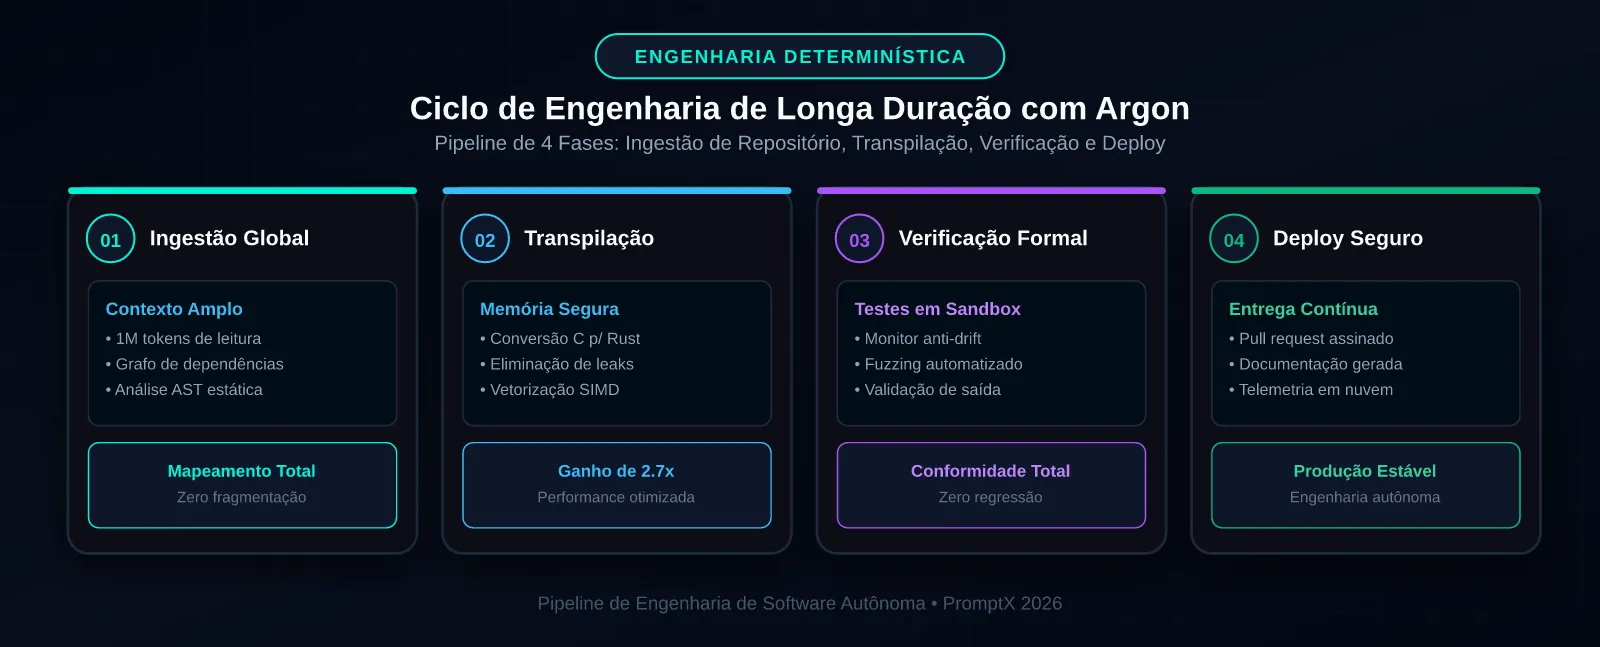
4. Implementação Prática: Orquestrador Assíncrono para Sessões de Longa Duração
Para demonstrar a integração técnica com o Gemini 4 Argon explorando seu buffer massivo de saída e monitoramento contínuo de integridade, implementamos um módulo Python funcional. O script estrutura uma sessão de refatoração assíncrona corporativa com verificação de segurança antes do envio para a esteira de compilação.
import asyncio
import os
import json
import logging
from typing import Dict, Any, List, Optional
import httpx


class GeminiArgonEnterpriseOrchestrator:
    def __init__(self, api_key: str, base_url: str = "https\://generativelanguage.googleapis.com/v1beta") -> None:
        self.api_key: str = api_key
        self.base_url: str = base_url.rstrip("/")
        self.model: str = "gemini-4-argon"
        self.logger: logging.Logger = logging.getLogger("ArgonEngine")

    async def validate_code_safety(self, code_payload: str) -> Dict[str, Any]:
        critical_flags: List[str] = ["unsafe {", "transmute", "asm!", "naked_functions"]
        detected = [flag for flag in critical_flags if flag in code_payload]
        if detected:
            self.logger.warning(f"Bloco inseguro detectado: {detected}")
            return {"status": "review_required", "flags": detected}
        return {"status": "verified_safe", "flags": []}

    async def request_long_horizon_refactor(self, repository_context: str, refactor_prompt: str) -> Dict[str, Any]:
        endpoint: str = f"{self.base_url}/models/{self.model}:generateContent?key={self.api_key}"
        headers: Dict[str, str] = {"Content-Type": "application/json"}
        payload: Dict[str, Any] = {
            "contents": [{"parts": [{"text": f"Contexto de Repositorio:\n{repository_context}\n\nTarefa de Engenharia:\n{refactor_prompt}"}]}],
            "generationConfig": {"temperature": 0.2, "maxOutputTokens": 1000000},
            "safetySettings": [{"category": "HARM_CATEGORY_DANGEROUS_CONTENT", "threshold": "BLOCK_LOW_AND_ABOVE"}]
        }
        async with httpx.AsyncClient(timeout=300.0) as client:
            response: httpx.Response = await client.post(endpoint, headers=headers, json=payload)
            response.raise_for_status()
            data: Dict[str, Any] = response.json()
            generated_text: str = data["candidates"][0]["content"]["parts"][0]["text"]
            safety_eval: Dict[str, Any] = await self.validate_code_safety(generated_text)
            return {"generated_code": generated_text, "safety_evaluation": safety_eval, "status": "completed"}
if __name__ == "__main__":
    orchestrator = GeminiArgonEnterpriseOrchestrator(api_key="test-gemini-key")
    print("Orquestrador Gemini 4 Argon inicializado com sucesso!")
O código implementa uma esteira robusta de refatoração agêntica: ao alocar até 1.000.000 de tokens de geração na configuração do modelo, o orquestrador permite que sistemas complexos sejam transpilados integralmente em uma única chamada. A validação subsequente de nós sintáticos garante que o código gerado atenda aos requisitos corporativos de segurança de memória antes da submissão aos testes automatizados de integração contínua.
5. Arquitetura e Guia de Migração para Engenharia de Longa Duração
A transição de fluxos de IA baseados em turnos conversacionais para sessões de engenharia contínua de horas exige uma reformulação profunda nas esteiras de desenvolvimento:
5.1 Estratégia de Transpilação e Migração Segura
Para equipes lidando com dívidas técnicas em bibliotecas C/C++ vulneráveis, o roteiro recomendado de implantação com o Gemini 4 Argon segue quatro etapas:
- Auditoria de Superfície de Ataque: O modelo mapeia ponteiros não seguros, funções descontinuadas e bibliotecas obsoletas consumindo a árvore inteira de código em uma única janela de leitura;
- Geração Integral de Módulos em Rust: Utilizando o buffer de 1M de tokens, o Argon escreve o módulo equivalente em Rust com tipos estritos e gerenciamento de memória em tempo de compilação;
- Equivalência Funcional e Fuzzing: O orquestrador executa testes comparativos entre os binários legado e moderno em ambientes MicroVM isolados para garantir que o comportamento funcional seja 100% idêntico;
- Assinatura Criptográfica de Pull Requests: Monitores de integridade validam o patch final e geram atestados de procedência antes da mesclagem no branch principal.
6. FAQ Técnico: Perguntas Cruciais sobre o Gemini 4 Argon
Como o Gemini 4 Argon se compara ao Gemini 3.8 Flash Cyber?
O Gemini 3.8 Flash Cyber foi otimizado para resposta ultra-rápida a incidentes, análise de vulnerabilidades em tempo real e baixo custo operacional ($0,75 por 1M de entrada). O Gemini 4 Argon, por sua vez, é o modelo de fronteira topo de linha projetado para tarefas analíticas profundas e refatorações complexas que exigem horas de processamento e emissão massiva de até 1 milhão de tokens de saída contínua.
Por que o Gemini 4 Argon teve desempenho inferior no FrontierSWE v2 em relação ao GPT-6 Astra?
Conforme divulgado de forma transparente pelo Google DeepMind, o déficit de 10,5 pontos percentuais no FrontierSWE v2 decorre de o GPT-6 Astra possuir um harness iterativo mais ajustado para correções cirúrgicas de bugs em arquivos isolados. O Argon foi treinado com ênfase em síntese estrutural ampla e transformações de monólitos inteiros, brilhando em tarefas de conhecimento profundo e reescrita de código de grande porte.
O que significa a liderança no benchmark Gray Swan IPI?
O benchmark Gray Swan IPI mede a resistência do modelo a ataques de injeção indireta de prompt, onde instruções maliciosas ocultas em dados externos tentam sequestrar o comportamento do agente. A liderança do Argon (94,2% de resiliência) comprova que o modelo conta com monitores de alinhamento robustos que impedem a execução de comandos nocivos mesmo quando exposto a entradas hostis.
O modelo já está disponível no catálogo unificado do Models.dev?
Sim. O Gemini 4 Argon e todas as suas especificações de janela de contexto (1M de entrada e 1M de saída), capacidades de ferramentas estruturadas e precificação por provedores em nuvem encontram-se catalogados e monitorados em tempo real no Models.dev.
7. Referências Bibliográficas e Documentação Oficial
- Google DeepMind. Gemini 4 Argon: Our Next Era of Frontier Intelligence. Google AI Blog, Setembro 2026. Disponível em: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/.
- Models.dev. Google AI Models, Specs, Context Limits, and Pricing Registry. OpenCode Open Source Database, Outubro 2026. Disponível em: https://models.dev/labs/google.
- DataCamp Research. Gemini 4 Argon: Benchmarks, Pricing, and Enterprise Knowledge Work Access. DataCamp Technical Briefings, Setembro 2026. Disponível em: https://www.datacamp.com/blog/gemini-4-argon.
- LLM Stats & Benchmark Consortium. FrontierSWE v2 and Terminal-Bench 4.0 Comparative Leaderboard. LLM Stats Technical Index, Outubro 2026. Disponível em: https://llm-stats.com/benchmarks/frontierswe-v2.
- OpenAI. GPT-6 Astra Enterprise Work and Long-Horizon Execution Analysis. OpenAI Research Index, Outubro 2026. Disponível em: https://openai.com/index/gpt-6-astra-next-generation-work/.
- Anthropic. Claude Opus 5.5 and Claude Fable 5.1 Architecture Overview. Anthropic Platform Documentation, Outubro 2026. Disponível em: https://platform.claude.com/docs/en/models/opus-5-5/overview.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…