GraphRAG vs Vector RAG para Agentes Autônomos: Arquitetura de Memória Relacional e Implementação em Python
A arquitetura de Geração Aumentada por Recuperação (RAG - Retrieval-Augmented Generation) tornou-se a espinha dorsal para mitigar alucinações e expandir a base de conhecimento de Modelos de Linguagem de Grande Escala (LLMs). No desenvolvimento de agentes autônomos, a recuperação de informação desempenha um papel ainda mais crítico: ela atua como a memória de longo prazo episódica e semântica do agente.
Entretanto, o paradigma dominante de Vector RAG (baseado exclusivamente em divisão de texto em chunks e busca por similaridade de cosseno em bancos vetoriais) apresenta falhas estruturais severas quando submetido a tarefas complexas de raciocínio. Questões que exigem síntese global de um corpus (“Quais são os 5 principais temas deste repositório?”), rastreamento de relações N-hop (“Como a decisão do Diretor X afetou o projeto da Equipe Y?”) ou conexões transversais entre entidades distantes resultam em falhas catastróficas de recuperação.
Para superar essas barreiras, a abordagem de GraphRAG (Geração Aumentada por Recuperação Baseada em Grafos de Conhecimento) combina a semântica de embeddings com a topologia explícita de grafos.
Neste guia técnico aprofundado, analisamos os limites matemáticos do Vector RAG, os pilares algorítmicos do GraphRAG (incluindo extração de triplas e detecção de comunidades hierárquicas via algoritmo Leiden) e apresentamos uma implementação prática e funcional de memória relacional em Python.
1. As Limitações Estruturais do Vector RAG Tradicional
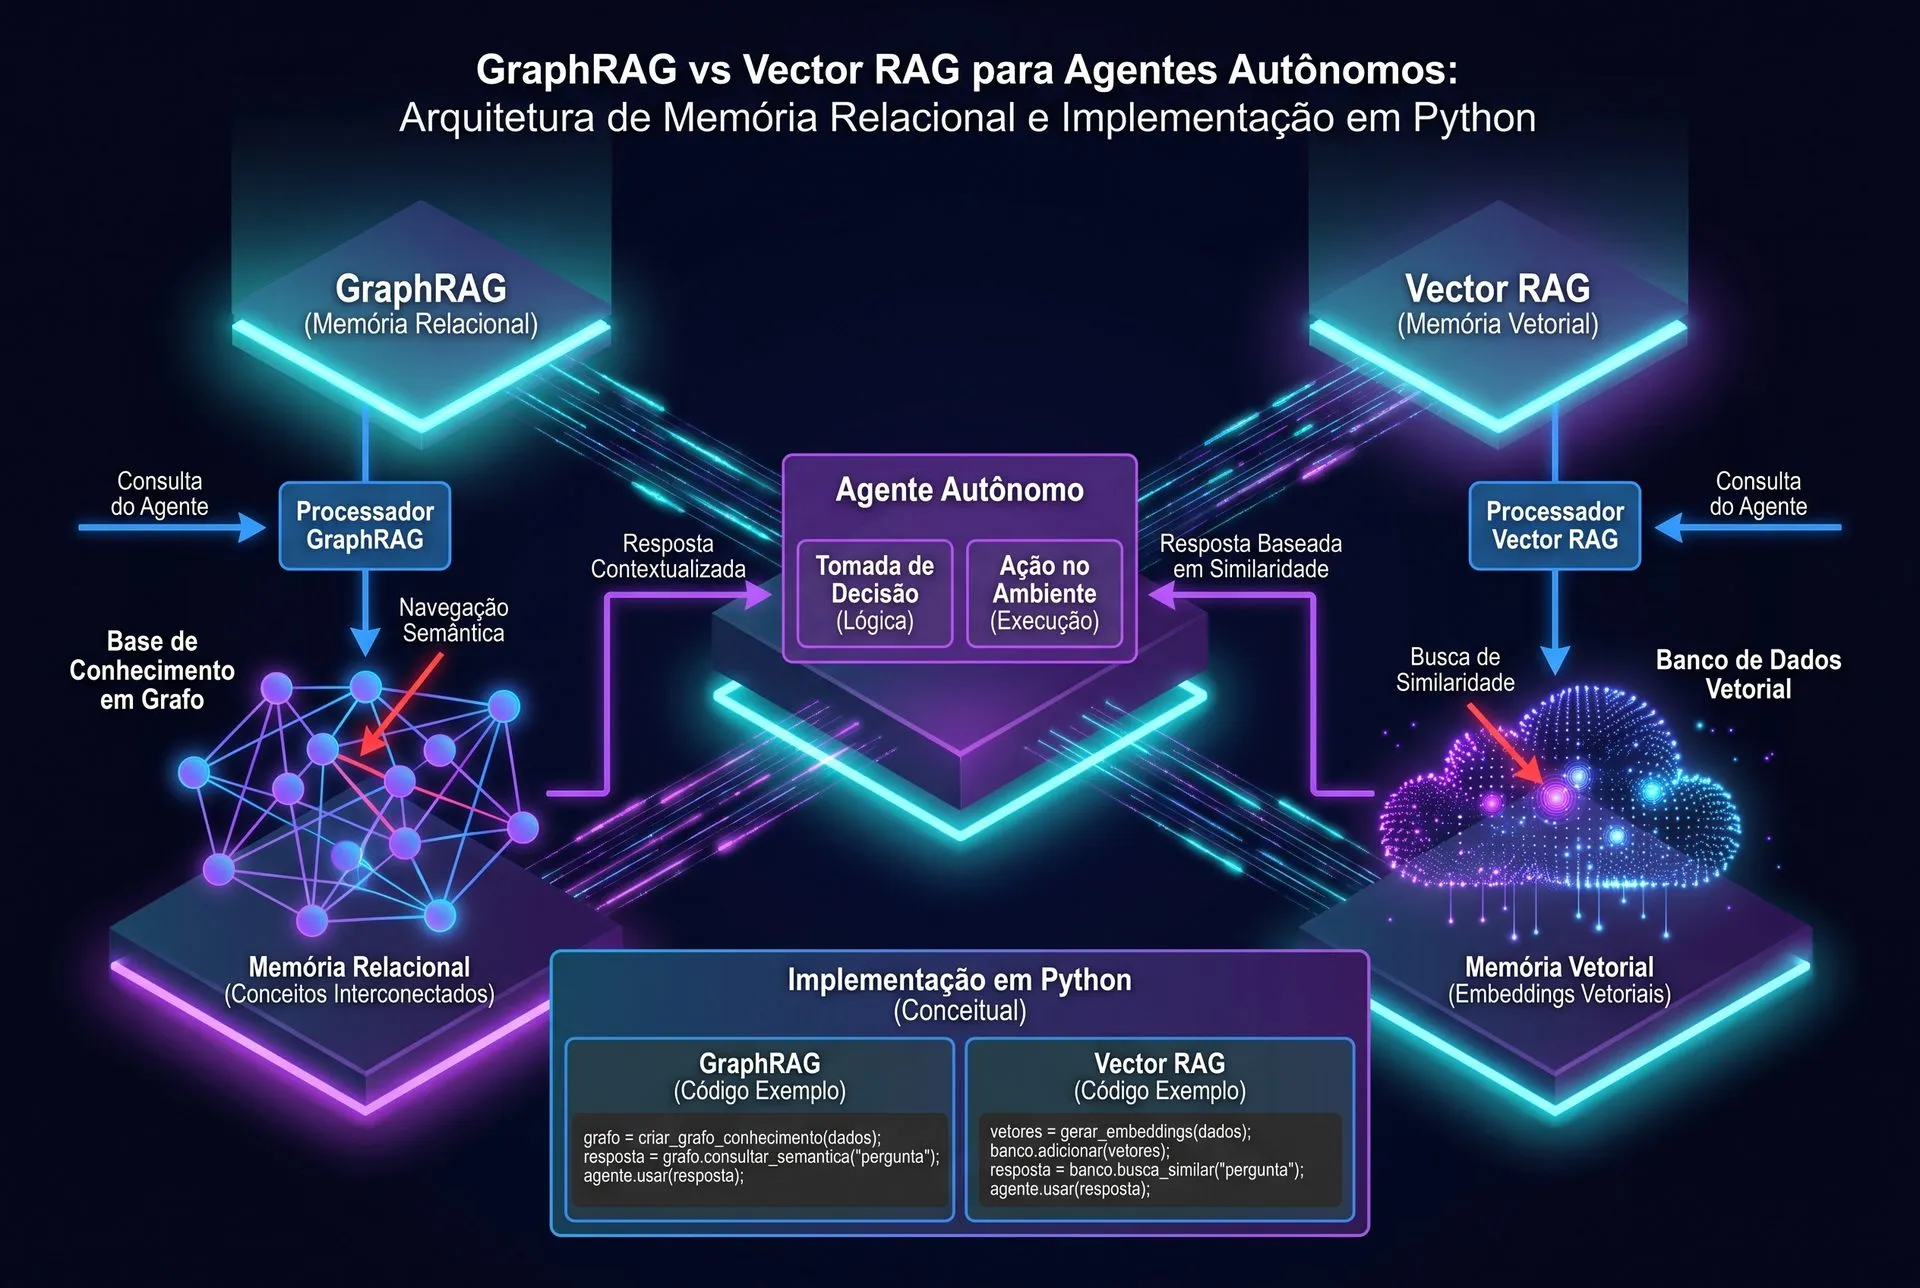
O fluxo clássico do Vector RAG opera sob uma premissa puramente geométrica:
Embora eficiente para buscas pontuais de fatos explícitos (needle in a haystack), esse modelo colapsa em três cenários fundamentais:
1.1. Perda de Contexto por Fragmentação Arbitrária (Chunking Boundary Issue)
Quando um documento longo é fatiado em blocos fixos de texto, entidades e conceitos inter-relacionados são frequentemente separados pela fronteira do chunk. Se a premissa de um argumento está no Bloco 1 e a conclusão está no Bloco 2, a similaridade vetorial da pergunta pode recuperar apenas um dos fragmentos, privando o LLM do contexto causal completo.
1.2. Incapacidade de Raciocínio Multi-Hop (N-Hop Traversal Failure)
Considere a consulta: ” Quais fornecedores da Empresa B foram impactados pelas sanções aplicadas à Empresa A?“.
- No Vector RAG, a busca vetorial tenta encontrar um bloco que contenha simultaneamente Empresa A, Sanções, Empresa B e Fornecedores.
- Se essa cadeia relacional estiver distribuída em 4 documentos independentes ao longo de meses, o cálculo de similaridade de cosseno direto para a consulta original falha em identificar os elos intermediários.
1.3. Falência na Síntese e Compreensão Holística (Global Aggregation)
Perguntas do tipo: ” Quais são os principais pontos de atrito identificados em todas as avaliações de clientes deste trimestre?“ não possuem um bloco semântico único correspondente no espaço vetorial. O Vector RAG seleciona aleatoriamente fragmentos com alta densidade léxica de “avaliações” e “atrito”, ignorando a distribuição estatística global das informações.
2. Fundamentos do GraphRAG: Da Geometria à Topologia
O GraphRAG resolve essas limitações estruturando a base de dados em um Grafo de Conhecimento Dinâmico ($G = (V, E)$), onde vértices ($V$) representam entidades semânticas e arestas ($E$) representam relacionamentos explícitos tipados.
2.1. Extração de Entidades e Relacionamentos via LLM
Em vez de depender de pipelines rígidos de Processamento de Linguagem Natural (NER clássico baseado em regras), o GraphRAG utiliza LLMs com prompts estruturados para extrair triplas semânticas ricas:
Tripla = (Entidade de Origem, Tipo de Relação, Entidade de Destino, Propriedades/Citação)
Cada entidade extraída possui uma descrição sintética contextualizada, permitindo que variações morfológicas (ex.: “OpenAI”, “empresa criadora do ChatGPT”, “laboratório de Sam Altman”) sejam consolidadas no mesmo nó conceitual via técnicas de resolução de entidades (Entity Resolution).
2.2. Detecção de Comunidades Hierárquicas e Algoritmo Leiden
Um dos avanços mais expressivos do GraphRAG (popularizado pela pesquisa da Microsoft Research, Edge et al., 2024) é a aplicação do algoritmo de particionamento Leiden sobre o grafo de entidades.
O algoritmo agrupa nós densamente conectados em clusters semânticos estruturados em diferentes níveis hierárquicos:
- Nível 0 (Micro-comunidades): Relacionamentos imediatos e específicos entre poucos elementos.
- Nível 1 (Meso-comunidades): Tópicos intermediários e fluxos de trabalho completos.
- Nível 2 (Macro-comunidades): Visão estratégica global de todo o domínio de conhecimento.
Para cada comunidade detectada em tempo de indexação, o LLM gera um Resumo de Comunidade (Community Summary), permitindo que o sistema responda a perguntas globais lendo apenas os sumários hierárquicos, sem precisar reprocessar milhões de tokens brutos.
2.3. Estratégias de Recuperação: Local Search vs. Global Search
3. Implementação Prática em Python: Grafo de Memória e Retrieval Relacional
Abaixo, apresentamos uma implementação completa em Python utilizando NetworkX e vetorização de texto. O código segue rigorosamente a formatação compacta em linha única:
import json
import math
from typing import List, Dict, Any, Tuple, Set
import networkx as nx

class EntityNode:
    def __init__(self, name: str, entity_type: str, description: str):
        self.name = name.strip()
        self.entity_type = entity_type.strip()
        self.description = description.strip()

class RelationEdge:
    def __init__(self, source: str, target: str, relation_type: str, context: str):
        self.source = source.strip()
        self.target = target.strip()
        self.relation_type = relation_type.strip()
        self.context = context.strip()

def compute_text_hash_embedding(text: str, dimensions: int = 16) -> List[float]:
    words = text.lower().split()
    vector = [0.0] * dimensions
    for i, word in enumerate(words):
        for char in word:
            vector[(ord(char) + i) % dimensions] += 1.0
    norm = math.sqrt(sum(x * x for x in vector)) or 1.0
    return [x / norm for x in vector]

def cosine_similarity(v1: List[float], v2: List[float]) -> float:
    return sum(a * b for a, b in zip(v1, v2))

class RelationalMemoryGraph:
    def __init__(self):
        self.graph = nx.DiGraph()
        self.node_embeddings: Dict[str, List[float]] = {}
    def add_entity(self, entity: EntityNode) -> None:
        self.graph.add_node(entity.name, entity_type=entity.entity_type, description=entity.description)
        embed_text = f"{entity.name} {entity.entity_type} {entity.description}"
        self.node_embeddings[entity.name] = compute_text_hash_embedding(embed_text)
    def add_relation(self, relation: RelationEdge) -> None:
        if not self.graph.has_node(relation.source):
            self.add_entity(EntityNode(relation.source, "Concept", "Entidade dinâmica"))
        if not self.graph.has_node(relation.target):
            self.add_entity(EntityNode(relation.target, "Concept", "Entidade dinâmica"))
        self.graph.add_edge(relation.source, relation.target, relation_type=relation.relation_type, context=relation.context)
    def find_entrypoint_entities(self, query: str, top_k: int = 2) -> List[Tuple[str, float]]:
        query_vector = compute_text_hash_embedding(query)
        scored_nodes = []
        for node_name, node_vector in self.node_embeddings.items():
            score = cosine_similarity(query_vector, node_vector)
            scored_nodes.append((node_name, score))
        scored_nodes.sort(key=lambda x: x[1], reverse=True)
        return scored_nodes[:top_k]
    def retrieve_subgraph_context(self, query: str, max_hops: int = 2) -> Dict[str, Any]:
        entrypoints = self.find_entrypoint_entities(query, top_k=2)
        visited_nodes: Set[str] = set()
        retrieved_edges: List[Dict[str, str]] = []
        for root_node, score in entrypoints:
            visited_nodes.add(root_node)
            queue = [(root_node, 0)]
            while queue:
                current_node, current_hop = queue.pop(0)
                if current_hop >= max_hops:
                    continue
                for neighbor in self.graph.neighbors(current_node):
                    edge_data = self.graph.get_edge_data(current_node, neighbor)
                    retrieved_edges.append({"from": current_node, "to": neighbor, "relation": edge_data.get("relation_type", "relacionado"), "context": edge_data.get("context", "")})
                    if neighbor not in visited_nodes:
                        visited_nodes.add(neighbor)
                        queue.append((neighbor, current_hop + 1))
        entities_data = []
        for node in visited_nodes:
            attrs = self.graph.nodes[node]
            entities_data.append({"name": node, "type": attrs.get("entity_type", "Unknown"), "description": attrs.get("description", "")})
        return {"query": query, "entrypoint_roots": [ep[0] for ep in entrypoints], "entities": entities_data, "relations": retrieved_edges}

if __name__ == "__main__":
    memory = RelationalMemoryGraph()
    memory.add_entity(EntityNode("AgentAlpha", "SoftwareAgent", "Agente orquestrador de microsserviços"))
    memory.add_entity(EntityNode("DatabaseCluster", "Infrastructure", "Banco MariaDB de alta disponibilidade"))
    memory.add_entity(EntityNode("BillingAPI", "Service", "API de faturamento e pagamentos recorrentes"))
    memory.add_entity(EntityNode("SecurityPolicy", "Governance", "Políticas de conformidade e controle de acesso"))
    memory.add_relation(RelationEdge("AgentAlpha", "BillingAPI", "invoca", "AgentAlpha dispara rotina de faturamento"))
    memory.add_relation(RelationEdge("BillingAPI", "DatabaseCluster", "persiste_em", "BillingAPI grava registros financeiros"))
    memory.add_relation(RelationEdge("SecurityPolicy", "AgentAlpha", "audita", "Regras de conformidade aplicadas ao agente"))
    user_query = "Qual a relação entre o AgentAlpha e o DatabaseCluster?"
    context = memory.retrieve_subgraph_context(user_query, max_hops=2)
    print(json.dumps(context, indent=2, ensure_ascii=False))
4. Tabela Comparativa: Vector RAG vs. GraphRAG vs. Hybrid RAG
| Dimensão Técnica | Vector RAG Tradicional | GraphRAG (Knowledge Graph Puro) | Hybrid RAG (Vetores + Grafo) |
|---|---|---|---|
| Custo Computacional de Indexação | Baixo ($O(N)$ em relação aos chunks) | Alto (Extração exaustiva e particionamento de comunidades) | Médio a Alto (Indexação dupla) |
| Latência de Recuperação (Retrieval) | Baixa (Busca vetorial aproximada em milissegundos) | Média (Travessia de grafos e montagem de subgrafo) | Média (100ms - 300ms) |
| Precisão em Consultas Pontuais | Muito Alta (Needle in a Haystack) | Média (Pode trazer ruído topológico) | Máxima (Combina texto exato com contexto) |
| Raciocínio Multi-Hop ($N$-Hop) | Muito Baixo (Falha ao cruzar documentos) | Excelente (Navega arestas relacionais) | Excelente |
| Síntese Global de Corpus | Inexistente (Amostragem fragmentada) | Excelente (Via resumos de comunidades Leiden) | Excelente |
| Resiliência a Mudanças de Dados | Alta (Basta reindexar o chunk alterado) | Baixa a Média (Exige atualização topológica do nó) | Média |
5. Estratégias de Otimização para Agentes em Produção
Para agentes autônomos que operam sob restrições rígidas de latência e custo por milhão de tokens, implementar GraphRAG exige três salvaguardas arquiteturais:
5.1. Roteamento Inteligente de Consultas (Query Routing)
Nem toda consulta necessita de travessia de grafos. O agente deve conter um classificador semântico no dispatcher :
- Consultas pontuais (ex.: ” Qual o endereço IP do servidor X?“) → Vector Search.
- Consultas relacionais e estruturais (ex.: ” Como os componentes do subsistema Y interagem?“) → Graph Search.
5.2. Poda de Arestas por Relevância (Edge Pruning)
Grafos de grande porte sofrem com o problema do “nó central superconectado” (Hub Node Problem), onde um nó genérico (ex.: “Software” ou “Empresa”) conecta-se a milhares de arestas, estourando a janela de contexto do LLM.
- Implemente cálculo de centralidade de grau e filtre arestas por peso semântico mínimo antes de injetar o subgrafo no prompt.
6. Perguntas Frequentes (FAQ)
O GraphRAG substitui completamente os bancos de dados vetoriais?
Não. O GraphRAG e o Vector RAG são abordagens complementares. As arquiteturas de ponta adotam o Hybrid RAG, onde os bancos vetoriais são utilizados para encontrar os nós de entrada (entrypoints) e o grafo é utilizado para expandir a vizinhança relacional contextualizada.
Quais bancos de dados são mais indicados para GraphRAG corporativo?
Para ambientes de desenvolvimento e prototipagem, bibliotecas como NetworkX e bancos relacionais com extensões de grafo são suficientes. Em ambientes corporativos de alta escala, recomenda-se o uso de Neo4j, AWS Neptune, Memgraph ou Milvus/Pinecone associados a bases de triplas RDF/LPG.
Como o algoritmo Leiden supera o algoritmo Louvain na detecção de comunidades?
O algoritmo Louvain pode produzir comunidades mal conectadas internamente ou até desconectadas durante iterações sucessivas. O algoritmo Leiden garante que todas as comunidades encontradas sejam conexas e converte clusters de forma substancialmente mais rápida e estável.
Como lidar com o custo elevado de extração de grafos com LLMs?
Utilize modelos de menor porte e alta velocidade (como modelos compactos destilados) para a fase de extração determinística de entidades e triplas, reservando LLMs de maior capacidade exclusivamente para a geração dos resumos de comunidades e raciocínio final.
Referências Bibliográficas e Literatura Técnica
- EDGE, Darren et al. From Local to Global: A Graph RAG Approach to Query-Focused Summarization. Microsoft Research Technical Report, 2024. arXiv:2404.16130.
- LEWIS, Patrick et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems (NeurIPS), v. 33, p. 9459-9474, 2020.
- GAO, Yunfan et al. Retrieval-Augmented Generation for Large Language Models: A Survey. IEEE Transactions on Knowledge and Data Engineering, 2023. arXiv:2312.10997.
- TRAJANOSKA, M. et al. Enhancing Knowledge Graph Construction with Large Language Models. Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (ACL), p. 1120-1135, 2023.
- TRAAG, V. A.; WALTMAN, L.; VAN ECK, N. J. From Louvain to Leiden: guaranteeing well-connected communities. Scientific Reports, v. 9, n. 1, p. 5233, 2019. DOI: 10.1038/s41598-019-41695-z.
- PAN, Shirui et al. Unifying Large Language Models and Knowledge Graphs: A Roadmap. IEEE Transactions on Knowledge and Data Engineering, v. 36, n. 7, p. 3012-3030, 2024.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…