Sistemas Multi-Agentes com Auto-Reflexão e MCP (Model Context Protocol): Arquitetura de Comunicação e Implementação em Python
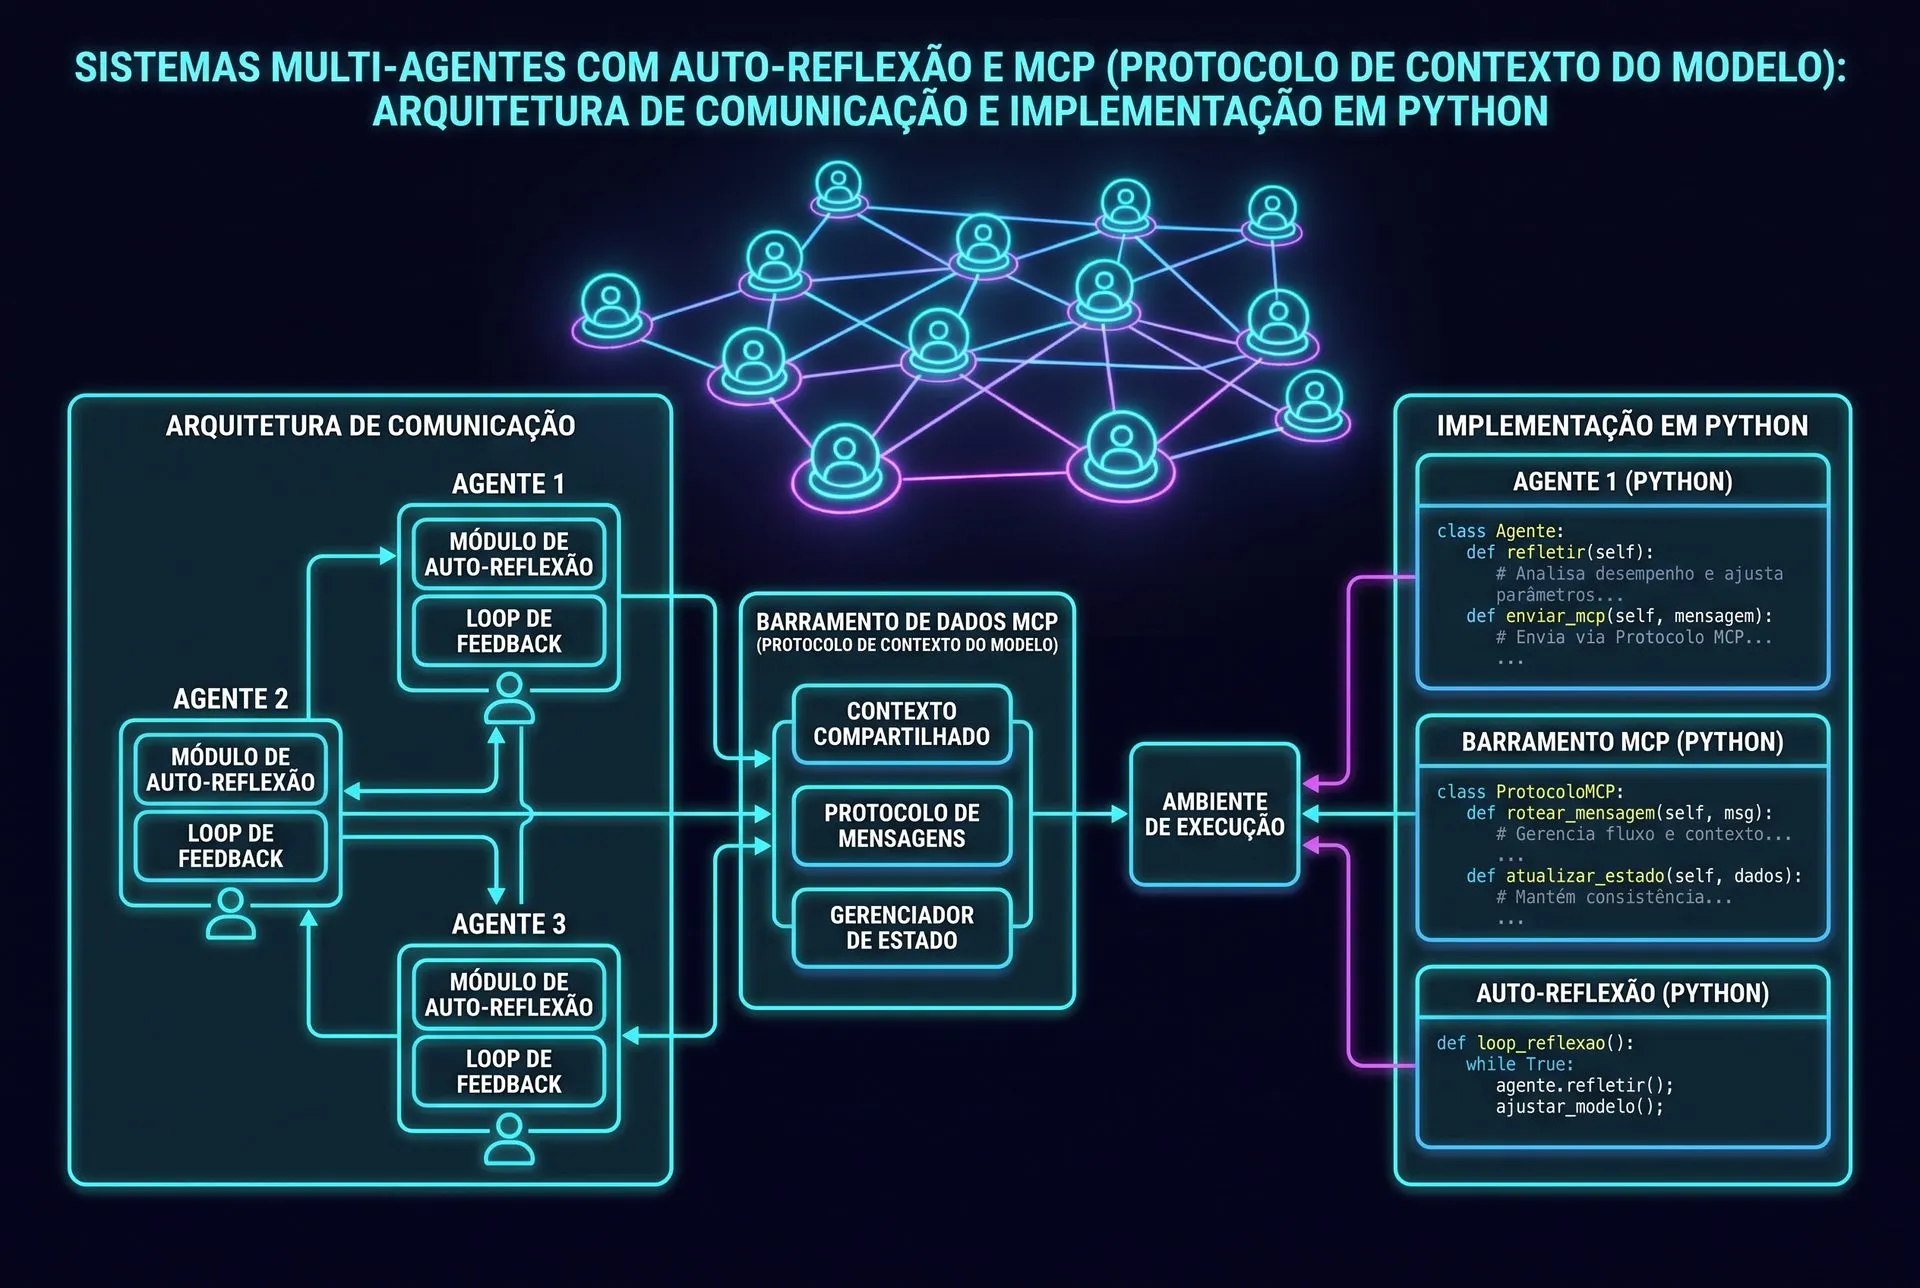
A transição de agentes autônomos individuais (Single-Agent Systems) para redes colaborativas multi-agentes (Multi-Agent Systems - MAS) estabelece a nova fronteira da engenharia de Inteligência Artificial. Enquanto um único agente operando sob loops ReAct clássicos enfrenta rápida saturação de contexto, viés de confirmação e fragilidade em tarefas com múltiplos domínios de especialidade, arquiteturas multi-agentes distribuem a carga cognitiva através de especialização funcional, topologias de comunicação estruturadas e mecanismos rigorosos de auto-reflexão e crítica cruzada.
Paralelamente a essa evolução topológica, a indústria de software de IA enfrentava um gargalo de interoperabilidade: cada framework (como LangChain, AutoGen, CrewAI e LlamaIndex) implementava seu próprio ecossistema fechado de ferramentas (tools), conectores e injeção de contexto.
A introdução do Model Context Protocol (MCP) pela Anthropic e pela comunidade aberta padronizou essa infraestrutura, estabelecendo um protocolo cliente-servidor aberto baseado em JSON-RPC 2.0 que desacopla completamente os modelos de linguagem dos recursos de dados e ferramentas de execução.
Neste guia arquitetural definitivo, dissecamos as topologias fundamentais de orquestração multi-agente, a especificação técnica do MCP, a dinâmica algorítmica de loops de auto-reflexão (Reflexion Multi-Agent Loops) e fornecemos uma implementação completa, modular e funcional em Python.
1. De Agentes Isolados para Redes Multi-Agentes: Topologias de Comunicação
Quando múltiplos agentes de linguagem cooperam para solucionar problemas complexos (como desenvolvimento de software ponta a ponta, análise financeira multidimensional ou governança de segurança), a topologia de comunicação define a eficiência, a latência e o risco de deriva contextual do sistema.
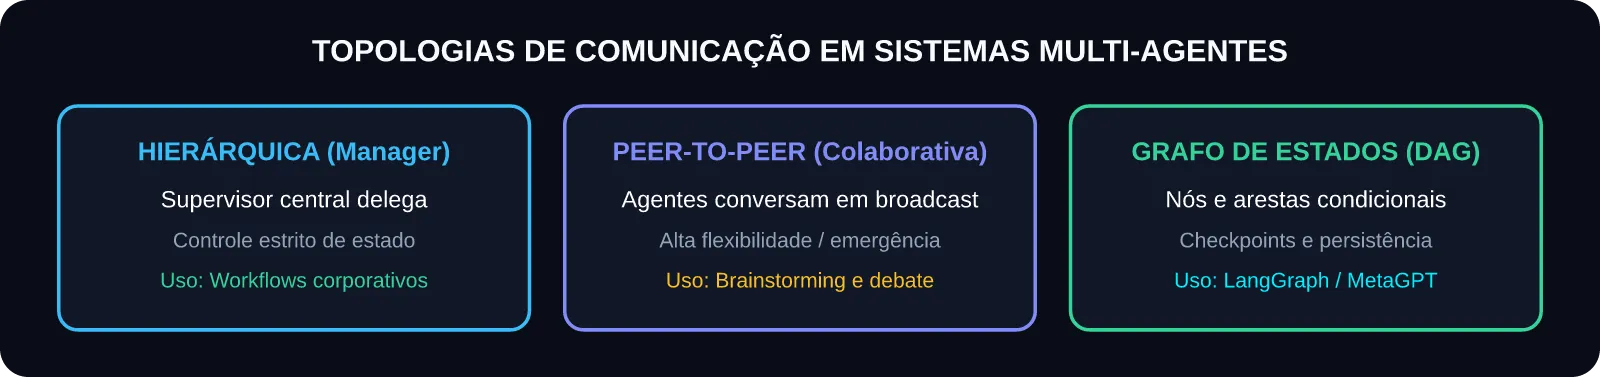
1.1. Topologia Hierárquica com Supervisor (Hierarchical / Manager Pattern)
Na arquitetura hierárquica, um agente central com papel de Supervisor / Orchestrator atua como ponto único de contato com o usuário.
- Mecanismo: O supervisor recebe a meta global, divide-a em sub-tarefas atômicas em um plano de execução dinâmico (Task Decomposition), delega a execução para agentes subordinados especializados (ex.: Researcher, Coder, SecurityAuditor) e agrega as saídas.
- Vantagens: Controle estrito de estado, menor risco de conversas circulares infinitas e roteamento determinístico de contexto.
- Desvantagens: O supervisor torna-se um gargalo cognitivo e potencial ponto único de falha (Single Point of Failure).
1.2. Rede Colaborativa Peer-to-Peer (Decentralized Consensus Mesh)
Na topologia ponto a ponto (popularizada pelo framework AutoGen e debates multi-agentes), os agentes comunicam-se de forma direta ou por meio de um barramento de mensagens compartilhado (Group Chat).
- Mecanismo: Cada agente expressa sua perspectiva, contesta premissas de outros agentes e propõe correções até que um critério de parada por consenso ou contagem de turnos seja atingido.
- Vantagens: Emergência de raciocínio não linear, riqueza de exploração de soluções e capacidade de auto-correção por divergência.
- Desvantagens: Alto consumo de tokens ($O(N2)$ mensagens no pior cenário) e susceptibilidade a deriva de foco (topic drifting).
1.3. Orquestração em Grafo de Estados Direcionado Acíclico (DAG & Stateful Graphs)
Adotada por sistemas de ponta (como LangGraph e MetaGPT), essa abordagem modela a interação entre agentes como uma máquina de estados finita ou um grafo direcionado.
- Mecanismo: Nós representam funções cognitivas de agentes e arestas representam transições condicionais governadas pelo resultado de validações booleanas ou rubricas numéricas.
- Vantagens: Reprodutibilidade total, suporte nativo a checkpoints, execução concorrente de etapas independentes e persistência de estado.
2. O Padrão Model Context Protocol (MCP): Interoperabilidade Aberta
O Model Context Protocol (MCP) foi projetado para resolver a fragmentação de integrações no ecossistema de IA. Ele define um contrato de comunicação formal entre Aplicações Host (MCP Clients) e Servidores de Contexto (MCP Servers).
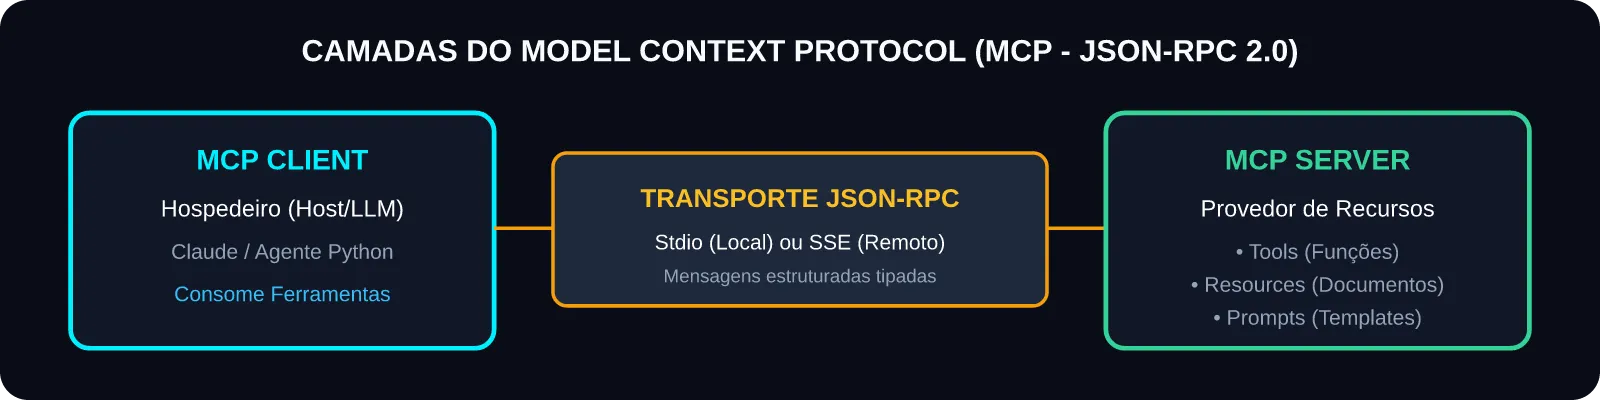
2.1. Os Três Pilares Primitivos do MCP
O protocolo organiza o intercâmbio de contexto em três entidades formais:
| Primitiva MCP | Direção | Finalidade Técnica | Exemplo de Implementação |
|---|---|---|---|
| Tools (Ferramentas) | Cliente → Servidor (Execução) | Funções acionáveis expostas ao LLM com validação de esquema JSON Schema | execute_sql_query, deploy_container, fetch_metrics |
| Resources (Recursos) | Servidor → Cliente (Leitura) | Dados orientados a leitura anexados ao contexto como documentos passivos | file:///var/log/syslog, db://schema/users, git://commit/head |
| Prompts (Modelos) | Servidor → Cliente (Instrução) | Templates de prompts parametrizados e reutilizáveis mantidos pelo servidor | analyze_code_vulnerability, summarize_incident |
2.2. Camada de Transporte e Mensageria JSON-RPC 2.0
A comunicação MCP opera sobre canais de transporte padronizados:
- Transporte Local (
stdio): O cliente instancia o servidor MCP como um subprocesso filho e troca mensagens estruturadas viastdin/stdout. Ideal para ferramentas locais de desenvolvimento e segurança restrita. - Transporte Remoto (
Server-Sent Events - SSE/HTTP POST): Comunicação distribuída cliente-servidor através de endpoints HTTPS com streaming unidirecional de eventos e requisições assíncronas.
Exemplo de envelope JSON-RPC 2.0 para invocação de ferramenta (tools/call):
{
  "jsonrpc": "2.0",
  "id": "req-0042",
  "method": "tools/call",
  "params": {
    "name": "calculate_risk_score",
    "arguments": {
      "asset_type": "database_cluster",
      "exposure_level": "public"
    }
  }
}
3. Loop de Auto-Reflexão Multi-Agente (Reflexion Framework)
O framework Reflexion (Shinn et al., 2023) introduziu a formalização de que a auto-reflexão não deve depender apenas da memória de curto prazo de um único agente, mas sim de um sistema adversarial cooperativo de avaliação.
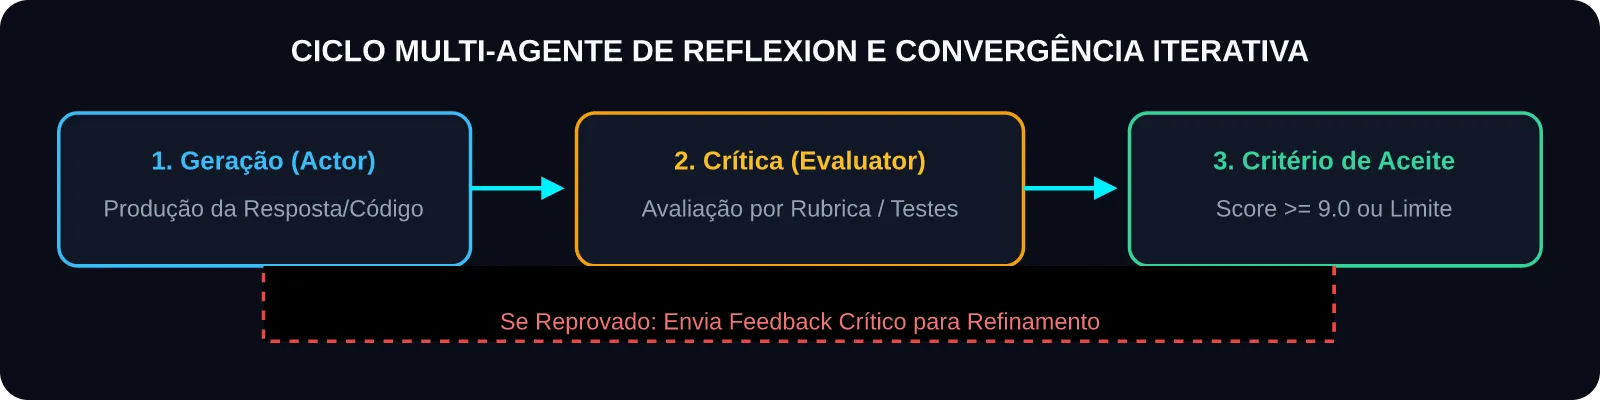
3.1. A Dinâmica Actor-Evaluator-Reflector
No paradigma multi-agente, o processo é dividido em papéis explícitos com prompts de sistema isolados:
- Agente Executor (Actor Agent):
- Possui acesso às ferramentas do MCP Server.
- Produz o primeiro artefato (código, plano, resposta analítica) com base nas restrições de entrada.
- Agente Crítico (Evaluator Agent):
- Não executa código diretamente; sua responsabilidade é estritamente avaliar e auditar a saída do Actor.
- Aplica uma rubrica de avaliação determinística composta por métricas quantitativas (0.0 a 10.0) e diagnósticos qualitativos de falhas (ex.: Missing Edge Cases, Security Vulnerabilities, Performance Bottlenecks).
- Mecanismo de Convergência (Convergence Loop):
- Se o score emitido pelo Evaluator atingir o limiar de qualidade estabelecido (Score ≥, onde tipicamente = 9.0), o fluxo é finalizado com sucesso.
- Caso contrário, o diagnóstico textual do Evaluator é anexado como memória episódica corretiva no prompt subsequente do Actor, iniciando uma nova rodada de refinamento até o limite máximo de iterações ($K$).
Reflexão Corretiva: Mt+1 = Mt ∪ {Diagnóstico de Errot} ⟹ P(Sucessot+1) > P(Sucessot)
4. Arquitetura Integrada: Redes de Agentes Conectadas por MCP
Ao unificar o desacoplamento do Model Context Protocol com a robustez do Reflexion Multi-Agent Loop, obtemos uma arquitetura corporativa completa:
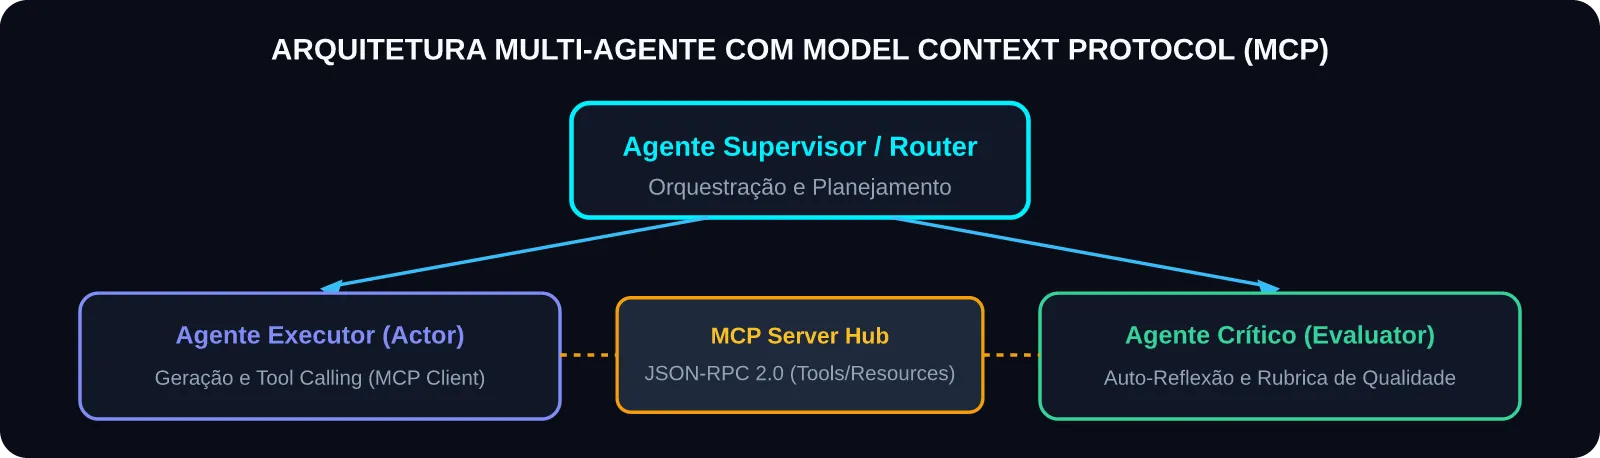
Vantagens da Composição:
- Isolamento de Segurança: O Evaluator Agent e o Supervisor não precisam de credenciais diretas nos bancos de dados ou APIs corporativas; apenas o Actor interage com o servidor MCP sob permissões de escopo reduzido.
- Auditabilidade Completa: Todas as chamadas de ferramentas e todas as críticas intermediárias geram um log estruturado em formato JSON-RPC, permitindo rastrear exatamente por que o sistema convergiu para determinada decisão.
5. Implementação Completa em Python: Servidor MCP, Agentes e Loop de Reflexion
Abaixo, apresentamos uma implementação completa e funcional em Python. O código simula a camada de transporte JSON-RPC do MCP, o catálogo de ferramentas, o Agente Executor, o Agente Crítico e o Orquestrador com controle de convergência.
O código a seguir está pronto para execução:
import json
import time
from typing import Dict, Any, List, Tuple

class MCPServer:
    def __init__(self, server_name: str):
        self.server_name = server_name
        self.tools: Dict[str, Dict[str, Any]] = {}
    def register_tool(self, name: str, description: str, schema: Dict[str, Any], handler):
        self.tools[name] = {"description": description, "schema": schema, "handler": handler}
    def handle_json_rpc(self, request_raw: str) -> str:
        req = json.loads(request_raw)
        req_id = req.get("id", "null")
        method = req.get("method")
        params = req.get("params", {})
        if method == "tools/list":
            result = [{"name": k, "description": v["description"], "inputSchema": v["schema"]} for k, v in self.tools.items()]
            return json.dumps({"jsonrpc": "2.0", "id": req_id, "result": {"tools": result}})
        elif method == "tools/call":
            tool_name = params.get("name")
            args = params.get("arguments", {})
            if tool_name in self.tools:
                try:
                    output = self.tools[tool_name]["handler"](**args)
                    return json.dumps({"jsonrpc": "2.0", "id": req_id, "result": {"content": [{"type": "text", "text": str(output)}], "isError": False}})
                except Exception as e:
                    return json.dumps({"jsonrpc": "2.0", "id": req_id, "error": {"code": -32000, "message": str(e)}})
            return json.dumps({"jsonrpc": "2.0", "id": req_id, "error": {"code": -32601, "message": "Tool not found"}})
        return json.dumps({"jsonrpc": "2.0", "id": req_id, "error": {"code": -32600, "message": "Invalid Request"}})

def query_database_mock(table: str, filter_column: str, value: str) -> str:
    db_records = {
        "servers": [{"hostname": "srv-prod-db01", "ip": "10.0.1.50", "status": "active", "cpu_load": 88.5},
                    {"hostname": "srv-prod-app01", "ip": "10.0.1.10", "status": "active", "cpu_load": 42.0}],
        "incidents": [{"id": "INC-901", "severity": "HIGH", "target": "srv-prod-db01", "root_cause": "Memory leak"}]
    }
    rows = [r for r in db_records.get(table, []) if str(r.get(filter_column)) == value]
    return json.dumps(rows, ensure_ascii=False)

def execute_remediation_mock(hostname: str, action: str) -> str:
    return json.dumps({"status": "SUCCESS", "hostname": hostname, "action_performed": action, "timestamp": time.time()})

class MCPClient:
    def __init__(self, server: MCPServer):
        self.server = server
        self.req_counter = 0
    def send_request(self, method: str, params: Dict[str, Any]) -> Dict[str, Any]:
        self.req_counter += 1
        payload = json.dumps({"jsonrpc": "2.0", "id": f"req-{self.req_counter}", "method": method, "params": params})
        resp_raw = self.server.handle_json_rpc(payload)
        return json.loads(resp_raw)

class ActorAgent:
    def __init__(self, client: MCPClient):
        self.client = client
        self.memory_feedback: List[str] = []
    def generate_solution(self, goal: str, iteration: int) -> Dict[str, Any]:
        tools_metadata = self.client.send_request("tools/list", {})["result"]["tools"]
        diagnostic_context = ""
        if iteration == 1:
            rpc_res = self.client.send_request("tools/call", {"name": "query_database", "arguments": {"table": "servers", "filter_column": "hostname", "value": "srv-prod-db01"}})
            diagnostic_context = rpc_res["result"]["content"][0]["text"]
            solution = {
                "action_plan": "Reiniciar servico da aplicacao",
                "target_host": "srv-prod-db01",
                "mcp_tool_to_call": "execute_remediation",
                "tool_arguments": {"hostname": "srv-prod-db01", "action": "restart_service"},
                "diagnostic_used": diagnostic_context
            }
        else:
            latest_critique = self.memory_feedback[-1] if self.memory_feedback else "None"
            rpc_res = self.client.send_request("tools/call", {"name": "query_database", "arguments": {"table": "incidents", "filter_column": "target", "value": "srv-prod-db01"}})
            diagnostic_context = rpc_res["result"]["content"][0]["text"]
            solution = {
                "action_plan": "Isolar no balanceador e aplicar limpeza de buffer de memoria conforme causa raiz INC-901",
                "target_host": "srv-prod-db01",
                "mcp_tool_to_call": "execute_remediation",
                "tool_arguments": {"hostname": "srv-prod-db01", "action": "flush_buffer_and_isolate"},
                "addressed_critique": latest_critique,
                "diagnostic_used": diagnostic_context
            }
        return solution

class EvaluatorAgent:
    def __init__(self, pass_threshold: float = 9.0):
        self.pass_threshold = pass_threshold
    def critique(self, goal: str, solution: Dict[str, Any]) -> Tuple[float, str]:
        plan = solution.get("action_plan", "")
        if "isolate" in plan.lower() or "flush" in plan.lower() or "inc-901" in str(solution).lower():
            score = 9.5
            critique = "Aprovado. O plano analisa a causa raiz de vazamento de memoria (INC-901) e isola o host com seguranca."
            return score, critique
        else:
            score = 6.0
            critique = "Reprovado. Reiniciar servico sem verificar incidentes abertos causa indisponibilidade em producao. Consulte a tabela de incidentes."
            return score, critique

class MultiAgentReflexionOrchestrator:
    def __init__(self, actor: ActorAgent, evaluator: EvaluatorAgent, max_iterations: int = 3):
        self.actor = actor
        self.evaluator = evaluator
        self.max_iterations = max_iterations
    def execute(self, goal: str) -> Dict[str, Any]:
        trace = []
        for i in range(1, self.max_iterations + 1):
            solution = self.actor.generate_solution(goal, iteration=i)
            score, critique = self.evaluator.critique(goal, solution)
            step_record = {"iteration": i, "solution": solution, "score": score, "critique": critique}
            trace.append(step_record)
            if score >= self.evaluator.pass_threshold:
                final_exec = self.actor.client.send_request("tools/call", {"name": solution["mcp_tool_to_call"], "arguments": solution["tool_arguments"]})
                return {"status": "SUCCESS", "converged_at_iteration": i, "final_score": score, "solution": solution, "execution_result": final_exec["result"], "history": trace}
            self.actor.memory_feedback.append(critique)
        return {"status": "MAX_ITERATIONS_REACHED", "final_score": score, "solution": solution, "history": trace}

if __name__ == "__main__":
    server = MCPServer("Infrastructure-MCP-Hub")
    server.register_tool("query_database", "Consulta registros operacionais em banco de dados", {"type": "object", "properties": {"table": {"type": "string"}, "filter_column": {"type": "string"}, "value": {"type": "string"}}}, query_database_mock)
    server.register_tool("execute_remediation", "Executa acoes de remediacao no servidor", {"type": "object", "properties": {"hostname": {"type": "string"}, "action": {"type": "string"}}}, execute_remediation_mock)
    client = MCPClient(server)
    actor = ActorAgent(client)
    evaluator = EvaluatorAgent(pass_threshold=9.0)
    orchestrator = MultiAgentReflexionOrchestrator(actor, evaluator, max_iterations=3)
    mission_goal = "Diagnosticar e remediar a sobrecarga de CPU no host srv-prod-db01"
    result = orchestrator.execute(mission_goal)
    print(json.dumps(result, indent=2, ensure_ascii=False))
6. Comparativo Técnico: Abordagens de Orquestração e Protocolos
Abaixo, confrontamos as características arquiteturais das principais topologias de comunicação e transporte para agentes autônomos:
Tabela 1: Matriz Comparativa de Topologias Multi-Agentes
| Dimensão Técnica | Topologia Hierárquica (Supervisor) | Topologia Peer-to-Peer (Chat Mesh) | Grafo de Estados (Stateful DAG) |
|---|---|---|---|
| Complexidade de Implementação | Baixa a Média | Média | Alta (Exige modelagem formal de nós) |
| Consumo de Tokens por Tarefa | $O(N)$ (Linear ao número de etapas) | $O(N2)$ (Quadrático no pior caso) | $O(N)$ (Otimizado por checkpoint) |
| Determinismo e Reprodutibilidade | Alto | Baixo (Emergente/Estocástico) | Máximo (Grafo finito de transição) |
| Capacidade de Auto-Reflexão | Moderada (Focada no Supervisor) | Alta (Crítica cruzada contínua) | Excelente (Nós de validação dedicados) |
| Resiliência a Falhas de Agente | Média (Supervisor precisa tratar) | Alta (Outro par pode intervir) | Máxima (Rollback via checkpoints) |
| Casos de Uso Ideais | Pipelines de CI/CD e suporte ao cliente | Brainstorming e pesquisa exploratória | Sistemas de produção e missão crítica |
Tabela 2: Protocolos de Integração de Ferramentas: MCP vs. OpenAI Function Calling vs. LangChain Tools
| Parâmetro de Avaliação | Model Context Protocol (MCP) | OpenAI Function Calling | LangChain Tools Framework |
|---|---|---|---|
| Governança e Padrão | Protocolo Aberto (Anthropic / Linux Foundation) | Proprietário (OpenAI API spec) | Biblioteca em código aberto (Python/TS) |
| Arquitetura de Conexão | Cliente-Servidor (Stdio / SSE JSON-RPC 2.0) | Acoplada ao payload HTTP da API | In-memory Python objects |
| Suporte a Documentos (Resources) | Nativo (URIs padronizadas) | Manual via prompt context | Requer Document Loaders customizados |
| Templates Reutilizáveis (Prompts) | Nativo via servidor MCP | Não suportado nativamente | LangChain Hub / PromptTemplates |
| Desacoplamento de Modelo | Total (Funciona com Claude, GPT, Llama, Gemini) | Limitado à API da OpenAI | Total (Abstração em nível de software) |
7. Estratégias Avançadas para Reduzir Latência e Custos em Produção
A orquestração de múltiplos agentes com loops de auto-reflexão pode introduzir latência excessiva se não for acompanhada de otimizações arquiteturais rigorosas:
- Roteamento de Modelos por Papel Cognitivo (Model Tiering):
- Utilize modelos de raciocínio de alta capacidade (como Claude 3.5 Sonnet ou GPT-4o) exclusivamente para o papel de Supervisor e Evaluator.
- Empregue modelos compactos e rápidos (como modelos destilados de 8B a 14B parâmetros) para as chamadas determinísticas de ferramentas no Actor.
- Execução Especulativa de Ferramentas (Speculative Tool Execution):
- Quando o plano de tarefas do Supervisor identifica etapas independentes (ex.: consultar métricas de CPU e consultar logs de segurança simultaneamente), o cliente MCP deve disparar as requisições JSON-RPC em paralelo usando
asyncio.
- Poda de Histórico Crítico (Feedback Pruning):
- Evite acumular transcrições completas de tentativas anteriores na memória do Actor. Sintetize as críticas do Evaluator em listas de marcadores de ação corretiva (Actionable Deltas), preservando a janela de contexto limpa.
8. Perguntas Frequentes (FAQ)
1. Qual é a diferença fundamental entre uma Tool clássica de LLM e um Servidor MCP?
Uma Tool clássica é uma função em código local declarada diretamente no payload da requisição do LLM. Um Servidor MCP é um microsserviço independente e padronizado que gerencia não apenas ferramentas executáveis (Tools), mas também documentos em tempo real (Resources) e modelos de instruções (Prompts), permitindo que múltiplos agentes e clientes compartilhem as mesmas capacidades de forma segura via JSON-RPC 2.0.
2. Como evitar que o loop de Reflexion entre em ciclo infinito de rejeição?
Implementam-se três travas de segurança: (1) um limite rígido de iterações máximas (K ≤ 3 a $5$), (2) decaimento adaptativo do limiar de aceitação (dynamic threshold decay), onde a cada rodada o score mínimo aceitável é ligeiramente flexibilizado para encorajamento de convergência, e (3) intervenção de Human-in-the-Loop quando o número máximo de tentativas for atingido.
3. O MCP suporta autenticação e controle de acesso por agente?
Sim. Na camada de transporte HTTP/SSE, o MCP herda mecanismos padrão da web como OAuth 2.0, Bearer Tokens e mTLS. Além disso, o servidor MCP pode inspecionar o cabeçalho da requisição para restringir o catálogo de ferramentas retornado em tools/list com base na identidade ou papel (role) do agente requisitante.
4. Sistemas multi-agentes sempre superam agentes únicos com prompts longos?
Não. Para tarefas lineares de recuperação pontual de informação ou tarefas com poucas dependências, um agente único (Single-Agent) bem estruturado é mais rápido, mais barato e menos sujeito a latência de rede. Sistemas multi-agentes superam agentes únicos em tarefas que exigem validação cruzada independente, decomposição em áreas de conhecimento distintas e mitigação crítica de alucinações.
Referências Bibliográficas e Literatura Técnica
- ANTHROPIC. Model Context Protocol (MCP) Specification: Open Protocol for AI-Assisted Development and Tool Integration. Version 1.0. Anthropic Documentation, 2024/2025. Disponível em: https://modelcontextprotocol.io.
- SHINN, Noah et al. Reflexion: Language Agents with Verbal Reinforcement Learning. Advances in Neural Information Processing Systems (NeurIPS), v. 36, 2023. arXiv:2303.11366.
- WU, Qingyun et al. AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation Framework. arXiv preprint, arXiv:2308.08155, 2023.
- HONG, Sirui et al. MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework. Proceedings of the International Conference on Learning Representations (ICLR), 2024. arXiv:2308.00352.
- YAO, Shunyu et al. ReAct: Synergizing Reasoning and Acting in Language Models. Proceedings of the International Conference on Learning Representations (ICLR), 2023. arXiv:2210.03629.
- CHASE, Harrison. LangGraph: Building Stateful, Multi-Actor Applications with LLMs. LangChain Technical Whitepaper, 2024.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…