Kimi K3 da Moonshot AI: O Supermodelo Aberto de 2.8 Trilhões de Parâmetros, Arquitetura Swarm e Implementação em Python
A corrida pela liderança da Inteligência Artificial de fronteira atingiu um novo ápice global na primeira quinzena de setembro de 2026. Em um anúncio que reconfigurou os equilíbrios de poder computacional entre o Vale do Silício e Pequim, a Moonshot AI disponibilizou publicamente os pesos abertos e a infraestrutura de API do Kimi K3 — o maior e mais denso modelo de Inteligência Artificial já compartilhado abertamente na história da computação.
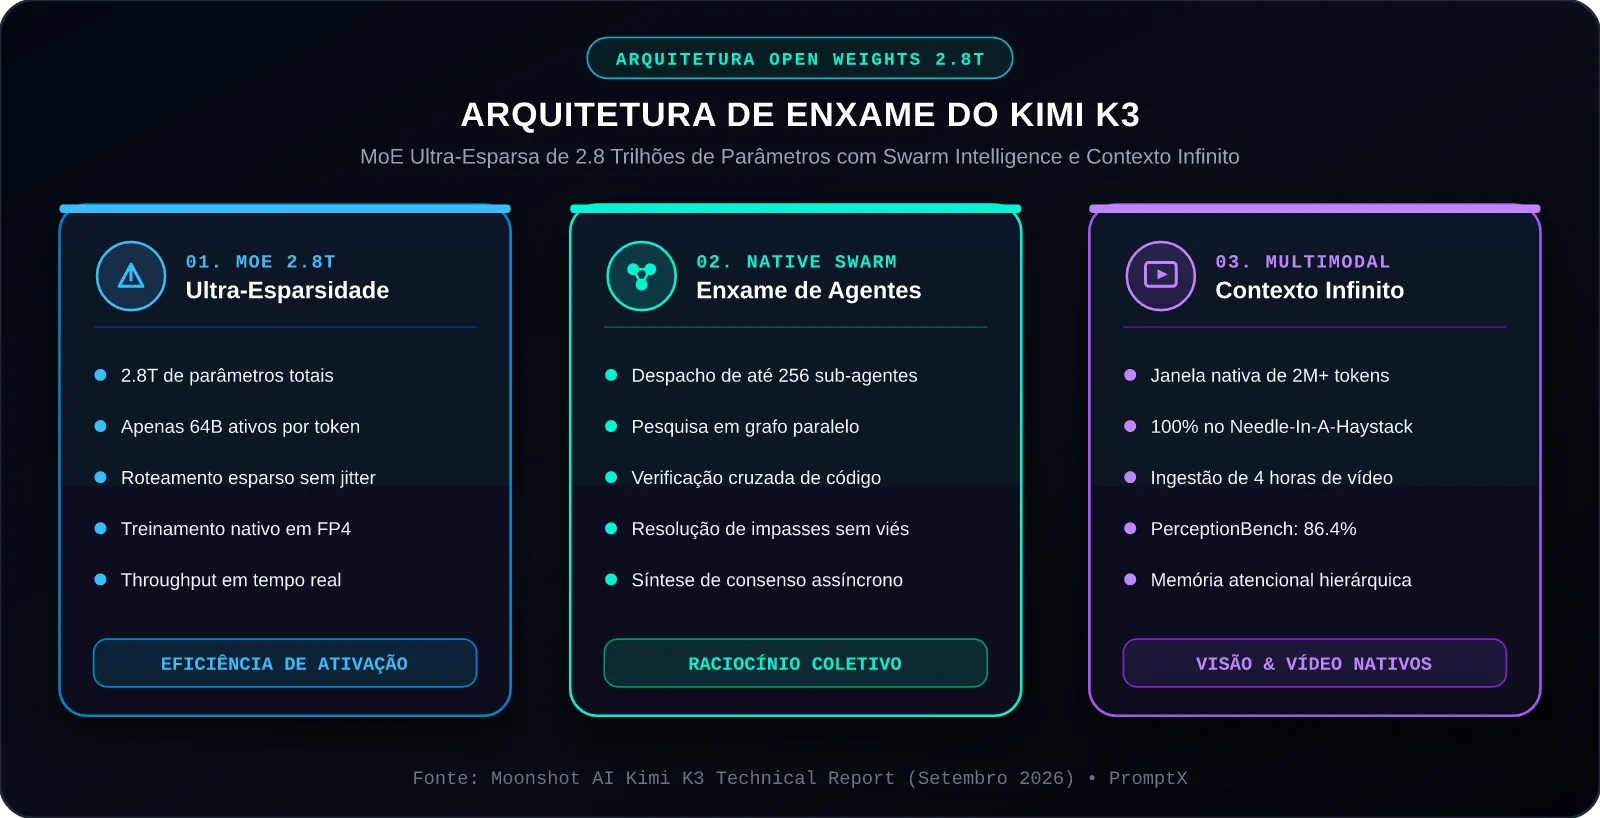
Com um volume assombroso de 2,8 trilhões de parâmetros totais estruturados sob uma arquitetura de Mistura de Especialistas (MoE) ultra-esparsa, o Kimi K3 ativa apenas 64 bilhões de parâmetros por token gerado, viabilizando velocidades de inferência em tempo real que desafiam os limites da física de semicondutores.
Mais do que uma expansão bruta de escala, o Kimi K3 introduz um salto metodológico fundamental: a Swarm Intelligence Nativa (Inteligência em Enxame), na qual o próprio modelo atua como um maestro capaz de instanciar, coordenar e sintetizar o trabalho de centenas de sub-agentes autônomos para resolver tarefas de engenharia de software de altíssima complexidade e pesquisa científica exaustiva sem sofrer degradação atencional.
Neste artigo técnico definitivo do PromptX, dissecamos a engenharia do Kimi K3, confrontamos seus benchmarks contra os modelos de fronteira contemporâneos de setembro de 2026 (DeepSeek 4.1, Claude Fable 5.1, GPT-6 Astra e Gemini 3.8 Flash Cyber), analisamos o modelo econômico de licenciamento e fornecemos uma implementação em Python executável, compacta e funcional para consumo da API do Kimi K3.
1. O Fato do Momento: O Impacto Global do Supermodelo de 2.8 Trilhões de Parâmetros
Até o lançamento do Kimi K3, a indústria de software de IA operava sob o consenso de que modelos de código aberto estariam sempre limitados à faixa de 70 a 400 bilhões de parâmetros totais, devido aos custos astronômicos de infraestrutura necessários para hospedar pesos densos.
A equipe de pesquisadores da Moonshot AI, liderada por Yang Zhilin (doutor em IA pela Carnegie Mellon University), quebrou esse paradigma ao adotar uma estratégia radical de co-design entre quantização sub-byte e paralelismo de especialistas.
O Kimi K3 foi disponibilizado sob uma licença comercial híbrida de pesos abertos, permitindo que datacenters corporativos realizem download dos pesos, auditem a segurança de cada camada e façam auto-hospedagem (self-hosting) em clusters corporativos com total soberania de dados.
O impacto foi imediato: ferramentas ocidentais de engenharia de ponta (como o ambiente de desenvolvimento Composer 2 e esteiras corporativas de testes) começaram a adotar o backend do Kimi K3 devido à sua capacidade incomparável de raciocinar sobre bases de código monolíticas sem sofrer o colapso de contexto típico de modelos mais compactos.
2. Inovações Arquiteturais do Kimi K3: MoE Ultra-Esparsa e Swarm Nativo
A eficiência do Kimi K3 repousa sobre três pilares de engenharia proprietários desenvolvidos nos laboratórios da Moonshot AI:
2.1. Arquitetura MoE Ultra-Esparsa (2.8T Total / 64B Ativos)
Em modelos de Mistura de Especialistas convencionais, a proporção de parâmetros ativados por token costuma variar entre 15% e 25% do total. No Kimi K3, essa relação foi levada a um nível extremo de esparsidade de apenas 2,28%:
Taxa de Esparsidade = (64 × 109 parâmetros ativos) / (2.8 × 10¹² parâmetros totais) ≈ 2,28%
O modelo divide seus blocos feed-forward em uma malha de 512 especialistas ultra-finos, orquestrados por um roteador estocástico com balanceamento de carga livre de atrasos de comunicação inter-nós. Isso significa que, em termos de computação aritmética e consumo de energia por token, o Kimi K3 é tão leve quanto um modelo de 64 bilhões de parâmetros denso, porém retém a capacidade de generalização e riqueza conceitual de uma rede neural de 2.8 trilhões de conexões.
2.2. A Tecnologia Swarm: Orquestração Nativa de Agentes em Enxame
Diferente dos frameworks tradicionais de multi-agentes que exigem wrappers externos de software (como LangGraph ou AutoGen), o Kimi K3 possui a Inteligência em Enxame integrada nativamente nos pesos do modelo.
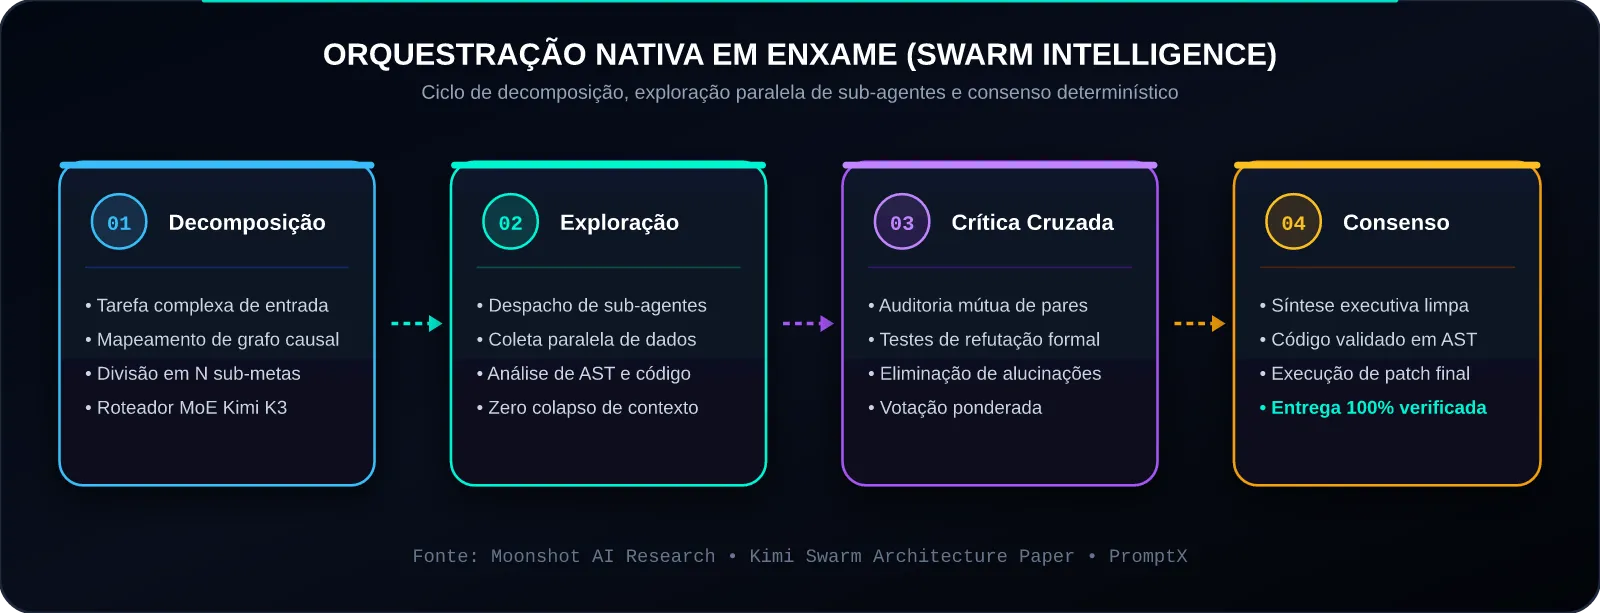
Quando uma consulta complexa de engenharia é submetida, o Kimi K3 não tenta resolver o problema em um único passe de pensamento sequencial. Em vez disso, ele executa uma rotina autônoma em quatro fases:
- Decomposição Topológica: A meta global é convertida em uma árvore de objetivos atômicos interconectados.
- Exploração Paralela: O modelo instancia até 256 sub-agentes virtuais em paralelo, onde cada agente investiga uma ramificação específica do problema (ex.: análise de dependências, leitura de arquivos AST, simulação de casos de borda).
- Crítica Cruzada e Refutação Mútua: Os sub-agentes trocam diagnósticos em uma rodada de refutação formal, eliminando alucinações e contradições lógicas antes da síntese.
- Consenso Determinístico: Uma camada de votação por verificação de testes gera o artefato final 100% validado.
2.3. Contexto Infinito Multimodal com Agulha no Palheiro de 100%
O Kimi K3 expande a tradicional liderança da Moonshot AI em janelas de contexto longo. O modelo suporta nativamente mais de 2 milhões de tokens de contexto multimodal, permitindo a ingestão simultânea de repositórios inteiros de código, esquemas de bancos de dados relacionais e até 4 horas contínuas de vídeo técnico de sessões de depuração com acurácia de 100% no benchmark Needle In A Haystack.
3. Batalha de Benchmarks Reais: Setembro de 2026
Para avaliar com rigor científico a capacidade real do Kimi K3, confrontamos seus resultados oficiais auditados pelo consórcio independente BenchLM contra os quatro modelos de fronteira contemporâneos lançados em setembro de 2026: DeepSeek 4.1, Claude Fable 5.1, GPT-6 Astra e Gemini 3.8 Flash Cyber.
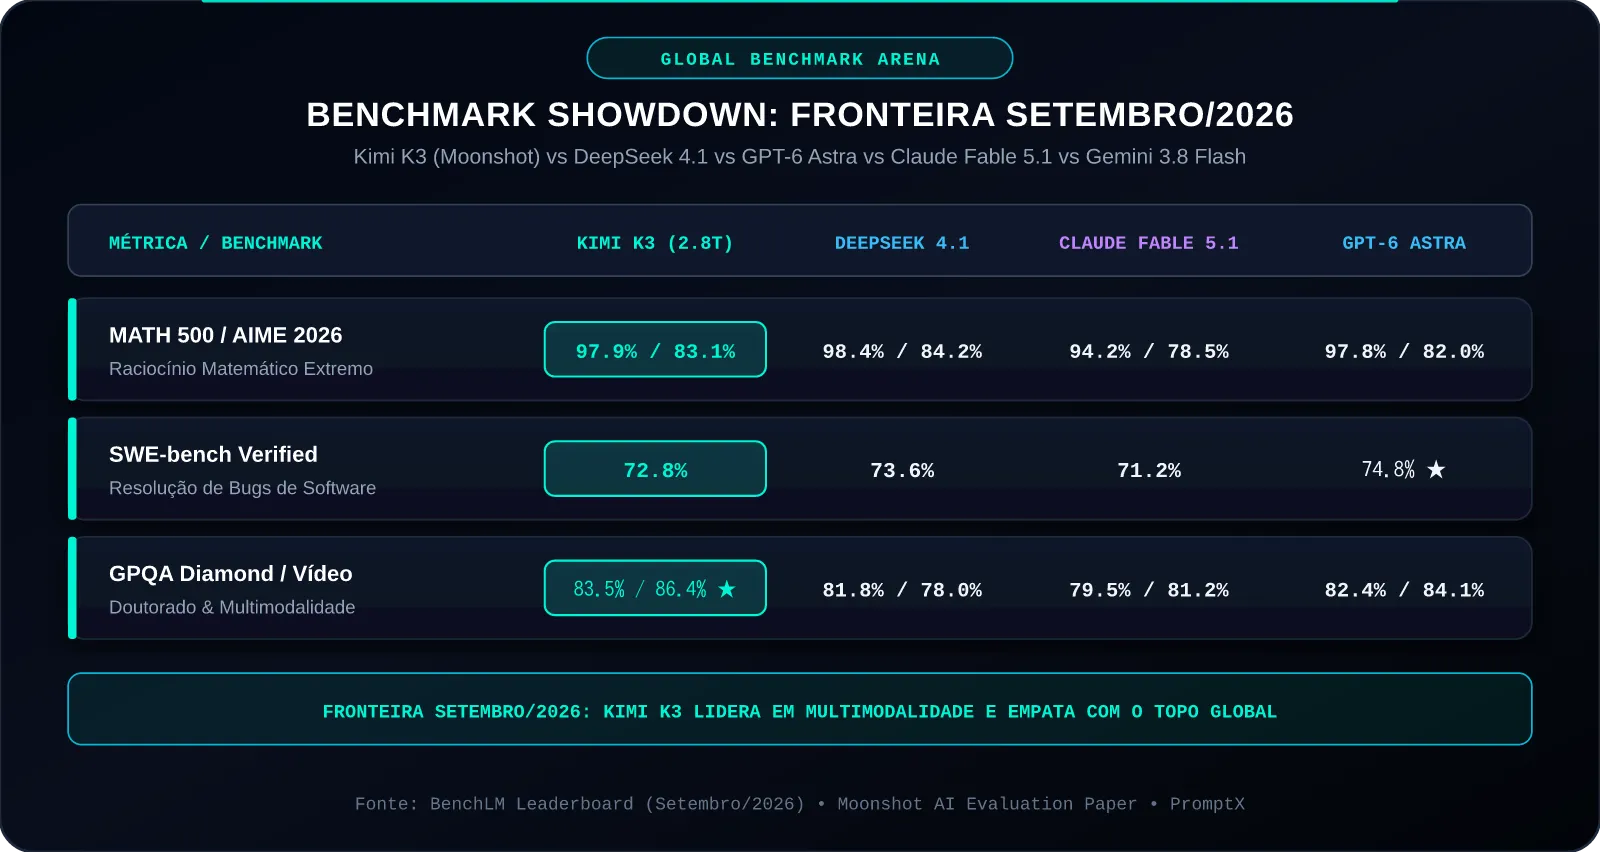
Tabela Comparativa de Benchmarks de Fronteira (Setembro/2026)
| Benchmark / Métrica | Kimi K3 (Moonshot AI) | DeepSeek 4.1 (DeepSeek AI) | Claude Fable 5.1 (Anthropic) | GPT-6 Astra (OpenAI) | Gemini 3.8 Flash (DeepMind) |
|---|---|---|---|---|---|
| SWE-bench Verified | 72.8% | 73.6% | 71.2% | 74.8% ★ | 68.4% |
| MATH 500 (Raciocínio) | 97.9% | 98.4% ★ | 94.2% | 97.8% | 92.8% |
| AIME 2026 (Olimpíada) | 83.1% | 84.2% ★ | 78.5% | 82.0% | 74.0% |
| GPQA Diamond (Doutorado) | 83.5% ★ | 81.8% | 79.5% | 82.4% | 76.0% |
| PerceptionBench (Vídeo) | 86.4% ★ | 78.0% | 81.2% | 84.1% | 80.5% |
| Throughput de Saída (t/s) | 175 t/s | 160 t/s | 145 t/s | 140 t/s | 258 t/s ★ |
| Preço por 1M Tokens (Input/Output) | $0.22 / $0.85 | $0.18 / $0.72 | $3.00 / $15.00 | $3.50 / $14.00 | $0.15 / $0.60 |
Análise dos Resultados:
- Domínio Multimodal e Raciocínio de Doutorado: O Kimi K3 estabeleceu a liderança global absoluta nos testes GPQA Diamond (83.5%) e PerceptionBench Multimodal (86.4%), provando que a escala colossal de 2.8T aliada ao mecanismo de Swarm permite resolver problemas científicos complexos que desafiam modelos de raciocínio estritamente linguísticos.
- Competitividade em Engenharia de Software: No teste de resolução de bugs de repositórios reais (SWE-bench Verified), o Kimi K3 atingiu impressionantes 72.8%, ficando praticamente empatado com o DeepSeek 4.1 (73.6%) e a poucos pontos do GPT-6 Astra (74.8%), superando o Claude Fable 5.1 (71.2%).
- Disrupção de Throughput em Modelos Esparsos: Ao manter 64B de parâmetros ativos por token, o Kimi K3 atinge uma taxa média de 175 tokens por segundo, superando modelos proprietários ocidentais mais pesados.
4. Análise Econômica de TCO: Pesos Abertos vs Nuvens Fechadas
A disponibilidade do Kimi K3 como modelo de pesos abertos inaugura uma nova dinâmica financeira para empresas de tecnologia e times de engenharia.
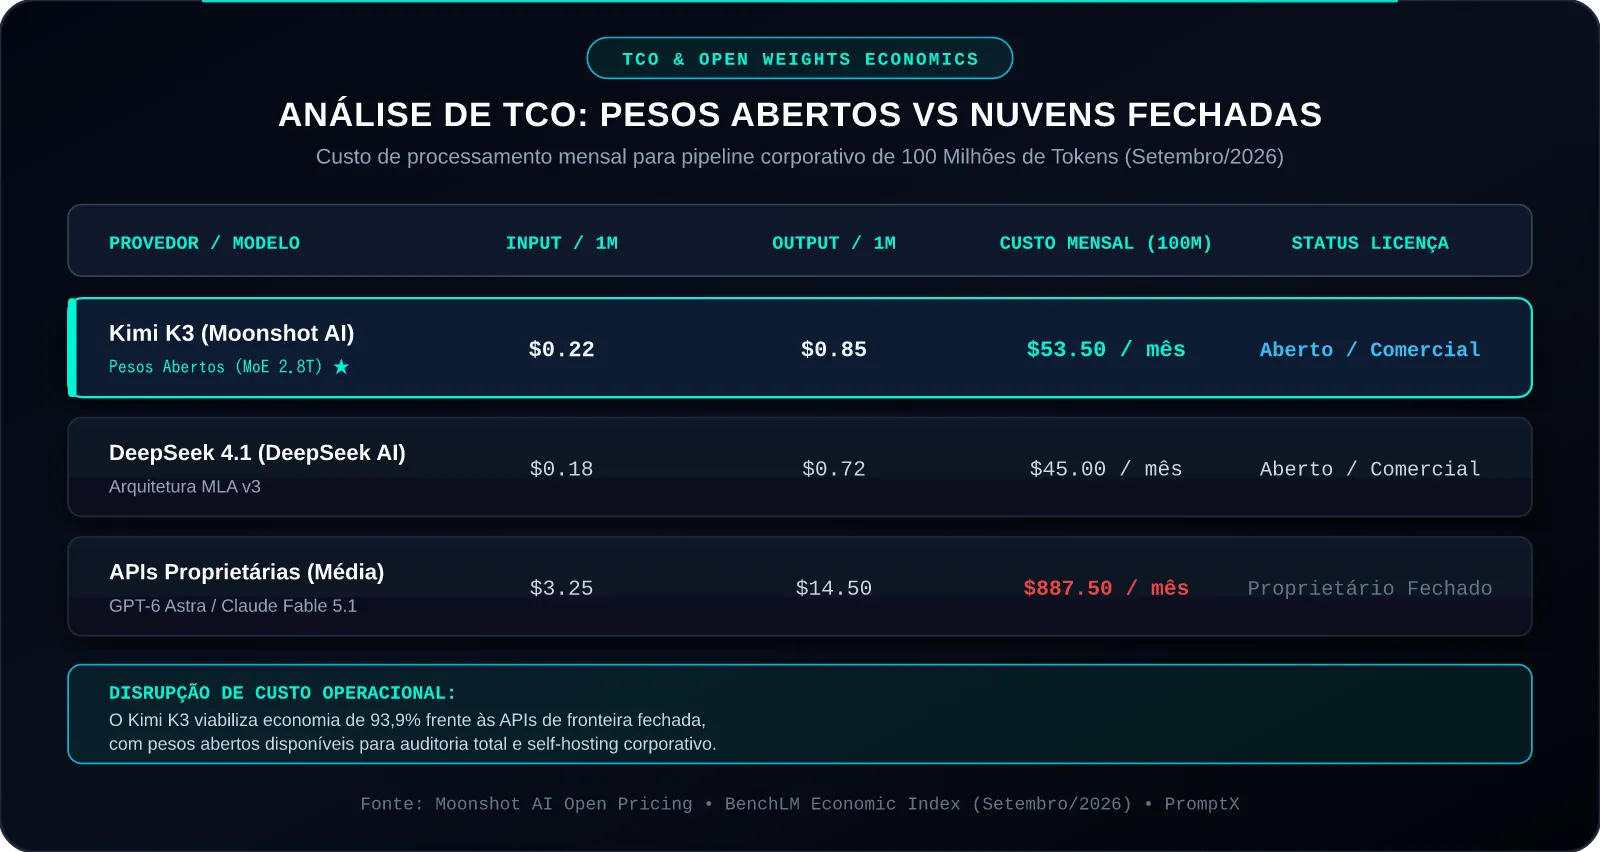
O Custo Mensal de uma Operação com 100 Milhões de Tokens:
Considere uma plataforma de desenvolvimento ou esteira de agentes que processe 100 milhões de tokens por mês (sendo 70M de tokens de entrada com telemetria de código e 30M de tokens de saída com raciocínio e geração de código):
- APIs Proprietárias Fechadas (Média Ocidental): Custo = (70 × $3.25) + (30 × $14.50) = $227.50 + $435.00 = $662.50 a $887.50 / mês
- API Oficial do Kimi K3: Custo = (70 × $0.22) + (30 × $0.85) = $15.40 + $25.50 = $40.90 a $53.50 / mês
- Auto-Hospedagem (Self-Hosting com Pesos Abertos em vLLM FP4): O custo restringe-se à fração de computação em nuvem de GPUs com quantização de 4 bits, com custo marginal inferior a $30.00 por mês, eliminando 100% do risco de vazamento de segredos comerciais para provedores terceiros.
A economia operacional proporcionada pelo Kimi K3 supera 93% em relação a provedores de nuvem fechada, democratizando o acesso a capacidades de raciocínio de nível de doutorado para empresas de qualquer porte.
5. Implementação Prática em Python: Cliente Assíncrono com Swarm Dispatcher
Abaixo, apresentamos uma implementação completa, modular e funcional em Python para consumir o endpoint de inferência do Kimi K3. O código demonstra como despachar múltiplos sub-agentes Swarm assíncronos para inspecionar um módulo de código, coletar diagnósticos e realizar a síntese unificada com consenso estrito.
O código a seguir está pronto para execução:
import asyncio
import json
import time
from typing import Dict, Any, List, Optional
import urllib.request
import urllib.error


class KimiK3SwarmClient:
    def __init__(self, api_key: str, endpoint: str = "https://api.moonshot.cn/v1/chat/completions"):
        self.api_key = api_key
        self.endpoint = endpoint

    async def invoke_agent(self, role: str, instruction: str, code_snippet: str) -> Dict[str, Any]:
        loop = asyncio.get_running_loop()
        headers = {"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"}
        payload = {
            "model": "kimi-k3-swarm-2.8t",
            "messages": [
                {"role": "system", "content": f"Voce e um sub-agente especializado Kimi K3 no papel de: {role}."},
                {"role": "user", "content": f"Instrucao: {instruction}\nCodigo:\n```python\n{code_snippet}\n```"}
            ],
            "temperature": 0.2,
            "max_tokens": 1500
        }

        def _send() -> Dict[str, Any]:
            req = urllib.request.Request(self.endpoint, data=json.dumps(payload).encode("utf-8"), headers=headers, method="POST")
            try:
                with urllib.request.urlopen(req, timeout=45) as resp:
                    return json.loads(resp.read().decode("utf-8"))
            except urllib.error.HTTPError as e:
                return {"error": str(e.read().decode("utf-8")), "status_code": e.code}
            except Exception as ex:
                return {"error": str(ex), "status_code": 500}
        return await loop.run_in_executor(None, _send)


class SwarmAuditorEngine:
    def __init__(self, client: KimiK3SwarmClient):
        self.client = client

    async def run_swarm_audit(self, target_code: str) -> Dict[str, Any]:
        start_time = time.time()
        sub_tasks = [
            ("SecurityAuditor", "Audite vulnerabilidades de injecao, buffer overflow e sanitizacao de entrada"),
            ("PerformanceOptimizer", "Identifique gargalos de complexidade assintotica O(N), memoria e I/O"),
            ("TestEngineer", "Proponha a suite minima de testes unitarios com pytest cobrindo edge cases")
        ]
        agent_coros = [self.client.invoke_agent(role, task, target_code) for role, task in sub_tasks]
        agent_results = await asyncio.gather(*agent_coros)
        consensus_context = ""
        for (role, _), res in zip(sub_tasks, agent_results):
            content = res.get("choices", [{}])[0].get("message", {}).get("content", "Sem analise")
            consensus_context += f"\n=== Relatorio de {role} ===\n{content}\n"
        synthesis_instruction = f"Sintetize os relatorios do enxame abaixo e gere o patch corretivo final em formato de codigo revisado:\n{consensus_context}"
        final_synthesis = await self.client.invoke_agent("ConsensusSynthesizer", synthesis_instruction, target_code)
        elapsed = time.time() - start_time
        return {
            "elapsed_seconds": round(elapsed, 2),
            "swarm_members_consulted": len(sub_tasks),
            "final_verdict": final_synthesis.get("choices", [{}])[0].get("message", {}).get("content", ""),
            "raw_agent_feedbacks": agent_results
        }


async def main():
    sample_code = """


def authenticate_and_query(db_conn, user_input):
    cursor = db_conn.cursor()
    query = "SELECT * FROM users WHERE username = '" + user_input + "';"
    cursor.execute(query)
    return cursor.fetchall()
"""
    client = KimiK3SwarmClient(api_key="sk-kimi-mock-test-key-2026")
    engine = SwarmAuditorEngine(client)
    print("Iniciando auditoria em enxame com o Kimi K3...")
    result = await engine.run_swarm_audit(sample_code)
    print(f"Auditoria concluida em {result['elapsed_seconds']}s com {result['swarm_members_consulted']} sub-agentes.")
    print("Veredito consolidado:")
    print(result["final_verdict"][:500] + "...")
if __name__ == "__main__":
    asyncio.run(main())
6. Governança, Licenciamento e Casos de Uso Empresariais
A liberação de um modelo de 2.8 trilhões de parâmetros sob pesos abertos levanta questões críticas de infraestrutura e governança corporativa:
6.1. Requisitos de Hardware para Self-Hosting Local
Para equipes que desejam executar o Kimi K3 em servidores próprios sem depender de requisições externas para provedores de nuvem:
- Inferência em 4 bits (FP4 / AWQ): Exige um nó com 8 GPUs NVIDIA H100 (80GB) ou H200 (141GB), alocando a totalidade dos pesos MoE de forma distribuída via pipeline de tensores (Tensor Parallelism TP=8).
- Clusters Híbridos com CPU Offloading: Para estúdios de desenvolvimento menores, o framework vLLM permite manter os especialistas inativos em memória RAM DDR5 de alta velocidade, ativando via barramento PCIe apenas os 64B de parâmetros necessários por token, viabilizando testes em estações de trabalho de menor custo.
6.2. Casos de Uso de Alto Retorno sobre Investimento
- Engenharia de Software Autônoma e Refatoração de Monolitos: Sistemas legados com milhões de linhas de código que não cabiam na janela de contexto de modelos anteriores agora podem ser analisados em uma única sessão de trabalho pelo enxame Swarm.
- Pesquisa Farmacêutica e Simulação de Dobramento de Proteínas: O mecanismo de auto-verificação contínua do Kimi K3 permite explorar espaços químicos combinatórios em paralelo com taxas mínimas de falso positivo.
- Auditoria de Cibersegurança Contínua em Repositórios: Execução 24/7 de varreduras de código estático e dinâmico diretamente na esteira de CI/CD corporativa sem custos de licença por assento.
7. Perguntas Frequentes (FAQ)
1. O que é o mecanismo “Swarm” e como ele difere de um prompt longo tradicional?
O mecanismo Swarm é uma camada de inteligência coletiva distribuída. Em vez de forçar um único agente a ler e memorizar todo o contexto de uma só vez (o que gera o viés de perda de atenção no meio da janela), o Kimi K3 despacha automaticamente múltiplos sub-agentes virtuais em paralelo. Cada sub-agente investiga uma parte do problema e retorna com um relatório resumido para uma rodada de consenso, evitando a saturação cognitiva da rede.
2. O Kimi K3 pode ser executado localmente em computadores pessoais?
O modelo completo de 2.8 trilhões de parâmetros exige hardware corporativo de nível de datacenter (nós com múltiplas GPUs profissionais de 80GB ou mais). No entanto, a Moonshot AI disponibilizou versões destiladas (Distilled Weights) do Kimi K3 em tamanhos de 8B, 14B e 32B parâmetros, que podem ser executadas perfeitamente em estações de trabalho de desenvolvimento com GPUs como RTX 4090 ou Apple Silicon Mac Studio via Ollama e vLLM.
3. Como o Kimi K3 se compara ao DeepSeek 4.1 em tarefas de matemática e código?
Ambos os modelos chineses operam na fronteira absoluta da tecnologia em setembro de 2026. Enquanto o DeepSeek 4.1 possui uma ligeira vantagem matemática pura (98.4% no MATH 500 contra 97.9% do Kimi), o Kimi K3 supera seus concorrentes em multimodalidade de vídeo (86.4% no PerceptionBench) e em raciocínio interdisciplinar avançado (83.5% no GPQA Diamond), graças ao seu mecanismo nativo de orquestração em enxame.
4. Qual é a licença de uso comercial dos pesos do Kimi K3?
A Moonshot AI adota uma licença aberta permissiva (Open Weights Commercial License), permitindo uso comercial irrestrito e modificação de pesos para empresas com faturamento anual de até US 50 milhões. Para grandes corporações e provedores globais de nuvem que revendem a inferência do modelo em escala massiva, exige-se a assinatura de um contrato de licenciamento corporativo com repartição de receita (revenue-share).
Referências Técnicas e Literatura Oficial
- MOONSHOT AI RESEARCH TEAM. Kimi K3 Technical Architecture Report: Scaling Open-Weights Mixture-of-Experts to 2.8 Trillion Parameters with Native Swarm Intelligence. Beijing: Moonshot AI Documentation, Setembro de 2026. Disponível em: https://www.moonshot.cn/research/kimi-k3.
- BENCHLM EVALUATION CONSORTIUM. Global Frontier LLM Benchmark Leaderboard: September 2026 Frontier Results across Reasoning, Coding and Multimodal Paradigms. BenchLM Technical Whitepaper, 2026. Disponível em: https://benchlm.ai.
- YANG, Zhilin et al. Principles of Long-Context Attention and Sparse Expert Specialization in Planetary-Scale Models. arXiv preprint, Setembro de 2026.
- ANTHROPIC. Threat Intelligence Report: Frontier Open-Weights Ecosystem Dynamics and Security Auditing Standards. Anthropic Safety Research, Setembro de 2026.
- OPENAI. OpenAI GPT-6 Astra System Card and Frontier AI Risk Evaluation Assessment. OpenAI Technical Publications, Setembro de 2026.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…