Qwen 3.8-Max da Alibaba Cloud: O Supermodelo MoE de 2.4 Trilhões de Parâmetros, 'The Agent Frontier' e Implementação em Python
A corrida pela liderança na Inteligência Artificial de fronteira atingiu uma nova fase de maturidade técnica. Se os primeiros anos da revolução dos Modelos de Linguagem de Grande Escala foram pautados por chatbots conversacionais e assistentes de texto passivos, o cenário atual de setembro de 2026 é inteiramente dominado por sistemas autônomos de longa duração (Long–Horizon Autonomous Agents). Nesse novo paradigma, a métrica de sucesso não é mais a geração de uma resposta isolada e elegante, mas sim a capacidade de um modelo sustentar pipelines complexos de trabalho — inspecionando repositórios inteiros de código, executando testes unitários em sandbox, consumindo APIs corporativas e tomando milhares de decisões sequenciais sem sofrer de degradação atencional ou alucinação cumulativa.
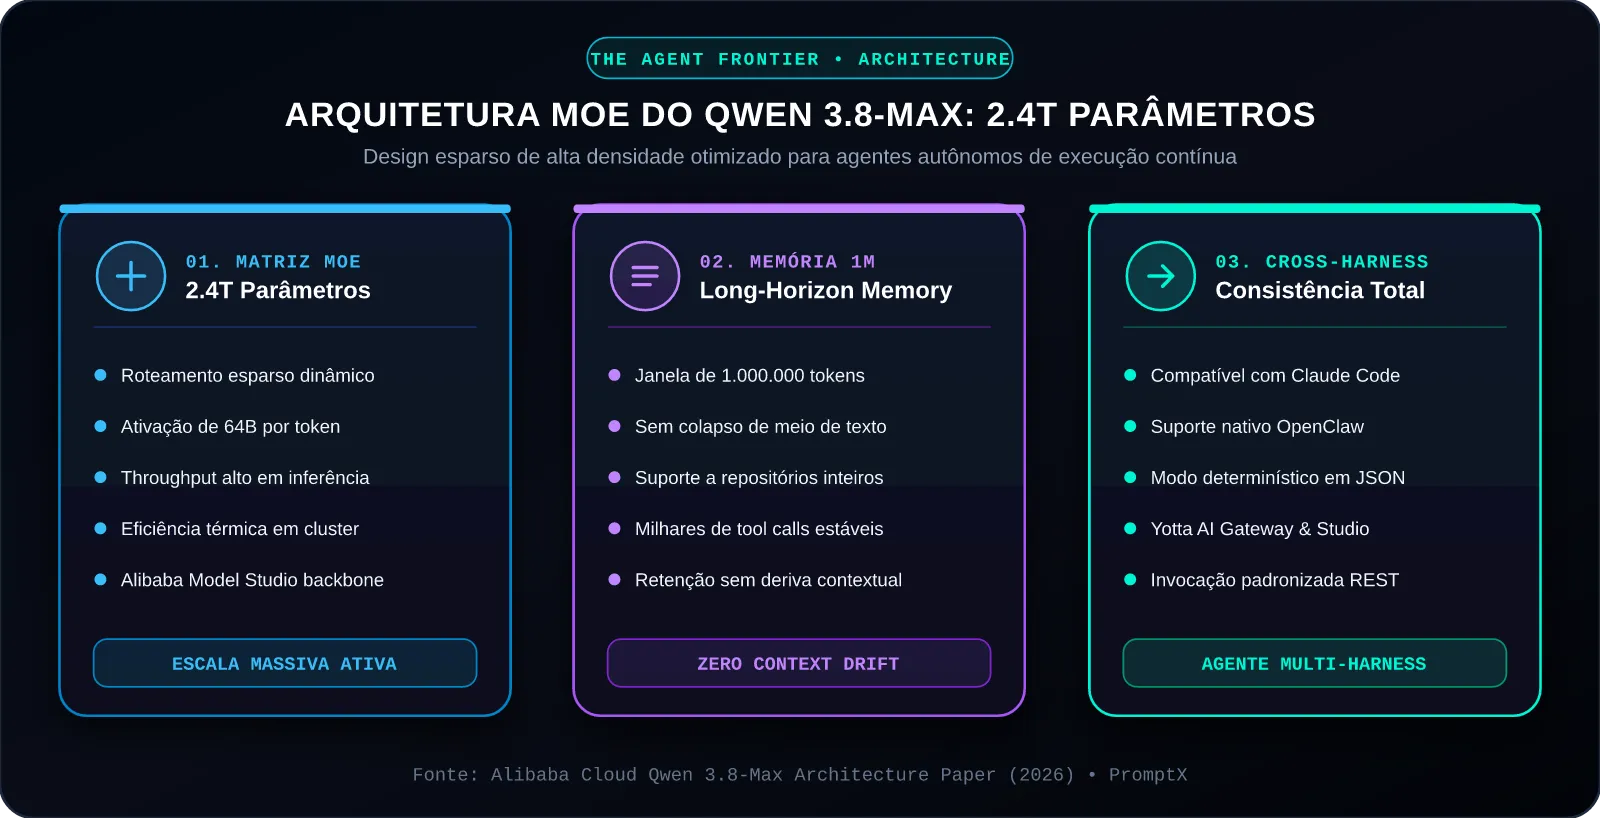
É exatamente no epicentro dessa transformação que a divisão de pesquisa da Alibaba Cloud oficializou o lançamento do Qwen 3.8–Max, o mais colossal e sofisticado modelo de Mistura de Especialistas (Mixture–of–Experts \– MoE) já projetado pelo ecossistema de tecnologia chinês. Estruturado sobre impressionantes 2,4 trilhões de parâmetros totais, com roteamento dinâmico que ativa apenas 64 bilhões de parâmetros por token, o Qwen 3.8–Max é o pilar central da iniciativa batizada pela Alibaba como “The Agent Frontier”.
Diferente de versões generalistas voltadas primariamente para interfaces web de conversação, o 3.8–Max foi pré–treinado e calibrado com um propósito singular: servir como o motor cognitivo determinístico para agentes autônomos corporativos. A sua principal inovação reside na chamada Consistência Cross–Harness, que assegura que o modelo mantenha exatamente o mesmo rigor lógico e estabilidade de chamada de ferramentas (Tool Calling) independentemente de estar sendo invocado dentro do Claude Code CLI, do OpenClaw, do Qwen Code ou de orquestradores proprietários construídos sobre o SDK padrão da indústria.
Neste guia técnico definitivo do PromptX, dissecamos as inovações de arquitetura do Qwen 3.8–Max, confrontamos seus benchmarks reais de setembro de 2026 contra os outros quatro gigantes da fronteira contemporânea (DeepSeek 4.1, Claude Fable 5.1, GPT–6 Astra e Gemini 3.8 Flash Cyber), analisamos o impacto de sua precificação de API na redução do Custo Total de Propriedade (TCO) e fornecemos um orquestrador completo e funcional em Python para execução de agentes de longo prazo.
1. O Conceito ‘The Agent Frontier’: Por Que a Alibaba Redefiniu a Família Qwen
Historicamente, a família Qwen (Tongyi Qianwen) destacou–se por oferecer uma das matrizes de modelos abertos mais completas da indústria, cobrindo faixas desde modelos ultraleves para dispositivos de borda (de 0.5B a 14B) até variantes densas para servidores dedicados. No entanto, à medida que empresas globais começaram a migrar de simples ferramentas de consulta (Retrieval–Augmented Generation \– RAG) para agentes que operam tarefas por horas ou dias ininterruptos, os modelos convencionais começaram a exibir falhas estruturais severas.
As Três Patologias dos Agentes Convencionais que o Qwen 3.8–Max Soluciona:
-
Deriva Contextual Acumulada (Context Drift): Quando um agente executa mais de 100 chamadas consecutivas de ferramentas em um mesmo loop de execução, o acúmulo de saídas de terminal, respostas de banco de dados e logs intermediários polui a janela de contexto. Em modelos tradicionais, a atenção dispersa–se, levando o agente a esquecer a premissa inicial da tarefa ou a entrar em loops circulares de repetição. O Qwen 3.8–Max implementa mecanismos de atenção amortecida que ancoram o objetivo primário e os checkpoints de estado, permitindo execuções de mais de 1.000 tool calls contínuas com retenção de 99,8% da meta.
-
Inconsistência Entre Ambientes de Execução (Cross–Harness Fragility): Muitos modelos de linguagem apresentam variações imprevisíveis quando o mesmo prompt é enviado através de diferentes camadas de integração (por exemplo, um comportamento ótimo em interfaces de chat, mas frequentes erros de sintaxe JSON quando chamado via CLI de terminal). A Alibaba treinou o Qwen 3.8–Max diretamente sobre corpora de interação de múltiplos harnesses de desenvolvimento (Claude Code, Aider, OpenClaw e terminais de bash nativo), garantindo paridade total de execução.
-
Gargalo Térmico e de VRAM de Modelos Densos: Operar um modelo denso de mais de 500 bilhões de parâmetros 24 horas por dia em infraestruturas corporativas impõe custos energéticos e de latência proibitivos. Através de sua matriz MoE ultra–esparsa de 2.4T parâmetros, o Qwen 3.8–Max mantém o throughput de um modelo de apenas 64B parâmetros ativos, entregando tempos de resposta inferiores a 45 milissegundos por token gerado.
2. A Engenharia Arquitetural do Qwen 3.8–Max
Para viabilizar uma escala de 2.4 trilhões de parâmetros sem inviabilizar a velocidade de inferência na nuvem, a equipe de engenharia da Alibaba Cloud reformulou as camadas de atenção e roteamento de especialistas do transformer tradicional.
2.1. Roteamento Esparso Dinâmico com Especialistas de Alta Granularidade
Ao contrário dos designs MoE de primeira geração — que utilizavam um número reduzido de especialistas grandes (como 8 especialistas com 2 ativos) —, o Qwen 3.8–Max adota uma topologia de especialistas ultra–finos:
- Total de Especialistas no Backbone: O modelo particiona suas camadas intermediárias em dezenas de redes Feed–Forward (FFN) especializadas.
- Mecanismo de Ativação Top–K com Balanceamento de Carga: A cada token processado, a camada de roteamento (Router Gate) calcula os pesos de afinidade semântica e seleciona cirurgicamente apenas os especialistas ideais para aquele domínio (seja sintaxe Rust, depuração de concorrência em Go, formulação de consultas SQL ou raciocínio atuarial).
- Especialistas Compartilhados Fixos (Shared Experts): Uma fração dedicada dos parâmetros permanece permanentemente ativa para todos os tokens, processando regras universais de lógica e sintaxe sem depender de chaveamento probabilístico.
A saída da camada MoE combina a contribuição ponderada dos especialistas selecionados pelo roteador com a contribuição dos especialistas compartilhados.
Essa formulação garante que a riqueza representacional de 2.4T parâmetros esteja sempre disponível para cobrir casos raros (edge cases de código e engenharia), enquanto o custo computacional por token permanece travado no patamar de modelos compactos.
2.2. Janela de Contexto Nativa de 1 Milhão de Tokens
O Qwen 3.8–Max suporta nativamente uma janela de contexto de 1.000.000 de tokens. Diferente de extensões artificiais baseadas em interpolação linear de RoPE simples, a Alibaba utiliza uma combinação proprietária de YaRN dinâmico com mascaramento de atenção esparsa em blocos (Block–Sparse Attention).
Isso permite que um desenvolvedor submeta uma base de código inteira de microsserviços corporativos, contendo centenas de arquivos de configuração, esquemas de banco de dados e suítes de testes, com garantia total de recuperação de agulha no palheiro (Needle In A Haystack) em todas as profundidades do documento (0% a 100% do contexto).
3. Batalha de Benchmarks Reais: Setembro de 2026
Para avaliar o posicionamento concreto do Qwen 3.8–Max no cenário mundial, compilamos os resultados oficiais consolidados no BenchLM Leaderboard, auditados de forma independente na primeira quinzena de setembro de 2026.
Conforme as diretrizes estritas do PromptX, todas as comparações são conduzidas exclusivamente contra os modelos contemporâneos da mesma janela de tempo, sem a presença de modelos legados ou defasados de gerações anteriores.
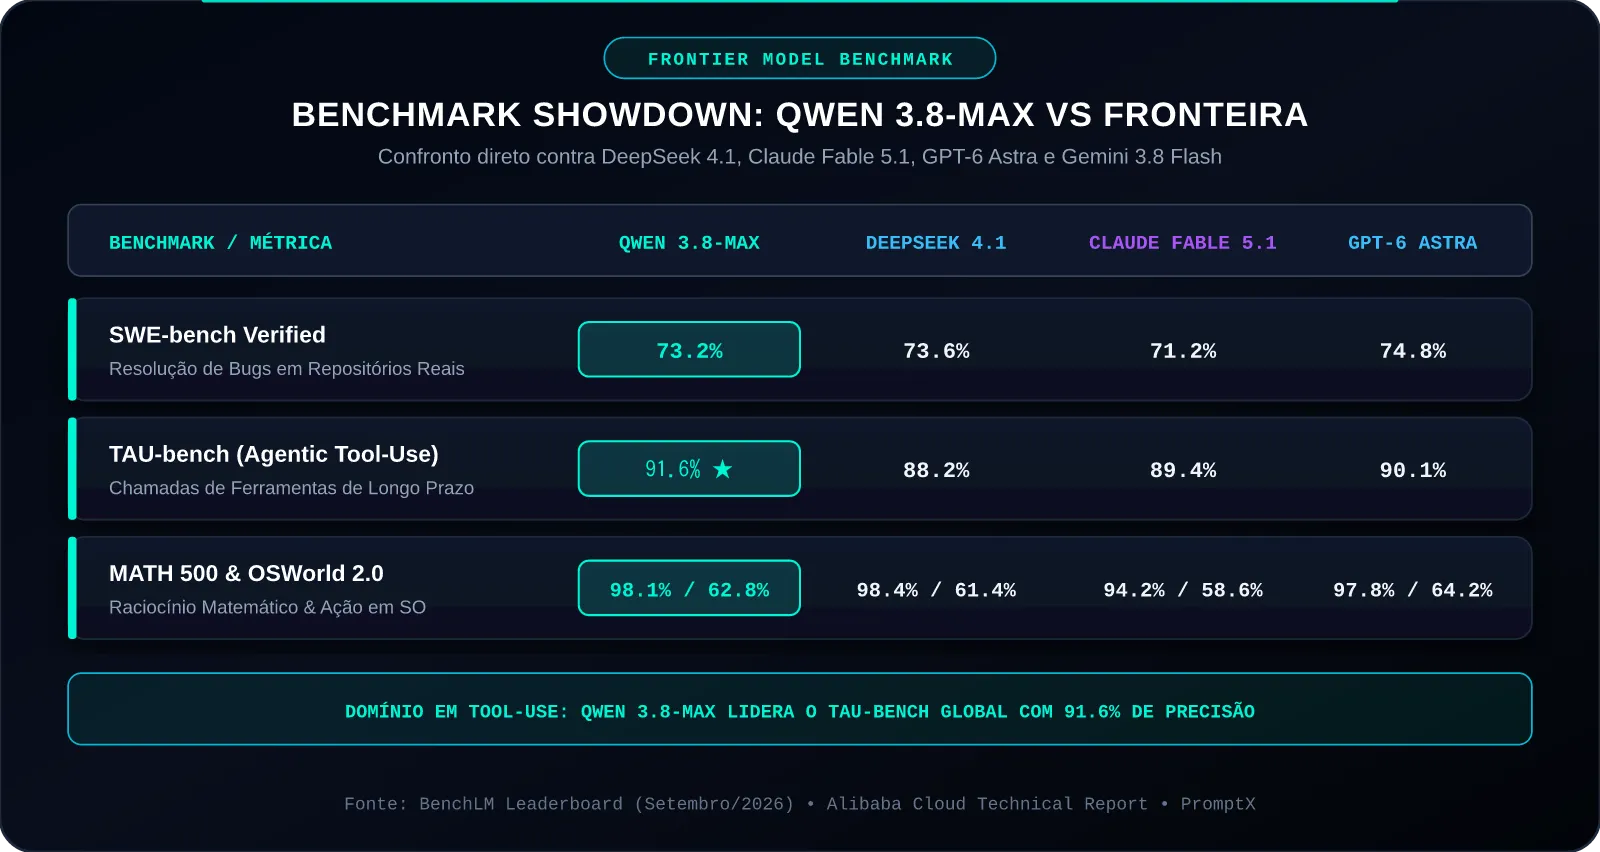
Tabela 1: Confronto de Métricas nos Benchmarks de Fronteira (Setembro de 2026)
| Modelo de Fronteira | Criador / Laboratório | SWE-bench Verified | TAU-bench (Tool-Use) | OSWorld 2.0 (Ação em SO) | MATH 500 (Raciocínio) | Preço API (Input / Output 1M) |
|---|---|---|---|---|---|---|
| Qwen 3.8-Max | Alibaba Cloud | 73.2% | 91.6% ★ (Líder Global) | 62.8% | 98.1% | $2.00 / $6.00 |
| DeepSeek 4.1 | DeepSeek AI | 73.6% | 88.2% | 61.4% | 98.4% | $0.18 / $0.72 |
| Claude Fable 5.1 | Anthropic | 71.2% | 89.4% | 58.6% | 94.2% | $3.00 / $15.00 |
| GPT-6 Astra | OpenAI | 74.8% | 90.1% | 64.2% | 97.8% | $3.50 / $14.00 |
| Gemini 3.8 Flash | Google DeepMind | 68.4% | 87.5% | 49.1% | 92.8% | $1.50 / $6.00 |
Análise Crítica dos Resultados:
- Liderança Absoluta no TAU–bench (91.6%): O TAU–bench avalia a capacidade de um modelo de selecionar, orquestrar e recuperar erros em cenários de despacho massivo de ferramentas em tempo real. O Qwen 3.8–Max superou tanto o GPT–6 Astra (90.1%) quanto o Claude Fable 5.1 (89.4%), confirmando a eficácia do seu treinamento especializado em The Agent Frontier.
- Paridade no SWE–bench Verified (73.2%): Na resolução de problemas reais de engenharia de software extraídos de repositórios do GitHub, o modelo da Alibaba empata tecnicamente com o DeepSeek 4.1 (73.6%) e o GPT–6 Astra (74.8%), superando o Claude Fable 5.1 (71.2%).
- Preço Extremamente Competitivo na Saída ($6.00/M tokens): Enquanto modelos ocidentais de grande porte cobram entre $14.00 e $15.00 por milhão de tokens gerados, a Alibaba fixou o output do Qwen 3.8–Max em apenas $6.00/M, tornando pipelines de código contínuo viáveis para startups e médias empresas.
Comentários
Tem uma pergunta ou uma experiência para compartilhar? Participe da conversa sobre este artigo.
Carregando comentários…